Coding Agent 推理服务,得把整段会话算进去
Modal 对 Kimi K2.6 的服务复盘,让我把注意力放到一整段 Agent 会话:重复上下文如何占用 KV cache,缓存局部性如何影响延迟,负载均衡又如何决定下一轮请求由谁承接。
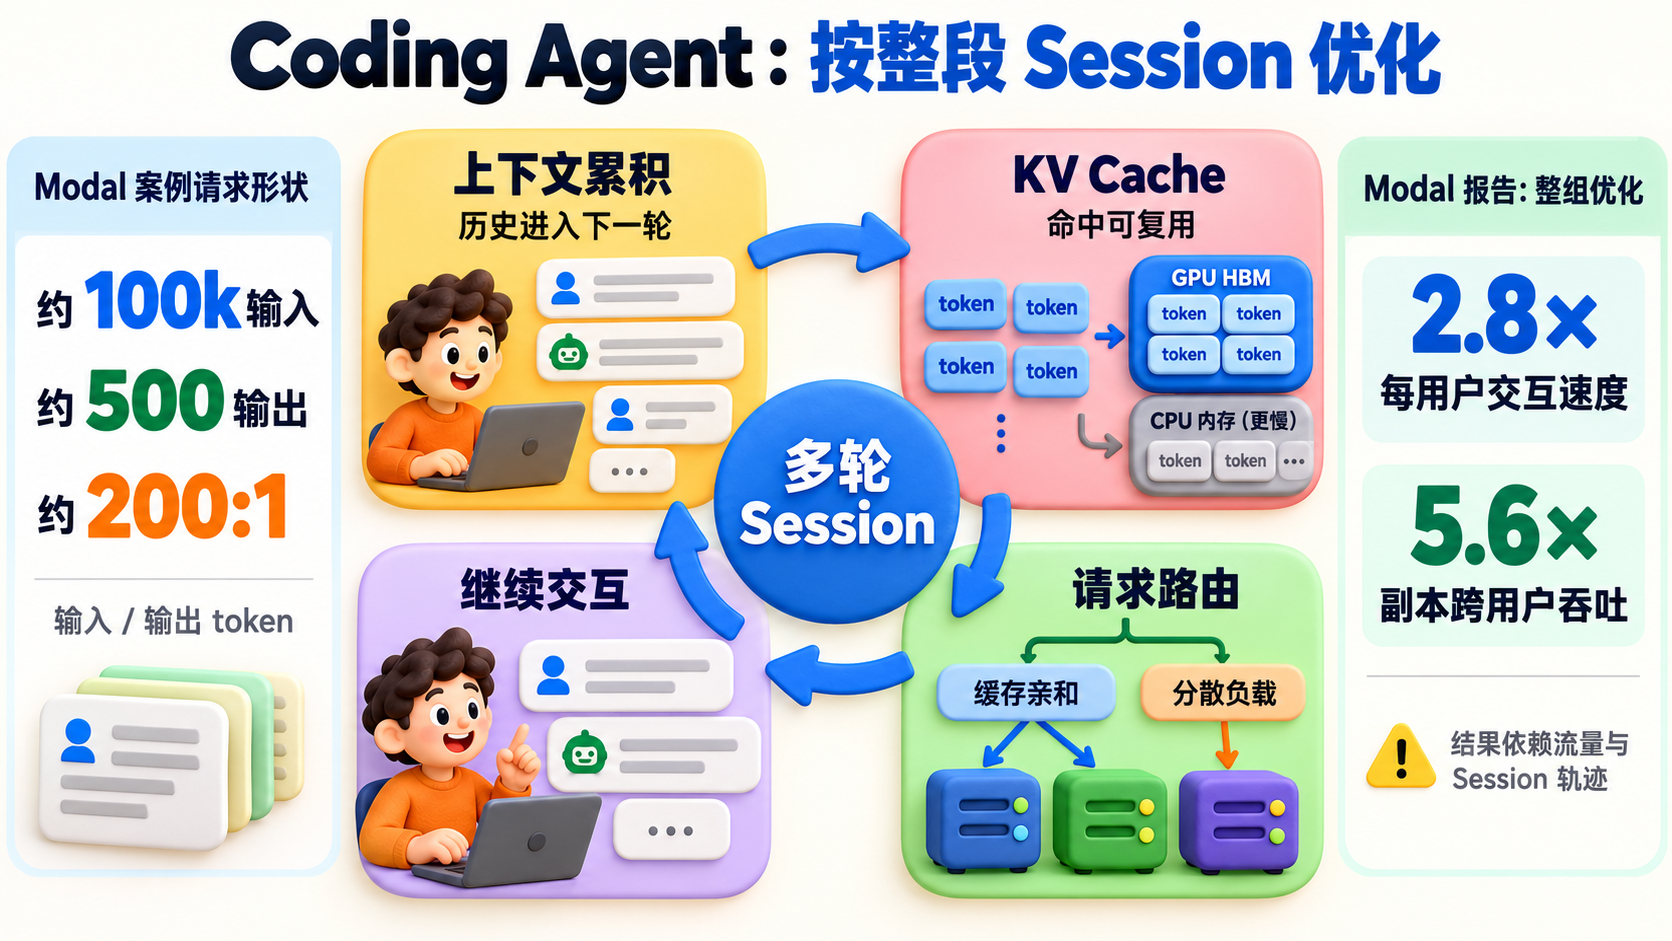
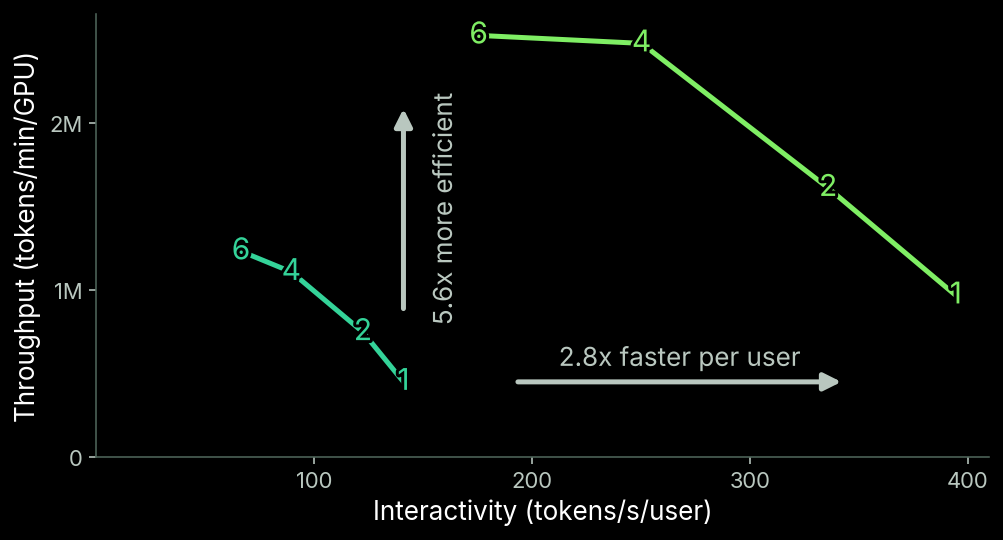
Modal 报告,围绕 Kimi K2.6 做完一组推理优化后,每用户交互速度提升了 2.8 倍,副本跨用户吞吐提升了 5.6 倍。读到最后,我记住的却是另一组数字:一个请求大约带着 10 万输入 token,只生成 500 个输出 token。Coding Agent 的服务端面对的往往不是一次短问答,而是一段还要接着往下走的会话。Modal 原文
先把万亿参数的口径讲清
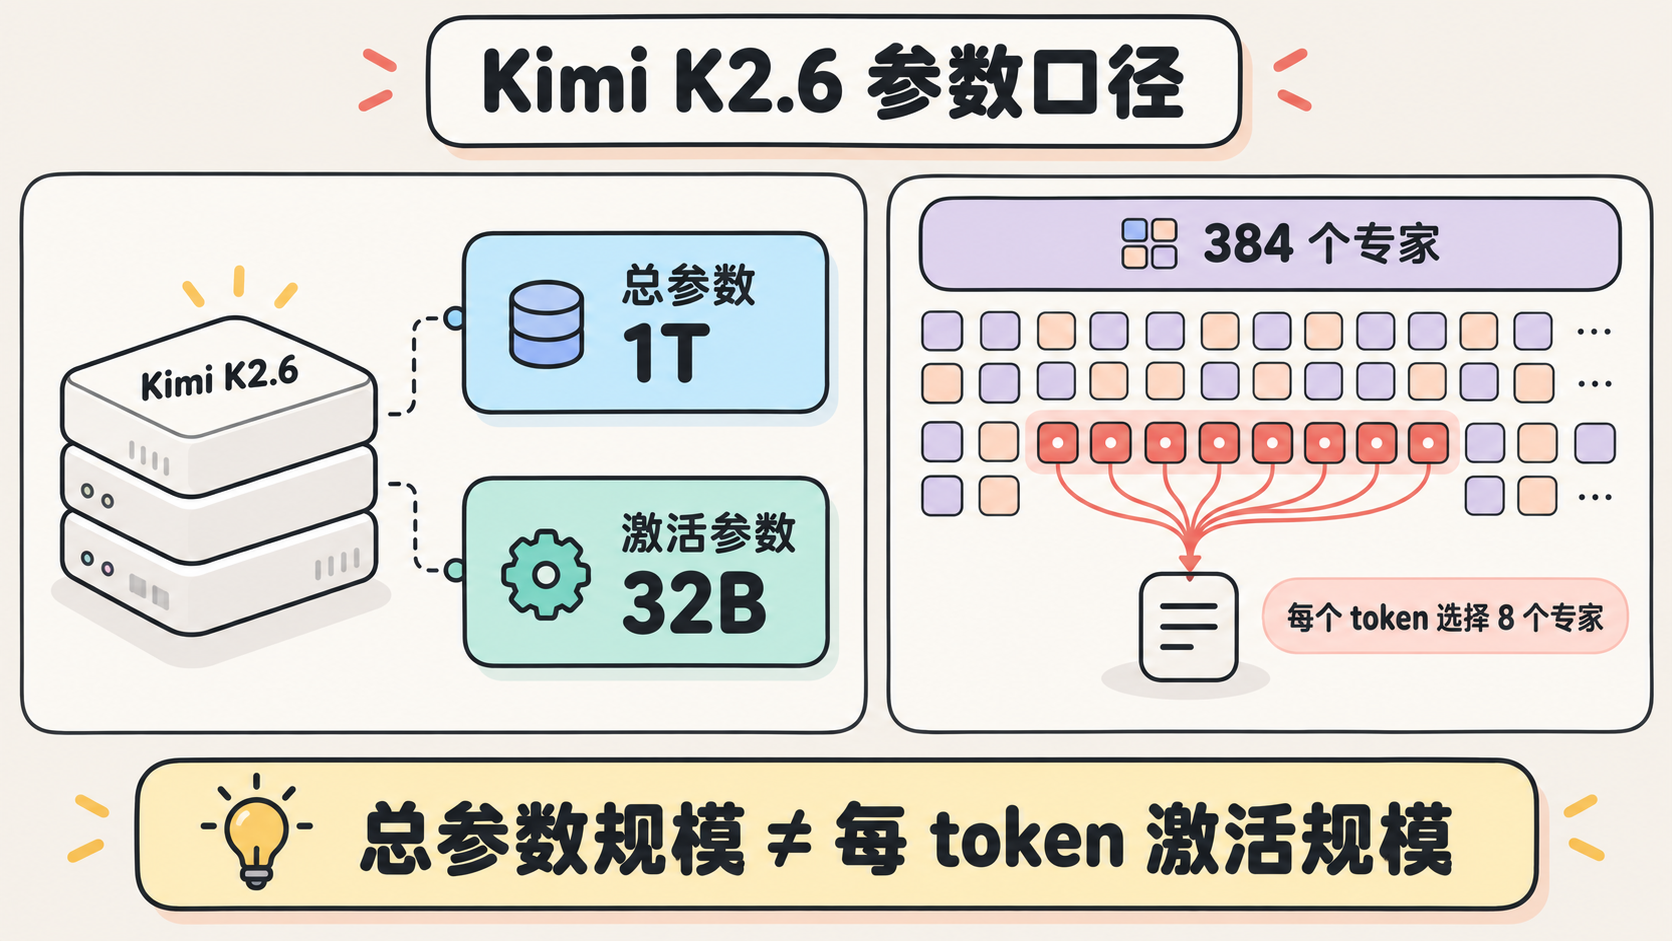
Section titled “先把万亿参数的口径讲清”“万亿参数”很容易让人以为每个 token 都要经过一万亿个参数。Kimi K2.6 的模型卡把总参数列为 1T,激活参数列为 32B;它采用 MoE 架构,有 384 个专家,每个 token 选择 8 个。Moonshot AI 的模型卡 我读到这里停了一下。总参数规模和一次前向过程实际激活的计算规模,应该分开看。
原文大部分篇幅没有停留在“模型太大”这句话上,而是带读者看一段 Agent 对话:用户发来任务,模型读取仓库,调用工具,再把结果带回下一轮。上下文越积越长,原先出现过的 token 又会出现在新的输入里。Modal 用来优化的核心工作负载约为 100k 输入 token、500 输出 token,比例约 200:1。光看 token 数量,输入已经远多于输出;这也解释了为什么 prefill 和上下文缓存会左右整体延迟。
Session 让 KV cache 变成工作状态
Section titled “Session 让 KV cache 变成工作状态”推理服务会把处理过的上下文存在键值缓存(KV cache)里。后续请求复用这部分数据,就不用把相同前缀从头计算。可缓存要占用 GPU 的高带宽显存(HBM);请求增多、历史变长,单张卡能留住的内容就会碰到上限。Modal 的图表显示,负载升高后,缓存命中率下跌,吞吐和交互速度也跟着下滑。

我此前在《Copilot 真正在省的不是 token》里写过产品侧的缓存边界、上下文管理和模型切换。Modal 把同一个问题推到服务端:哪些历史值得留,以及下一轮请求能不能回到持有这段缓存的副本。
单副本的优化也要选目标。Modal 先盯住用户等待时间,再提高每张 GPU 的吞吐。推测解码用一个较小的草稿模型并行猜下一段 token,再交给目标模型验证。缓存空间吃紧时,团队清理多余中间状态、量化部分缓存,也把 CPU 内存作为更慢的扩展层。留更多缓存会增加容量压力,转到较慢的存储层又要付出搬运时间。SGLang 对 HiCache 的说明同样讨论了分层缓存的容量和延迟取舍。DFlash 与 Spec V2 的介绍解释了草稿模型怎样并行提出多个候选 token,再由目标模型验证。它展示的 benchmark 使用另一种模型和工作负载,不能替代 Kimi K2.6 这组数据。
扩容以后,路由也得认识这段记忆
Section titled “扩容以后,路由也得认识这段记忆”把更多副本接进服务后,问题又变了:请求应该落到哪里?每个副本都可能保留着不同 session 的 KV 状态。按 session 固定路由有利于复用缓存;可一个 Agent session 内出现并发请求,或者各 session 的工作量差得很大,固定分配就可能让少数副本过载。若完全随机分配,负载较容易摊开,前缀缓存却可能留在另一台机器上,迫使系统重新 prefill。
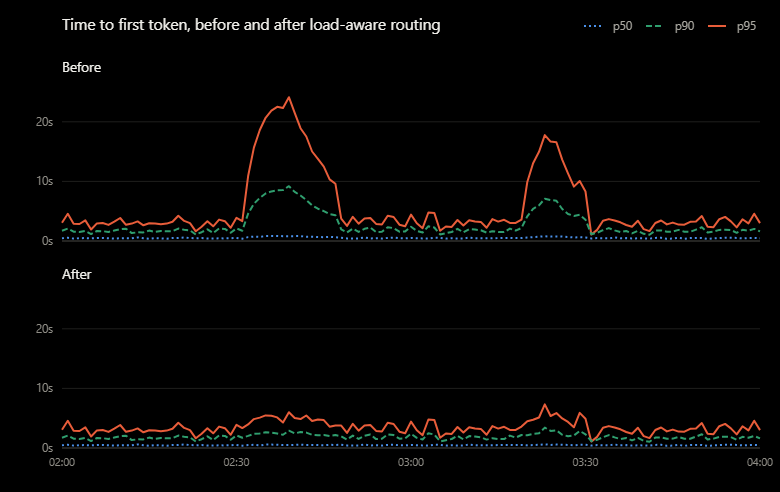
Modal 把正在运行的请求数和 KV 利用率纳入路由。某个 session 并发太高时,请求会被拆到其他副本。路由前后的 TTFT 图里,尾部等待尖峰收敛了;文章还报告,优化后的负载离散度低于 Poisson 模型的预期。这是 Modal 自己的部署结果,却把工程难点画得很清楚:路由既要顾缓存亲和,也得让各副本别过载。
我以前在《AI 的规模之痛:当模型变强时,系统却在偷偷出错》里写过 KV 状态错乱导致输出异常的案例。Modal 讨论的是性能:缓存 miss 可以重新计算,只是会拖慢服务。两个问题不同,但让我想到同一件事:缓存是临时状态,内容也必须可靠。只要请求还在运行,它就会影响模型接下来读到什么。
这组数字的边界,比数字更重要
Section titled “这组数字的边界,比数字更重要”Modal 把 2.8 倍和 5.6 倍放在显眼处,也花篇幅谈测量本身。作者提醒,吞吐、推测解码接受长度和缓存命中率都会随输入数据和会话轨迹改变。请求形状、Kimi K2.6、B200、量化格式和路由策略共同构成这组结果;换一种模型或流量,数字就可能变样。
我读完之后更愿意按整段 session 来看推理服务。Agent 每走一轮,已有上下文、工具结果和新目标又会进来。系统把这段历史存在哪里、下一轮又送到哪台副本,最后会体现在用户的等待时间里,也会体现在服务成本里。以后看到“某模型推理变快”,我会先问那条 session 长什么样,服务把它留在哪一层,下一轮又被送到了哪里。