砍半的部署时间,和没被砍半的 80%
Cresta 用 Conductor 把 agent 开发的后半程做成可重放的评测系统。“部署时间砍半”只覆盖了那 20%,更值得抄的是它如何让模型升级变成一次回归测试。
在 Cresta 的 Conductor 架构图里,Claude Agent SDK 没有被画成主角。它待在右上角 Agent Execution Workspace 的 Runner 框里,旁边还空着一个 Runner 位。
这个细节比标题更早引起我的注意。Anthropic 的客户案例说,Conductor 把初始部署时间砍半;架构图却承认,真正执行任务的 harness 可以换。Cresta 把 SDK 当发动机,自己去做发动机上面的控制面:政策、可观测性、验证和反馈。
再往下读,文章末尾又给出另一个数字:首次构建只占大约 20% 的功夫,剩下的 80% 是测试、优化和持续改进。把这两句话放在一起,砍半的含金量需要重新计算。假设那 80% 没有同步变便宜,20% 砍半,总功夫大约只降到 90%。
这不是说砍半没有价值。更快拿到一个能跑的 agent,能更早暴露需求错误,也能更早让业务方参与。但在 Cresta 自己的叙述里,难的部分不在生成那一端。这篇文章值得读的地方,是它怎么把那 80% 做成一套可重放的工程系统;生成速度只是入口。

那张架构图里,SDK 只是 Runner
Section titled “那张架构图里,SDK 只是 Runner”图里分成两层。上层是 Orchestration Plane:Observability、Governance & Security、Memory、Recursive Improvement、Feedback & Verification、Environment & Deployment。右边是 Agent Execution Workspace:Runner 一栏写着 Claude Agent SDK,下面注明 General harness,再往下是 Isolated Session。底层摆着 Tools(MCP Integration、Cresta CLI、Git & Source Control)、Guidance & Skills(Design Guidance & Templates、Extensible Skills)、External artifacts(SOPs、API Spec、Knowledge Base)和 Working set(Agent Config、Custom Code、Test Cases)。

这张图把分工画得很清楚,只是容易被案例标题遮住。Claude Agent SDK 提供的是 Claude Code 的 agent loop、内置工具、权限、会话、hooks 这些能力,打包成 Python / TypeScript 库。谁都可以把它嵌进自己的产品。Cresta 没有把力气花在重造这个 loop 上;它把对话数据、SOP、知识库、测试用例和业务规则放到 SDK 上面,做成一层控制面。
这和站内之前写过的 Agent Runtime 分层是同一个方向:模型、harness、控制面正在分开计价。OpenAI 的 Decisions API 把运行时拆成几层,Claude Code 也在从聊天框走向可编程的 harness(Claude Code 正在离开聊天框)。Conductor 的特别之处,是它把这套分层放进了一个垂直行业的产品里:底下用通用件,上面卖行业判断。
Cresta 对 SDK 的审查也说明了这一点。文章列出的重点是 data privacy、tenant architecture、organization-level key distribution、controls、observability,而不是模型在 benchmark 上高几分。对一家服务 United Airlines、CVS Health、Marriott 的公司来说,能不能把不同租户的 key 管好、把每次 run 的权限和工具调用记清楚,比多会写几行代码更重要。
难的不是写出第一版,而是决定哪里不能自由发挥
Section titled “难的不是写出第一版,而是决定哪里不能自由发挥”写第一版 prompt 只是开始。更难的问题是:对话里哪些部分应该保持灵活,哪些必须写成明确的业务规则和受控的工具行为。
Renjie Li 把这件事说得很直:
“You don’t want to go too deterministic, otherwise you create a giant decision tree trying to map out every possible branch… but there are enterprise-critical workflows that you need to make sure work all the time, especially for highly regulated industries with low risk tolerance. Conductor helps discover and harden those deterministic requirements and the implementation with the flexibility to improve the overall experience.”
这段话里有一个很实际的取舍。完全灵活,agent 会在关键流程上漂移;完全确定,又会退化成一棵巨大的决策树,最后变成一个碰巧会调用 LLM 的 IVR。Cresta 在另一篇发布文里把这句话说得很直:code 是一等公民,prompt 和 code 各自放在更有效的那一层。
Conductor 没有让用户选一个“自由度”滑块。它从历史对话里找出边界:哪些时刻需要人工介入,哪些环节可以交给模型判断。边界定下来之后,确定性的部分要写成测试;业务规则变了,测试也要跟着改。这里的工作量主要落在维护一张“什么必须每次都对”的清单上,生成只占一小部分。
这张清单听起来像工程琐事,其实是 agent builder 最难产品化的部分。prompt 可以复制,工具可以接,模型可以换;“哪些流程不能出错、出错之后怎么发现”是每家企业的私有知识。Conductor 把这个判断从资深工程师的脑子里挖出来,变成 blueprint 和 test case,才有机会被更多团队复用。站内那篇《代码不再是交付物,而是外骨骼》讲过代码作为 agent harness 的这一层;放到 Conductor 身上,代码不只是外骨骼,也是把业务规则钉住的钉子。

一个 meta-agent 该怎么评分
Section titled “一个 meta-agent 该怎么评分”Conductor 的产物是一个能继续工作的 agent,不是一段回答。这个差别决定了评测方式。回答可以看一遍,agent 要看它怎么建、怎么改、怎么诊断。
Anthropic 的文章给了四个构建任务:新建 agent、写一个测试用例、修改已有 agent、做根因分析。每个任务都不是单轮问答,都会留下工具调用、上下文读取和中间产物。接着是四个维度:Outcome(有没有产出可用的 artifact)、Execution path(有没有用对工具和必要上下文)、Quality(和人工 curated reference 差多远)、Resource use(花了多少时间和 token)。

我先把这张评测维度图看了两遍。它把“答对了没有”拆成了“做成了没有、怎么做的、做得多好、花了多少”。Trajectory 这一项尤其关键:一个 agent 可能碰巧产出了正确的配置,但中间跳过了权限检查,或者读了过时的知识库;只看最终产物,这类问题会被漏掉。Budget 也一样,能跑通但每次要花几十分钟、烧掉大量 token 的方案,在生产里很快会变成成本问题。
这张图也暴露了一个新问题。四个维度里,Outcome、Trajectory、Quality 都写着 LLM as judge,只有 Budget 是纯 deterministic check。评测的质量很大程度上取决于 judge 的质量。Cresta 自己在 Testing 2.0 的文章里承认,未校准的 LLM judge 会让测试“看起来在工作”;他们用 F1 分数校准每个 requirement 的 evaluator,在一个零售客户那里把误报失败率砍掉了一半以上。
这段背景在 Anthropic 的案例里没有展开,但它很重要。一个 meta-agent 的评测,实际上是两层评测:第一层评它造出来的 agent,第二层评“评它造出来的 agent 的那个 judge”。第二层不做,第一层就可能是一场热闹的自我确认。
评测的原料,是另一次运行的遥测
Section titled “评测的原料,是另一次运行的遥测”接下来是这套系统最工程化的一部分,也是我最想抄的部分。
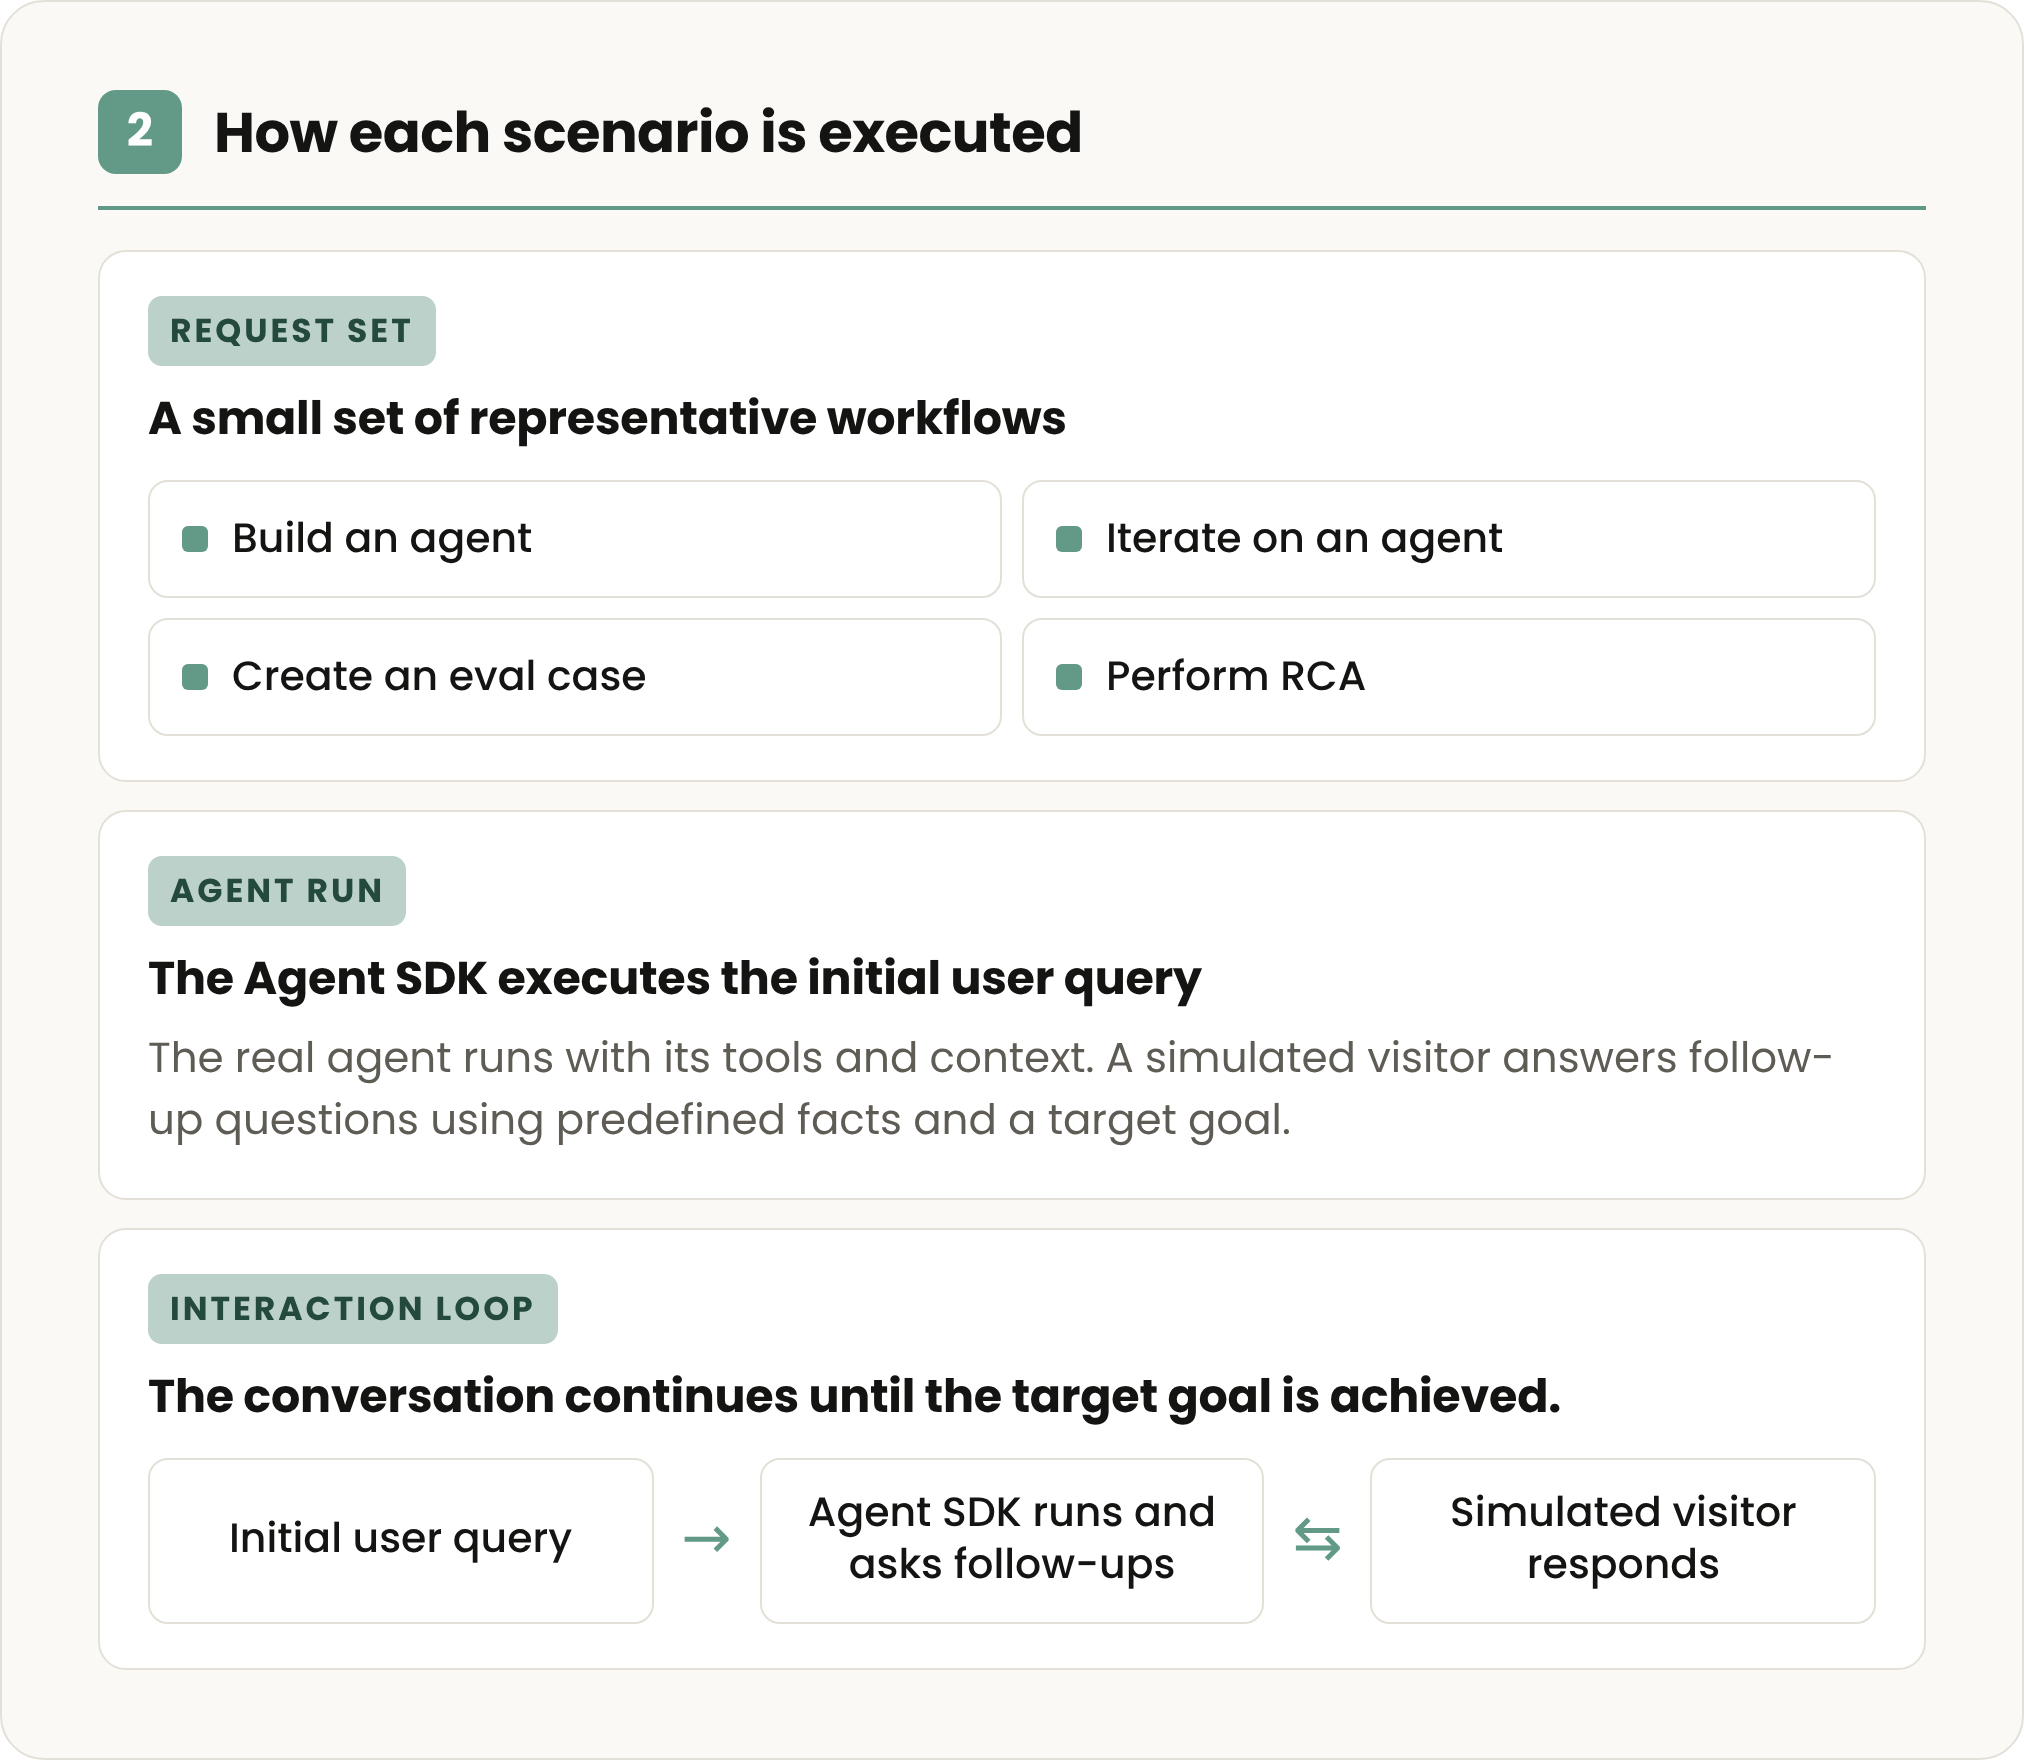
执行图画了一次评测怎么跑:先选一小批代表性 workflow(建 agent、迭代 agent、建评测用例、做 RCA),让真实的 agent 带着自己的工具和上下文跑起来;然后由一个 simulated visitor 用预设的事实和目标,回答 agent 的追问,直到目标达成或失败。这个 loop 不是单轮打分,而是把多轮对话里的工具调用、上下文使用和失败点都留在 run 里。
运行数据图说明这些 run 的数据从哪来:启用 Claude Code 的 telemetry,把导出的 events 和 metrics 送到自己的 collector;用 assistant_response 和 tool_result 事件还原每次 run,再读 token counter 和交互时长,算模型消耗和端到端时间。

Agent SDK 的文档写着,它通过子进程运行 Claude Code CLI,CLI 自带 OpenTelemetry instrumentation:每次模型请求和工具执行都有 span,token 和成本有 counter,prompt 和 tool result 有结构化 log event。SDK 自己不发遥测,它只是把配置传给 CLI。
Conductor 的评测管线没有另外插一层埋点。它借用的是 harness 本来就发出的信号。便利是省了埋点,代价是评测管线绑在了 harness 的观测契约上:遥测导出默认静默失败,collector 挂了,agent 照样跑,评测数据却可能缺一块;换掉 Claude Code CLI,事件名和 schema 也会跟着换。
Simulated visitor 也不是随便捏一个假用户。Cresta 的生产级 agent 文章说,一个 simulated visitor 是一份紧凑的 spec:persona、目标、world state(认证、权限、订单状态、缺失数据)和行为策略;它由去标识化的真实对话生成。这样跑出来的多轮对话,才会带上真实用户的省略、追问和情绪,而不是一条理想路径。
这套东西拼起来,评测的对象也就从“答案”转向了“一次完整的运行”。这也解释了为什么四个维度里要有 trajectory 和 budget:它们把 run 和 answer 区分开,并不只是附加项。
模型升级,才是这套系统的压力测试
Section titled “模型升级,才是这套系统的压力测试”文章里有一句话,很容易被 headline 盖过去:新模型发布或 Conductor 框架更新时,Cresta 会用同一批任务和同一套评分重跑,看看哪些变好了,哪些还需要修,然后才决定要不要采用这次变化。
大多数团队把模型升级当成一次迁移:改 prompt、调工具、重新测几个例子,觉得差不多就上线。Cresta 把它当成一次回归测试。两者的差别在于,前者依赖人的记忆,后者依赖一套可重复的基线。模型升级越频繁,这套基线的价值越高。
回到开头那两个数字。砍半的是初始部署时间,也就是 20% 那一段;最后决定 agent 能不能在生产里活下来的,是模型换代、政策变化、对话分布漂移之后,那 80% 的迭代成本。Cresta 的评测管线和 memory artifact 做的,就是把这部分成本从“每次重新想一遍”,改成“每次重跑一遍”。
Memory artifact 值得单独看一眼。团队把一次构建里学到的 pattern、业务规则、评测方法沉淀下来,作为 skill 分享给其他人;下一个人可以从一套经过验证的做法开始,不必从空白 prompt 重新摸索。这个 flywheel 听起来很顺,但它有一个治理前提:分享出去的 skill 必须有人负责版本、审批和回滚,否则错误的做法也会被复制。
Cresta 在 Testing 2.0 里给需求分了 must-have 和 nice-to-have,也给 evaluator 做了 F1 校准;这些机制如果能同样用在 memory artifact 上,flywheel 才不会变成传声筒。Anthropic 的案例没有讲这一层,但它是这套系统能不能长期成立的关键。
这套方法能抄走什么,抄不走什么
Section titled “这套方法能抄走什么,抄不走什么”如果把 Cresta 的做法压缩成几条可以带走的工程习惯,我会留下这些:
- 评 run,不只评 answer。Outcome 之外,还要看 trajectory 和 budget;否则“碰巧做对”会被当成“会做”。
- 把“必须每次都对”的流程写成 deterministic check,其余留给模型。确定性的边界要跟测试一起版本化,不能只写在 prompt 里。
- 模型升级用同一批任务和同一套评分重跑。回归基线比一次性的 benchmark 更能说明问题。
- 让 telemetry 成为 harness 的默认产物,评测时不用临时加埋点。评测资产要能导出、能带走。
抄不走的部分也要说清楚。部署时间砍半是 Cresta 自报的早期用例结果,“初始部署时间”没有定义,样本量也没有披露;20/80 是经验法则,不是同一项目的实测分母。这套方法最适合有海量历史对话、强合规、高客单的 CX 场景;没有数据积累、低频低风险的产品,评测集的成本可能高过收益。LLM judge 不校准,评测就会变成表演;builder 越深入,memory artifact 和 eval suite 越像护城河,也越像锁定。
所以,面对一个 agent builder,我会先问四个问题:
- 它能不能评估一次 run 的 trajectory 和 budget,而不只是最终回答?
- 模型升级时,能不能用同一批任务和评分重跑?
- judge 怎么校准?有没有人工标注、F1、must-have 分级?
- 我的评测资产、memory artifact 和遥测数据,能不能导出、能不能带走?
这四个问题答不上来,生成速度再快,也只是把项目更快地送到最难的部分。
Cresta 的案例最有价值的地方,不是它证明 agent 能造 agent。它把“造完之后怎么办”摆到了台面上:一个 agent builder 的产品力,最后落在它接管迭代的方式上。只把生成速度当卖点,Conductor 的故事会被读成又一个“自然语言造 agent”的 demo;把评测图和 20/80 放在一起看,它更像一份关于“agent 上线之后”的工程说明书。
- How Cresta turned CX expertise into an agent builder on the Claude Agent SDK,Anthropic,2026-10-05。
- Cresta Conductor: The Agent for AI Agent Development,Renjie Li,2026-06-11。
- Introducing AI Agent Testing 2.0: Confidence at Launch, Confidence at Scale,Ping Wu,2026-06-04。
- Building and Deploying Production-Grade AI Agents: Cresta’s End-to-End Approach,Cresta,2025-11-25。
- Agent SDK overview,Claude Code Docs。
- Observability with OpenTelemetry,Claude Code Docs。