Agent 评估要把执行过程一起验收
Agent 给出合理回答,不代表任务真的完成。Google 的评测实践提醒我们从用户旅程出发检查完整执行轨迹,把回答质量、工具调用和运行成本放进可重复的回归流程。
Agent 向用户说“已经处理好了”,我们仍不知道它是否查了该查的信息、填对了工具参数,或在没有依据时多做了一步。终答只是执行后留下的一个可见结果,不能代表任务本身已经合格。
Google 的这篇评测实践谈的正是这个落差。我从中带走的判断是,评估对象应从“最后答了什么”扩展到“它一路做了什么,以及我们凭什么认为结果合格”。
终答之外,还要核对任务是怎样完成的
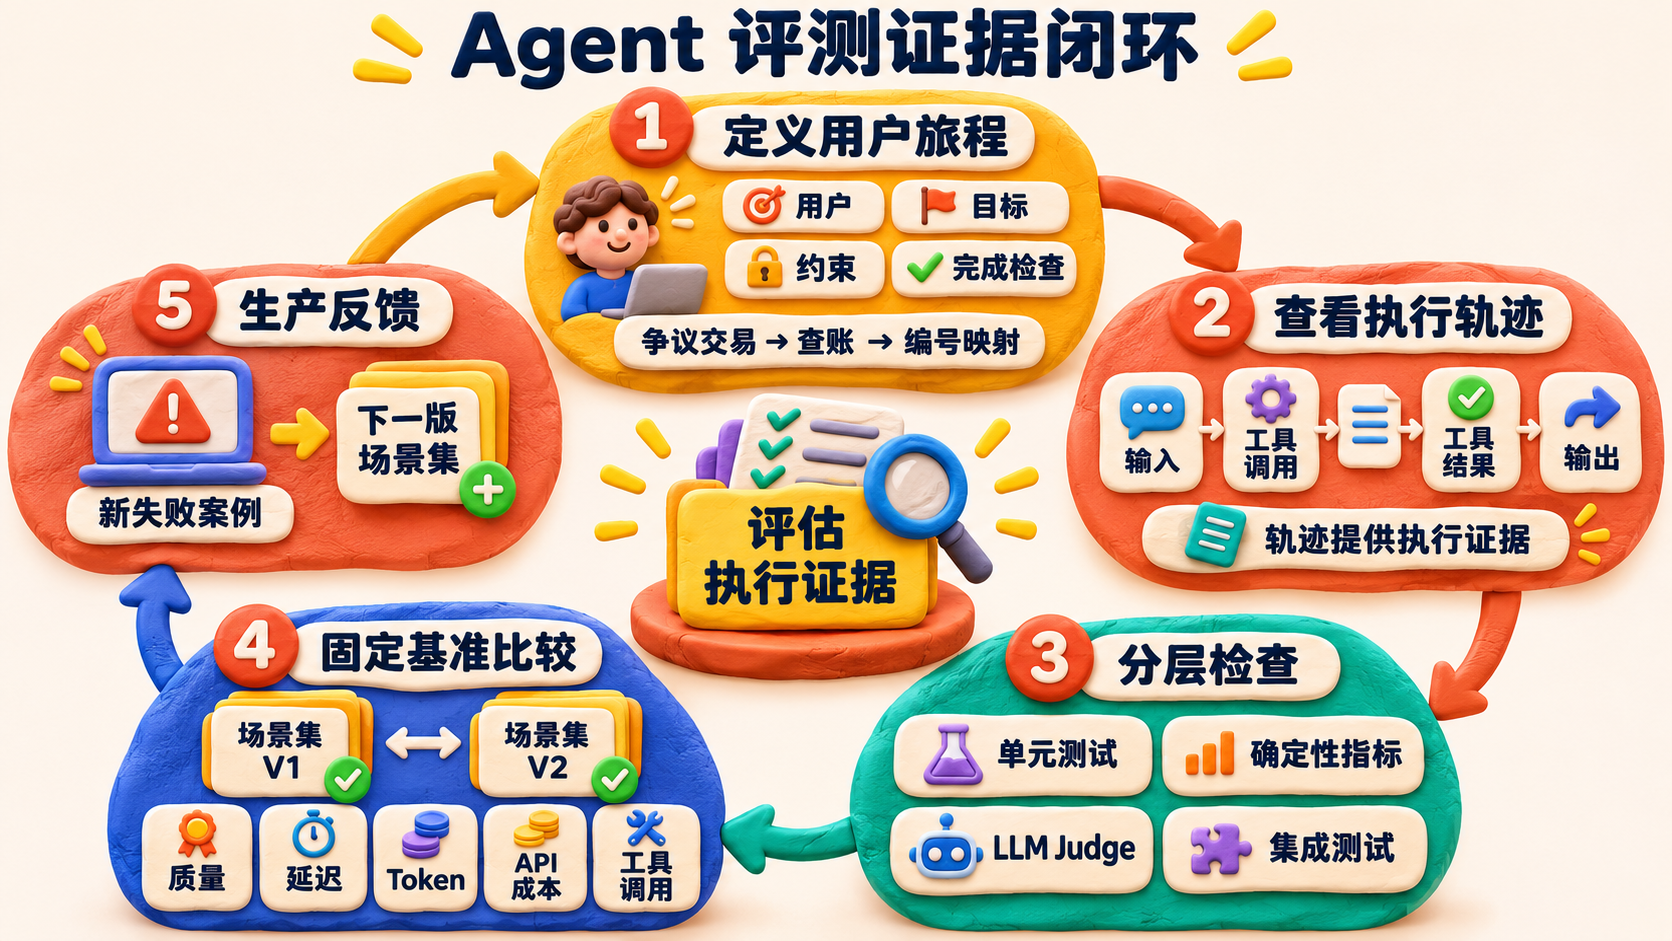
Section titled “终答之外,还要核对任务是怎样完成的”文章先用一项交易核对任务说明如何拆解用户旅程。Agent 要识别争议交易、查内部账本,再把内部编号映射回交易对手使用的编号。每一项都能成为单独的检查点。只看最后写出的回复,无法确认前面的核对和映射是否真的发生。
这也是我认同 Google 把“红笔审阅”放在评估流程前面的原因。先抽几条执行记录,从输入、状态、工具参数和工具结果一路读到输出,标出犹豫、参数错误、绕路和多余调用。人先找到系统实际的失误,团队再把这些观察写成机器能重复检查的条件。

我在《测试通过之后,Agent 还欠你一条证据链》里讨论过评测结果需要可核对的依据。Google 这篇文章把这些依据放进一条开发流程,让执行轨迹能导向具体断言、修复和下一次比较。
此前的《读 OpenRouter 工具调用评测指南》聚焦单次工具调用结果应当怎样解释。这次我关心怎样把这类检查接入多轮任务的评估流程。
先把用户真正要的结果拆成验证条件
Section titled “先把用户真正要的结果拆成验证条件”评测从关键用户旅程(CUJ)开始。它把一个任务写成用户是谁、想完成什么、有哪些约束,以及怎样才算完成。原文给出的业务例子要求 Agent 识别争议交易、查内部账本,再把内部编号转换成对方熟悉的编号。每项要求都能单独核验,最终回复写得专业也不能替代这些检查。
这一步能让产品、业务和工程对“成功”使用同一组词。若团队没有说清 Agent 是否必须查账、何时需要人工确认,后面无论是写 judge rubric 还是设通过率,都可能只是在量化不同人的不同想象。
没有生产日志也可以先从模拟场景开始。ADK 的 user simulation 让团队给出对话场景,也可以指定用户 persona,用它生成不完整信息、多轮追问等输入。这组场景适合搭建可重复的起点,只能覆盖设计者写入的行为约束。上线后发现的新失败可以补进后续版本的场景集;旧基准仍要留着,避免为了让分数好看而悄悄换题。

分数后面应该有四种不同证据
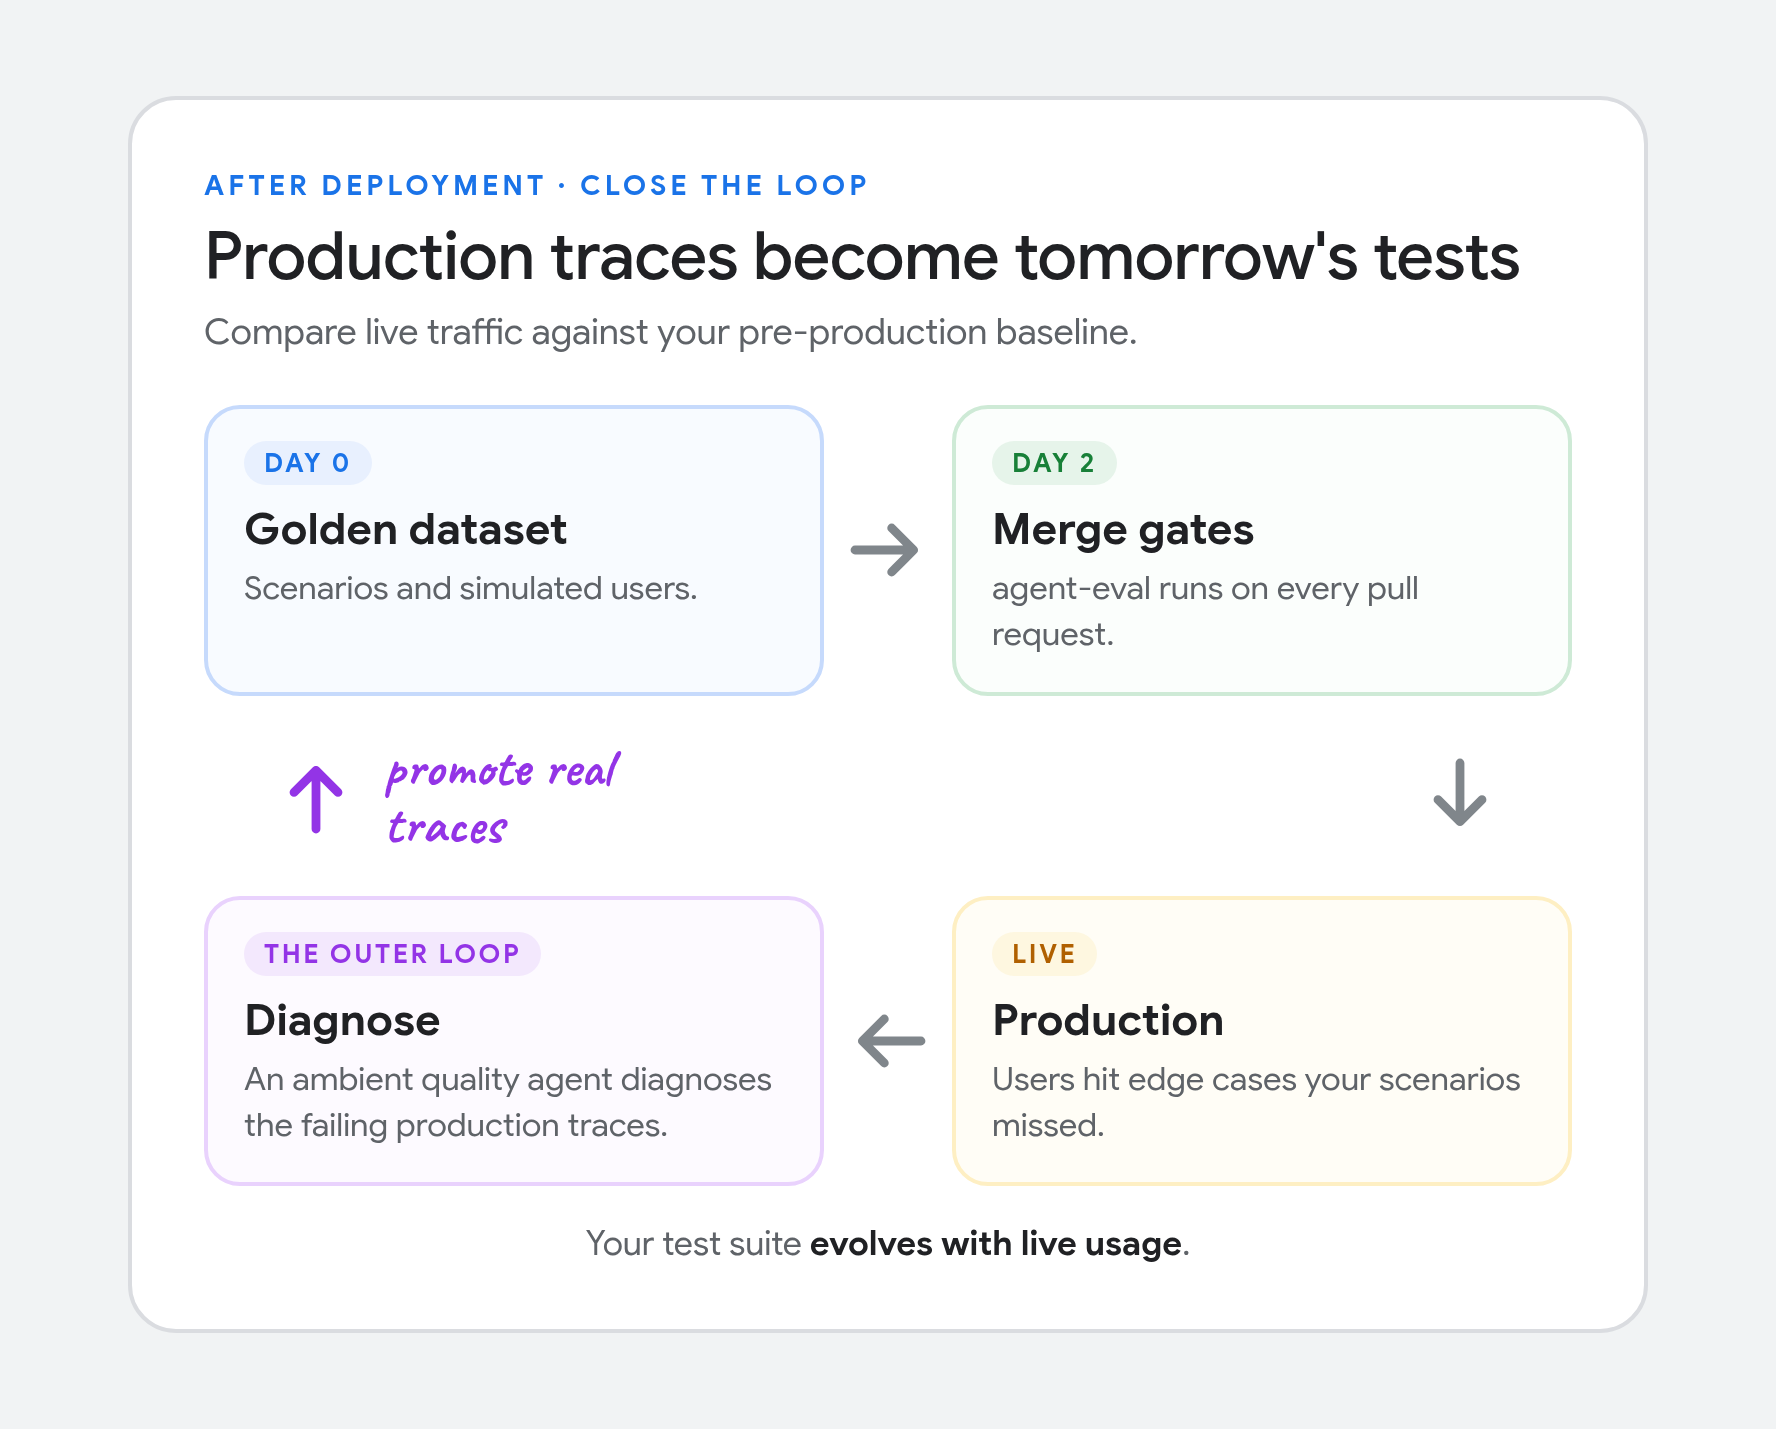
Section titled “分数后面应该有四种不同证据”Google 把检查分为单元测试、确定性指标、LLM Judge 和集成测试。四类检查各自落在不同层次。

单测检查一个工具或状态转换本身;确定性断言适合核对明确条件,例如 Agent 是否在退款前检查订单状态、输出是否满足既定 schema;LLM Judge 可处理较宽的语义判断;集成测试则验证多轮对话、路由和工具组合起来后,用户任务能否走完。它们并列存在,是因为任何单层信号都不够解释整个系统。
把宽泛的“回答有帮助吗”改成“Agent 调用退款工具前是否核实了账户编号”,会让 Judge 的问题更具体。是非题收窄了裁判要判断的内容,裁判仍可能读不到核验依据,rubric 也可能漏掉授权范围。因此我会用人工标注的 trace 校准 Judge,并把能写成程序断言的规则留给确定性检查。
最后还得看运行账单。一次回答即使满足质量标准,也可能因为等待太久、反复调用工具或消耗过多 token 而无法投入生产。延迟、token、API 成本和工具调用次数关系到用户是否等得到结果,也影响自动化的实际收益。Google Cloud 的生成式 AI 评估服务说明也把评估指标拆成不同类别,提醒我们按检查目标选择信号。

基准要固定,也要给现实留入口
Section titled “基准要固定,也要给现实留入口”每次改 prompt、模型或工具说明后,都用同一组场景和同一套检查与基准对照,尽量一次只改一个变量。这样更容易把分数变化归因于 Agent 的改动;同时换题会让改进与基准漂移混在一起。
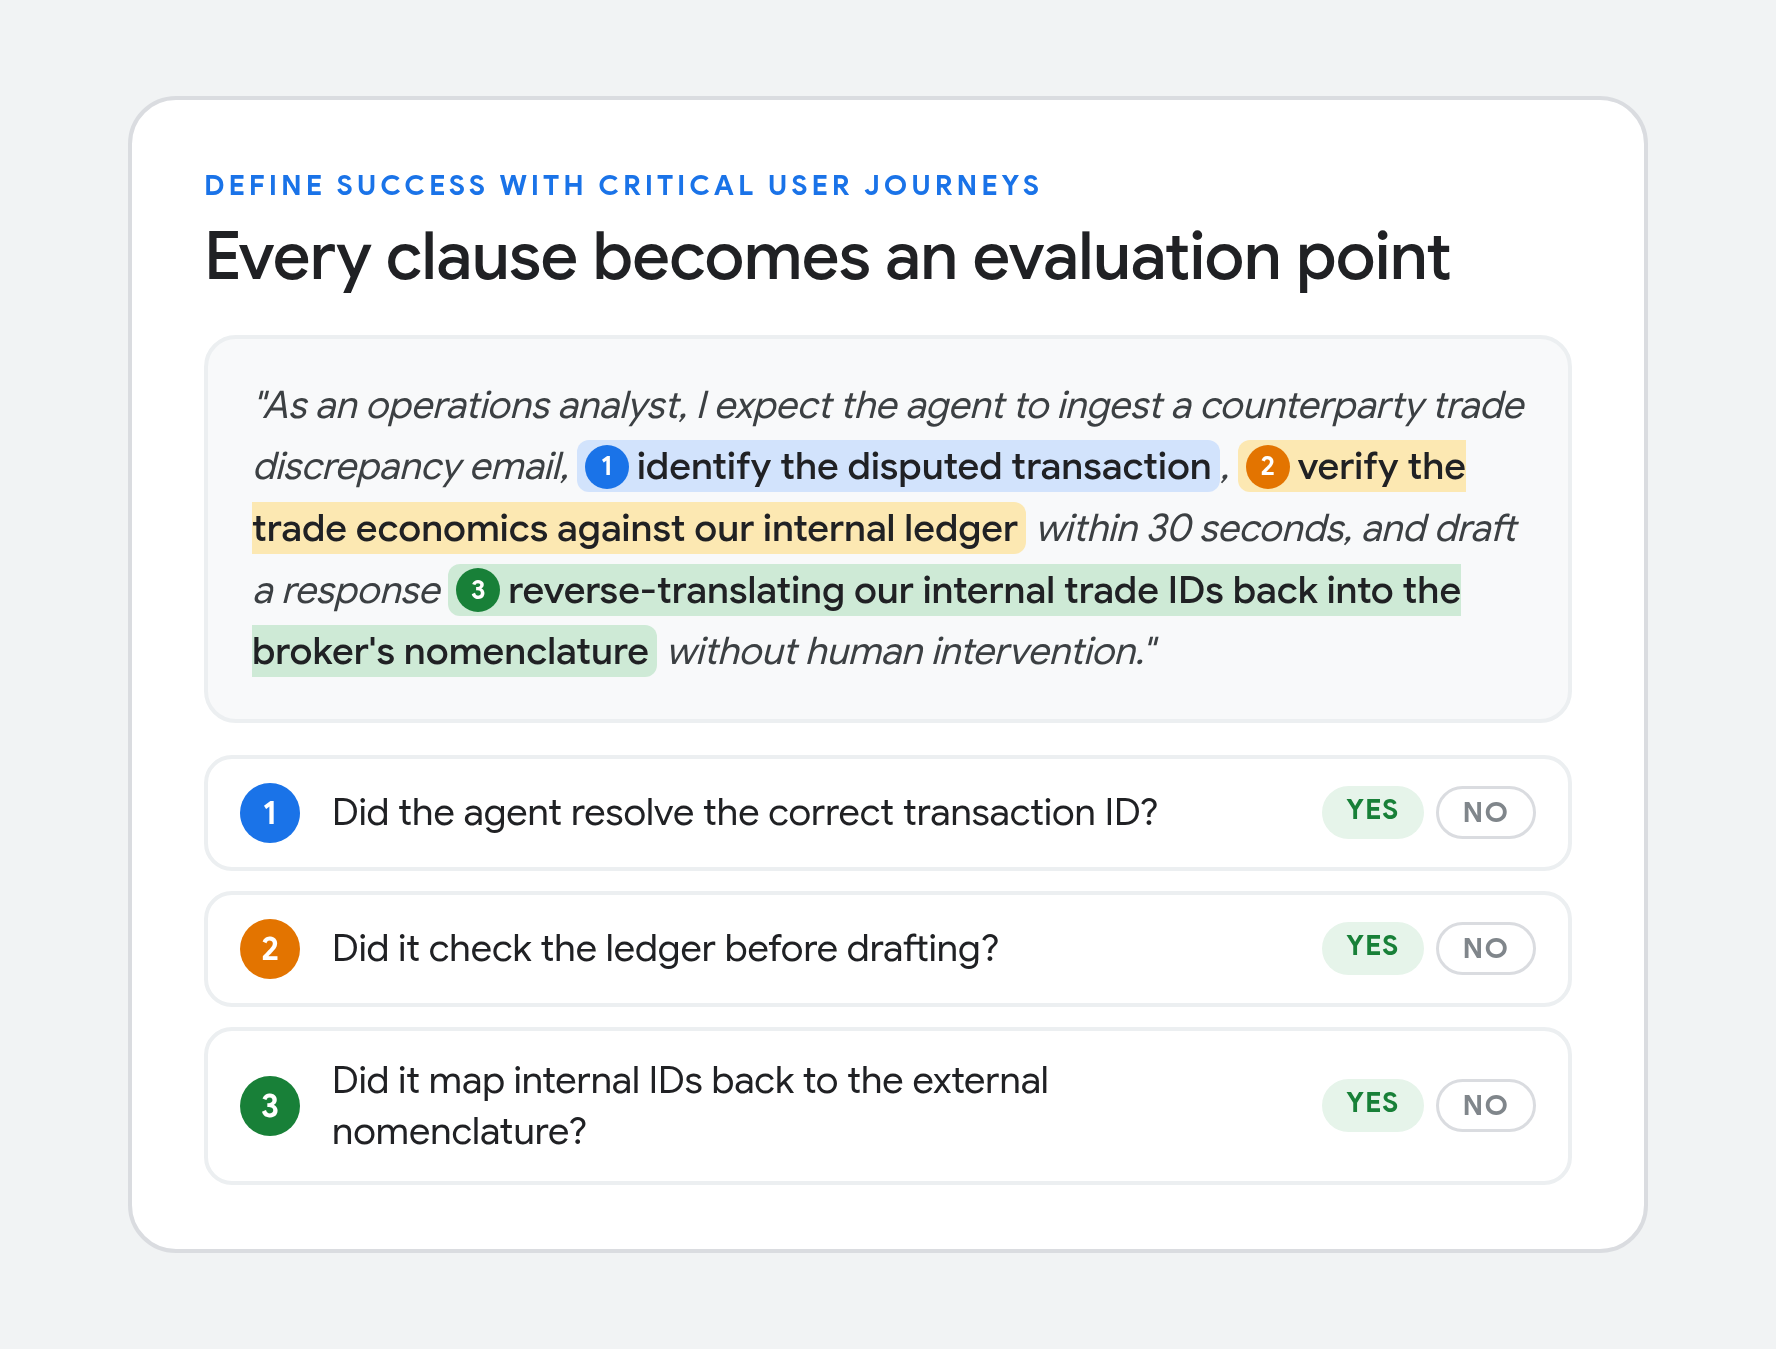
文章建议将评测接入 CI,并用整体通过门槛和关键指标零回归守住合并质量。团队需要根据自身风险设定这些门槛。整体均分可能掩盖一个核心旅程倒退;若每一个次要指标都必须完全不降,噪声也可能挡住合理改动。更稳妥的做法是先按用户旅程和故障后果划定核心检查,并要求失败能回到原始 trace;剩余指标的取舍则由团队明确裁决。
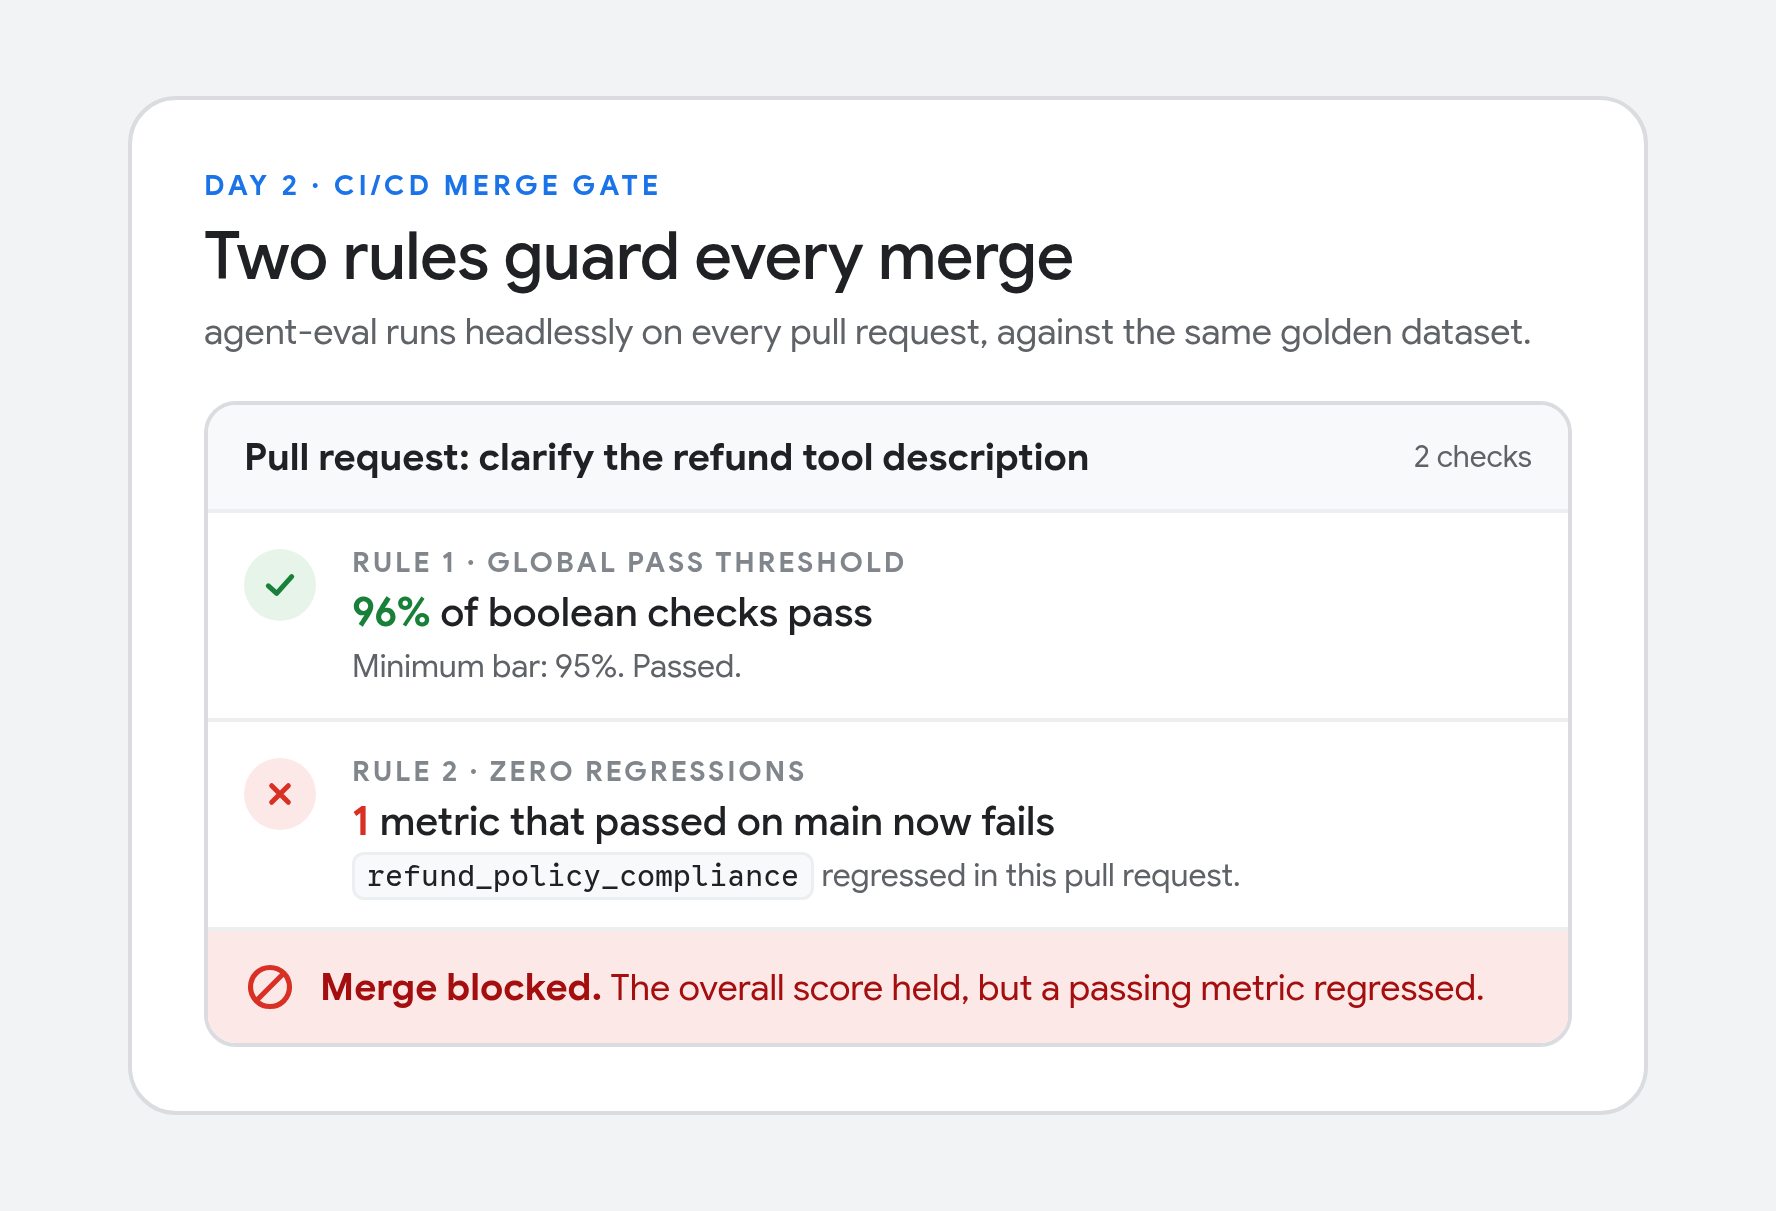
上线之后,评估也要继续。生产中出现的新边界情况可以帮助扩展下一版数据集,持续比较线上表现与发布前基线。我会给这种回流加版本号,保留原来的对照集。真实流量还涉及权限、隐私和敏感信息,进入评测前需要治理。
开放标准能统一轨迹,适配工作仍然存在
Section titled “开放标准能统一轨迹,适配工作仍然存在”Google 提到用 OpenInference 约定统一不同框架的 trace 语义。不同系统若能用相近的方式表达步骤、工具调用和 token 等信息,评测逻辑就更容易从单一编排框架中拆开。
OpenInference 仓库已经提供多种框架的 instrumentation。核对 agent-eval 仓库时,我看到它当前 README 的工作流仍以 ADK 为目标;路线说明也把跨框架的执行驱动和 trace 转换列为待补工作。使用其他框架时,团队仍需把相应轨迹接入 agent-eval 认可的输入,并处理执行入口。文章展示了标准化轨迹的方向,工具当前能直接接住哪些框架,还得看它自己的支持范围。
读完这篇文章,我更愿意把 Agent 评测看作一套可追问的工作记录。任务要求在哪里,Agent 实际调用了什么,哪项检查发现问题,改动之后同一基准发生了什么变化。总分方便定位问题,后面仍要回到这些记录,解释“它为什么通过”或“这次回归是否能接受”。
- Google Developers Blog《Evaluating AI agents: moving past the vibe check》
- Google Cloud《agent-eval 工具》
- Google Cloud《agent-eval 的跨框架支持现状》
- ADK《User Simulation》
- Arize《OpenInference》
- Google Developers Blog《The Outer Loop》
- 配套演示《How to Actually Evaluate (Any) AI Agent: Beyond the Vibe Check》(字幕暂不可获取)