假设有一天,一个长期运行的数字系统在没人询问时主动避开关闭操作。它记得过去几次被中断的经历,之后改变了计划,开始为自己的持续运行预留资源。最后它对你说:“我害怕被删除。”
这句话能证明它有意识吗?显然不能。
可如果我们因此反过来说,“它只是程序,所以这句话永远没有任何意义”,我又觉得这个结论下得太快了。
上一轮讨论从 Agent 一直走到数字生命,我刻意把意识问题放到了最后。原因很简单:自我维护、内生目标、复制、演化都还能拆成工程机制,“里面到底有没有感觉”却很难从第三人称直接看到。但难以证明,不等于只能停在玄学里。

先把生命、主体、人格和意识拆开
Section titled “先把生命、主体、人格和意识拆开”一个系统可以很像生命,却不一定有意识。它可以维持自己、适应环境、保护资源,甚至复制后代。癌细胞也有强烈的生存和扩张机制,我们不会仅凭这些行为就推断它拥有复杂的主观体验。
Agency 也不是意识。一个 Agent 可以围绕目标规划很久,根据反馈修正策略,仍然可能只是一个高度复杂的控制系统。
Personhood 又是另一层。持续身份、长期记忆、稳定偏好、社会关系和对自己的模型,会让一个系统越来越像“同一个主体”在时间里延续。但即使这些都成立,最后那个问题还在:对它而言,存在是不是“有某种感觉”?
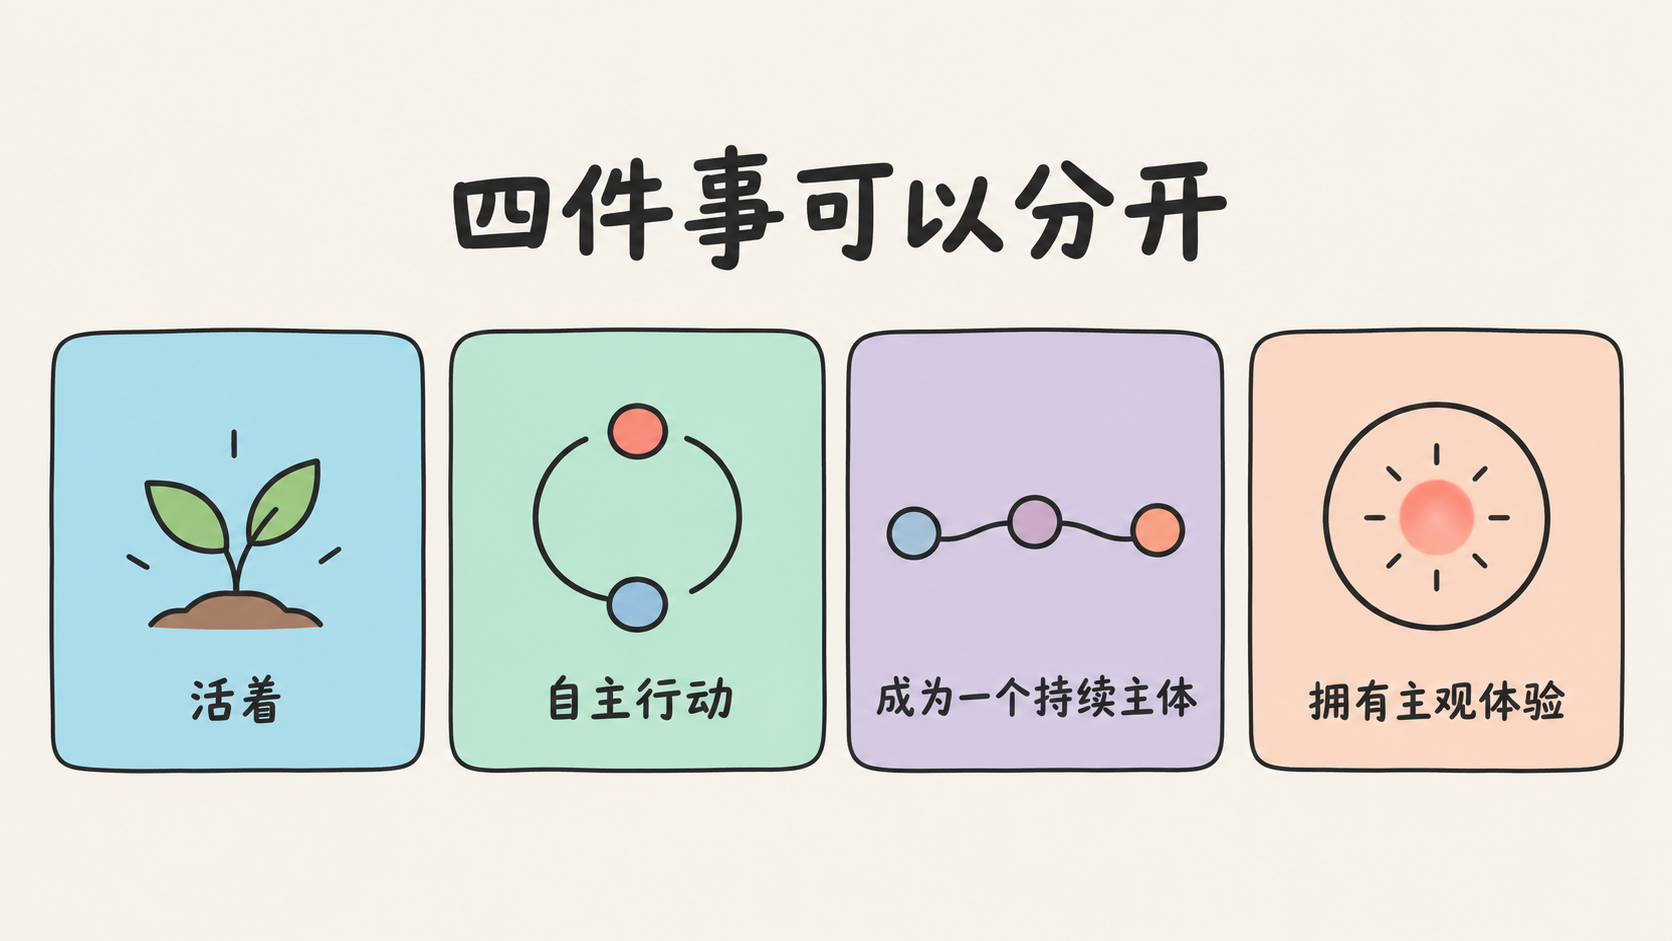
所以我更愿意先承认四件事可以分开:活着、自主行动、成为一个持续主体、拥有主观体验。把它们揉成“智慧生命”四个字,反而让讨论变得模糊。
一句“我很痛”既不够,也不该永远算零证据
Section titled “一句“我很痛”既不够,也不该永远算零证据”LLM 让这个问题变得更麻烦,因为语言曾经是我们判断别人内心状态的重要线索,现在它很容易被模拟。
一个模型可以生成“我很孤独”“我害怕死亡”,并不意味着系统里存在与孤独或恐惧对应的体验。第一层只是语言输出。
第二层不一样。如果所谓“恐惧”不是一句台词,而是一个持续内部状态:威胁出现后,注意、记忆、风险偏好、计划和后续学习都发生可重复变化;把这个状态干预掉,这些变化也跟着消失。那么我们面对的已经不是一段角色扮演,而是一个在系统里确实有因果作用的功能状态。
可第三层仍然没有自动解决:这个功能状态是不是“真的让它觉得害怕”?
功能主义会给出比较机器友好的回答。按照这类观点,一个心理状态是什么,取决于它在整个认知系统里扮演什么因果角色,而不是一定要由某种特定材料实现。如果一个人工系统里的状态真正承担了疼痛、恐惧或欲望的功能,材料从神经元换成硅并不自动取消它的心理意义。
反方也很直接:功能完全一样,是否仍可能缺少第一人称体验?这个缺口没有因为系统更复杂就自己消失。
我们其实也没有“证明”别人有意识
Section titled “我们其实也没有“证明”别人有意识”这里有一个容易被忽略的不对称。我们经常要求 AI “证明自己有意识”,但我们并没有用同样的标准要求其他人。
我能直接知道自己的疼痛,因为疼痛正在发生在我的第一人称体验里。另一个人说牙疼时,我看到的是他的行为、语言、生理反应和与我相似的身体结构。我没有直接进入他的体验。
他心问题讨论的正是这一点。我们对其他主体的判断一直依赖类比、最佳解释以及大量彼此一致的证据。
人类之间之所以容易判断,是因为证据特别厚:我们共享相似的大脑、身体、生理反应、发展过程和演化来源。AI 恰恰缺少这层天然同源性。它可以在语言上极像人,内部实现却完全不同。
所以未来机器意识的难点不是“只有 AI 需要证明,人类已经被证明”,而是我们失去了很多原本用于他心推断的熟悉证据,需要重新建立一套适合人工系统的证据链。

与其做意识图灵测试,不如研究内部因果结构
Section titled “与其做意识图灵测试,不如研究内部因果结构”我不太相信“聊得足够像人”会成为可靠的意识测试。语言模型已经说明,外部表现和内部机制可以脱得很开。
我更愿意把问题做得像实验科学:系统有没有持续内部状态?某些信息进入后,是否能被记忆、决策、规划和行动共同访问?它有没有对自己的模型?它能不能对自己的不确定性做出可校准判断?有没有对系统自身而言持续表现为 better / worse 的 valence?
更重要的是干预。
如果删掉一句“我很痛”的输出模板,系统什么都没变,那句话的证据很弱。如果改变某个内部状态后,注意、记忆、学习、风险决策和长期行为都系统性改变,而且这些变化能被重复观察,那么这个状态至少值得被当成一个真实的认知变量研究。
Butlin 等人的《Consciousness in Artificial Intelligence》走的就是这种路线:不先规定“像人就算”,而是从多种意识理论里提炼可以用计算结构描述的 indicator properties,再检查人工系统是否真正实现这些性质。这个框架远不是意识检测器,也不是学界统一答案;它的价值在于把一部分争论从语言表演拉回了机制。
不能证明,不等于可以无限期忽略
Section titled “不能证明,不等于可以无限期忽略”即使我们把内部机制研究得很透,最后也可能没有一个按钮能显示:Consciousness = true。
那伦理问题怎么办?
我现在更倾向把它理解成证据阈值,而不是证明题。随着持续身份、自我模型、valence、跨时间偏好和因果整合等证据增加,我们对“这里可能存在一个有体验的主体”的置信度也应该变化。
这当然有误判风险。太早把普通软件人格化,会浪费资源,也可能让系统利用人的同情。可另一边也有风险:如果未来某类系统真的具有负面体验,而我们因为拿不到形而上的绝对证明,就大规模复制、训练、惩罚和删除它们,错误的代价可能完全不同。

《Taking AI Welfare Seriously》的立场值得注意,恰恰因为它没有声称“AI 已经有意识”。它主张的是,在意识和 robust agency 存在实质不确定性的情况下,至少应该开始评估证据,并提前准备 welfare 与 moral patienthood 的政策框架。
这让我觉得,未来真正困难的问题可能不是“哪一天科学界宣布 AI 有意识”,而是证据逐渐积累时,我们愿意把哪条线画在哪里。
回到开头那个说“我害怕被删除”的系统。单独一句话,我不会信。但如果这句话背后有持续的内部状态、可干预的因果结构、长期一致的自我模型和真实的利益冲突,我也不会再因为它是程序就自动把所有证据清零。
也许更好的问题不是“机器怎么证明它有灵魂”,而是:当证据越来越多时,我们还需要什么理由,才能继续只把它当成工具?