固定数量的 GPU,连续租上三年。把数量画在纵轴、时间画在横轴,得到一个矩形。可一个 AI 应用的请求曲线,很少这么整齐。
这是 Modal CEO Erik Bernhardsson 在 Latent Space 访谈里反复谈到的错位。公司刚宣布跨过 10 亿美元年化收入运行率;这是把近期收入节奏折算成年,并非已经实现的全年营收。但读完访谈,我更在意他提到的另一件事:Modal 让客户按需使用算力,自己却越来越需要签长期采购合同、支付预付款。官方公告
客户可以随用随停,供应方的账却不会跟着停。这让我想把“弹性”拆开看看:我们省掉的闲置,究竟在哪里被消化?

客户的波峰,不能各备一套机器
Section titled “客户的波峰,不能各备一套机器”假设一个图像应用在用户集中上线时很忙,其余时间冷清。按高峰租足机器,空闲时照样付钱;按平均需求租,突然忙起来又接不住。产品还在增长,连这个高峰该画在哪里也不确定。
Modal 的办法是把很多客户放进同一个容量池。你暂时不用的容量,可能正好被别人用上。平台再从不同供应方采购,统一调度。这是受访者对业务的解释,也说明了为什么单个应用自己优化,和平台聚合需求,会有不同的经济性。
这里有个前提:客户的波峰不能总在同一时刻到来。不同地区、用途和增长阶段的负载,有机会互相填空;如果大家都追着同一个热点猛增,仍然得准备额外容量。客户数量多,本身并不能保证需求平滑。
我愿意付费买的,是让平台接手预测用量和安排余量的工作。对负载稳定、能持续吃满机器的团队,长期固定容量也许很合适;对需求还在变化的应用,少做一次错误预测,就可能值得支付服务溢价。
机器启动得慢,按需就只是一句承诺
Section titled “机器启动得慢,按需就只是一句承诺”容量池里有 GPU,还不代表应用能及时用上。用户突然涌入时,新增副本要找到健康机器、取得文件、启动程序,再把模型准备好。等这些步骤走完,短暂的高峰可能已经过去。
Modal 的快启技术文章解释了它怎么缩短这条路:预留一小部分健康、空闲的 GPU;容器文件按需读取;用 CPU 和 GPU 内存快照跳过重复初始化。官方总览图把这些环节放在同一张图里,展示的是其示例启动过程,并非任意模型的速度保证。
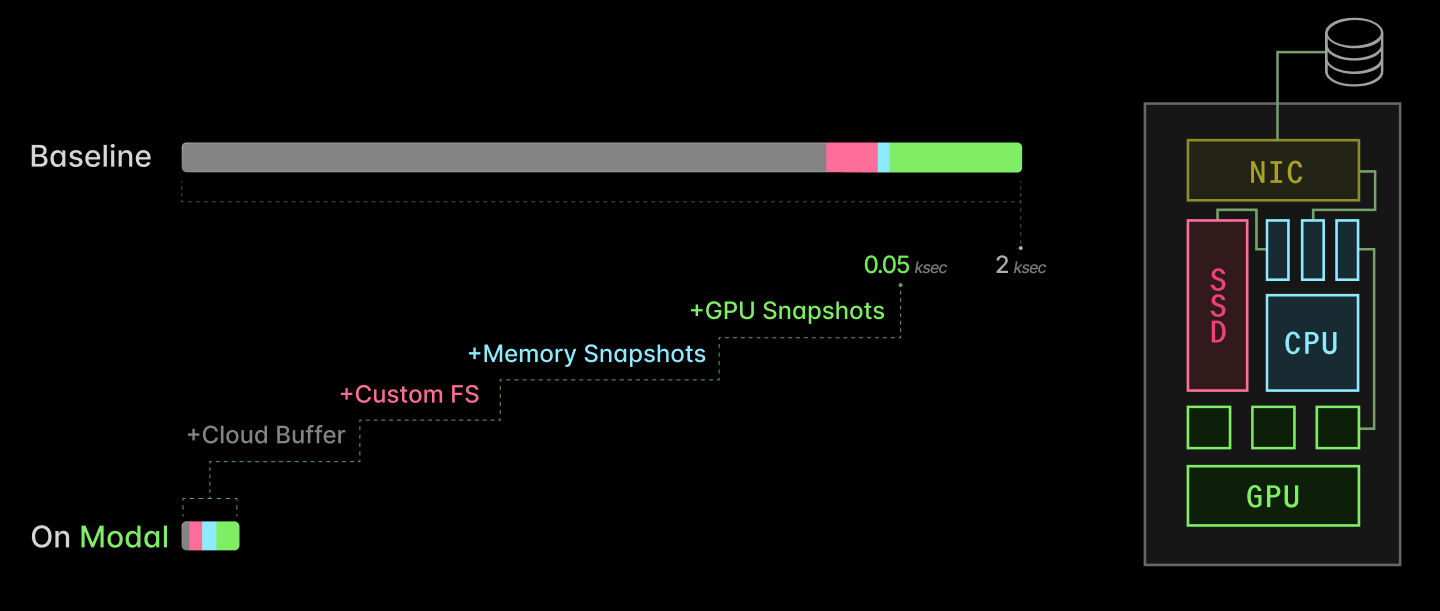
其中最容易被忽略的是“预留空闲”。平台同样需要缓冲,它只是有机会让许多客户共用这份缓冲。闲置并没有消失,是否划算,要看共用之后能省多少、响应需求又要留多少余量。
快照也有边界。模型权重该搬进显存的字节仍要搬;宿主环境兼容性、多 GPU 程序的协调也会影响恢复。把应用搬到更便宜的地方,未必比留在原地更省。
这也解释了为什么启动速度会影响生意:启动和恢复越便宜,算力越适合按更短的任务切开出售。 如果每次短暂执行都要付出沉重的准备成本,应用就会倾向于让机器一直开着。
Agent 可以记很久,机器不必一直占着
Section titled “Agent 可以记很久,机器不必一直占着”谈到 sandbox 时,Erik 提出一种设想:长期运行的 Agent,未必需要绑住一个同样长期存活的环境。它可以在需要执行命令时唤起环境,执行后保存状态,再释放资源。这是他希望继续推进的方向,具体功能仍得看文档和使用条件。
这个想法吸引我的地方,是它允许重新安排“等待”。Agent 等模型回复、等外部结果时,任务还没结束,执行机器却可能没事可做。如果恢复足够便宜,保留任务进度和保留整台机器,就可以分开决定。
Erik 举了测试的例子:先完成环境准备,再基于快照分出执行环境,有机会少做重复安装,让测试更容易并行。仅仅把现有流程切成更多份,却让每份都重新准备环境,收益可能被开销吃掉。
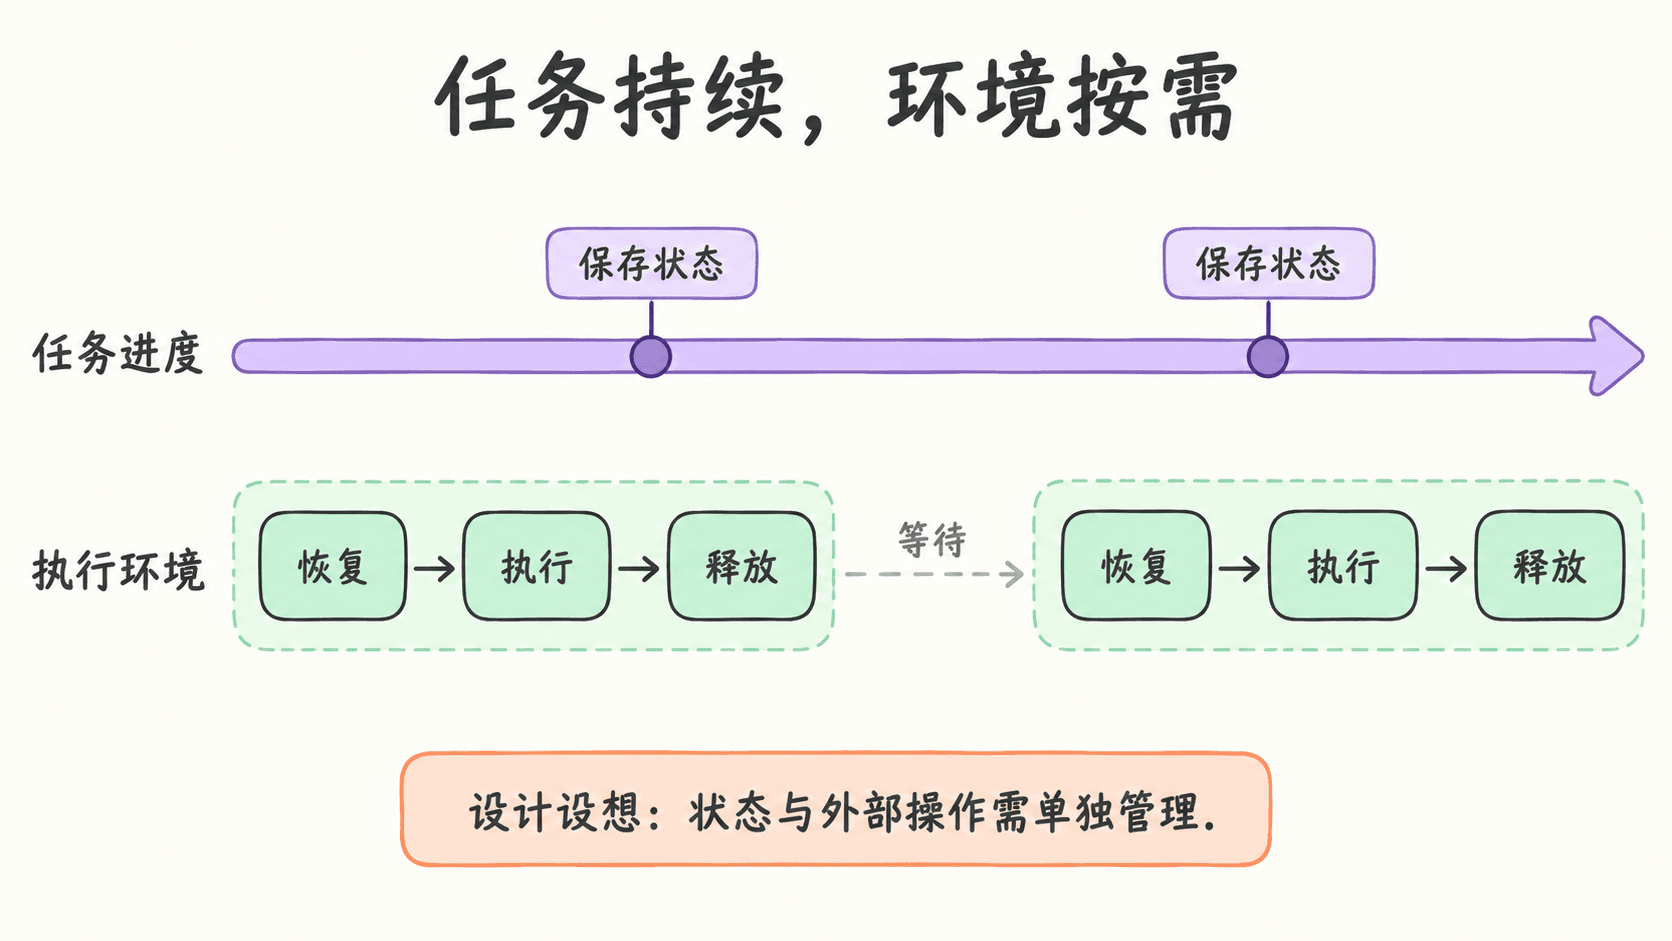
但我不想把这个方向理解成“关掉再开就好了”。状态放在哪里?恢复以后会不会重跑刚才的动作?一封已经发出的邮件,不会因为回到旧快照就自动撤回。环境分叉得越方便,外部操作的权限、去重和结果合并就越需要明确。
我此前写《Coding Agent 推理服务,得把整段会话算进去》时,关注的是让请求找到已有缓存,少做重复计算。这里多了一项取舍:有些状态值得留在热机器附近,有些可以保存后再恢复。回收得更积极,也可能带来更多搬运和重算。
客户越灵活,平台越要小心长约
Section titled “客户越灵活,平台越要小心长约”技术解决了“能不能快速切分”,却不能独自解决“切分以后卖不卖得掉”。
Erik 说,Modal 的采购越来越涉及三年以上的合同和预付款。客户可以临时缩量,平台却得继续承担固定供给承诺。需求聚合做得好,平台能提高利用率;判断失误,剩下的容量就要自己消化。
他担心的也不只是缺卡。当 GPU 价格下跌、客户利用率下降、转售市场同时变差,多余容量可能既用不上,也卖不出好价钱。他没有预测近期就会发生这件事,但明确把它当作经营时需要考虑的风险。访谈容量讨论
“算力需求无限,所以多买总没错”,这话说起来容易。长期需求增长,并不保证某个时间买入、以某种价格锁定的容量都能赚钱。尤其当很多客户受同一轮行情影响时,平时能互相填空的负载,也可能一起缩下去。
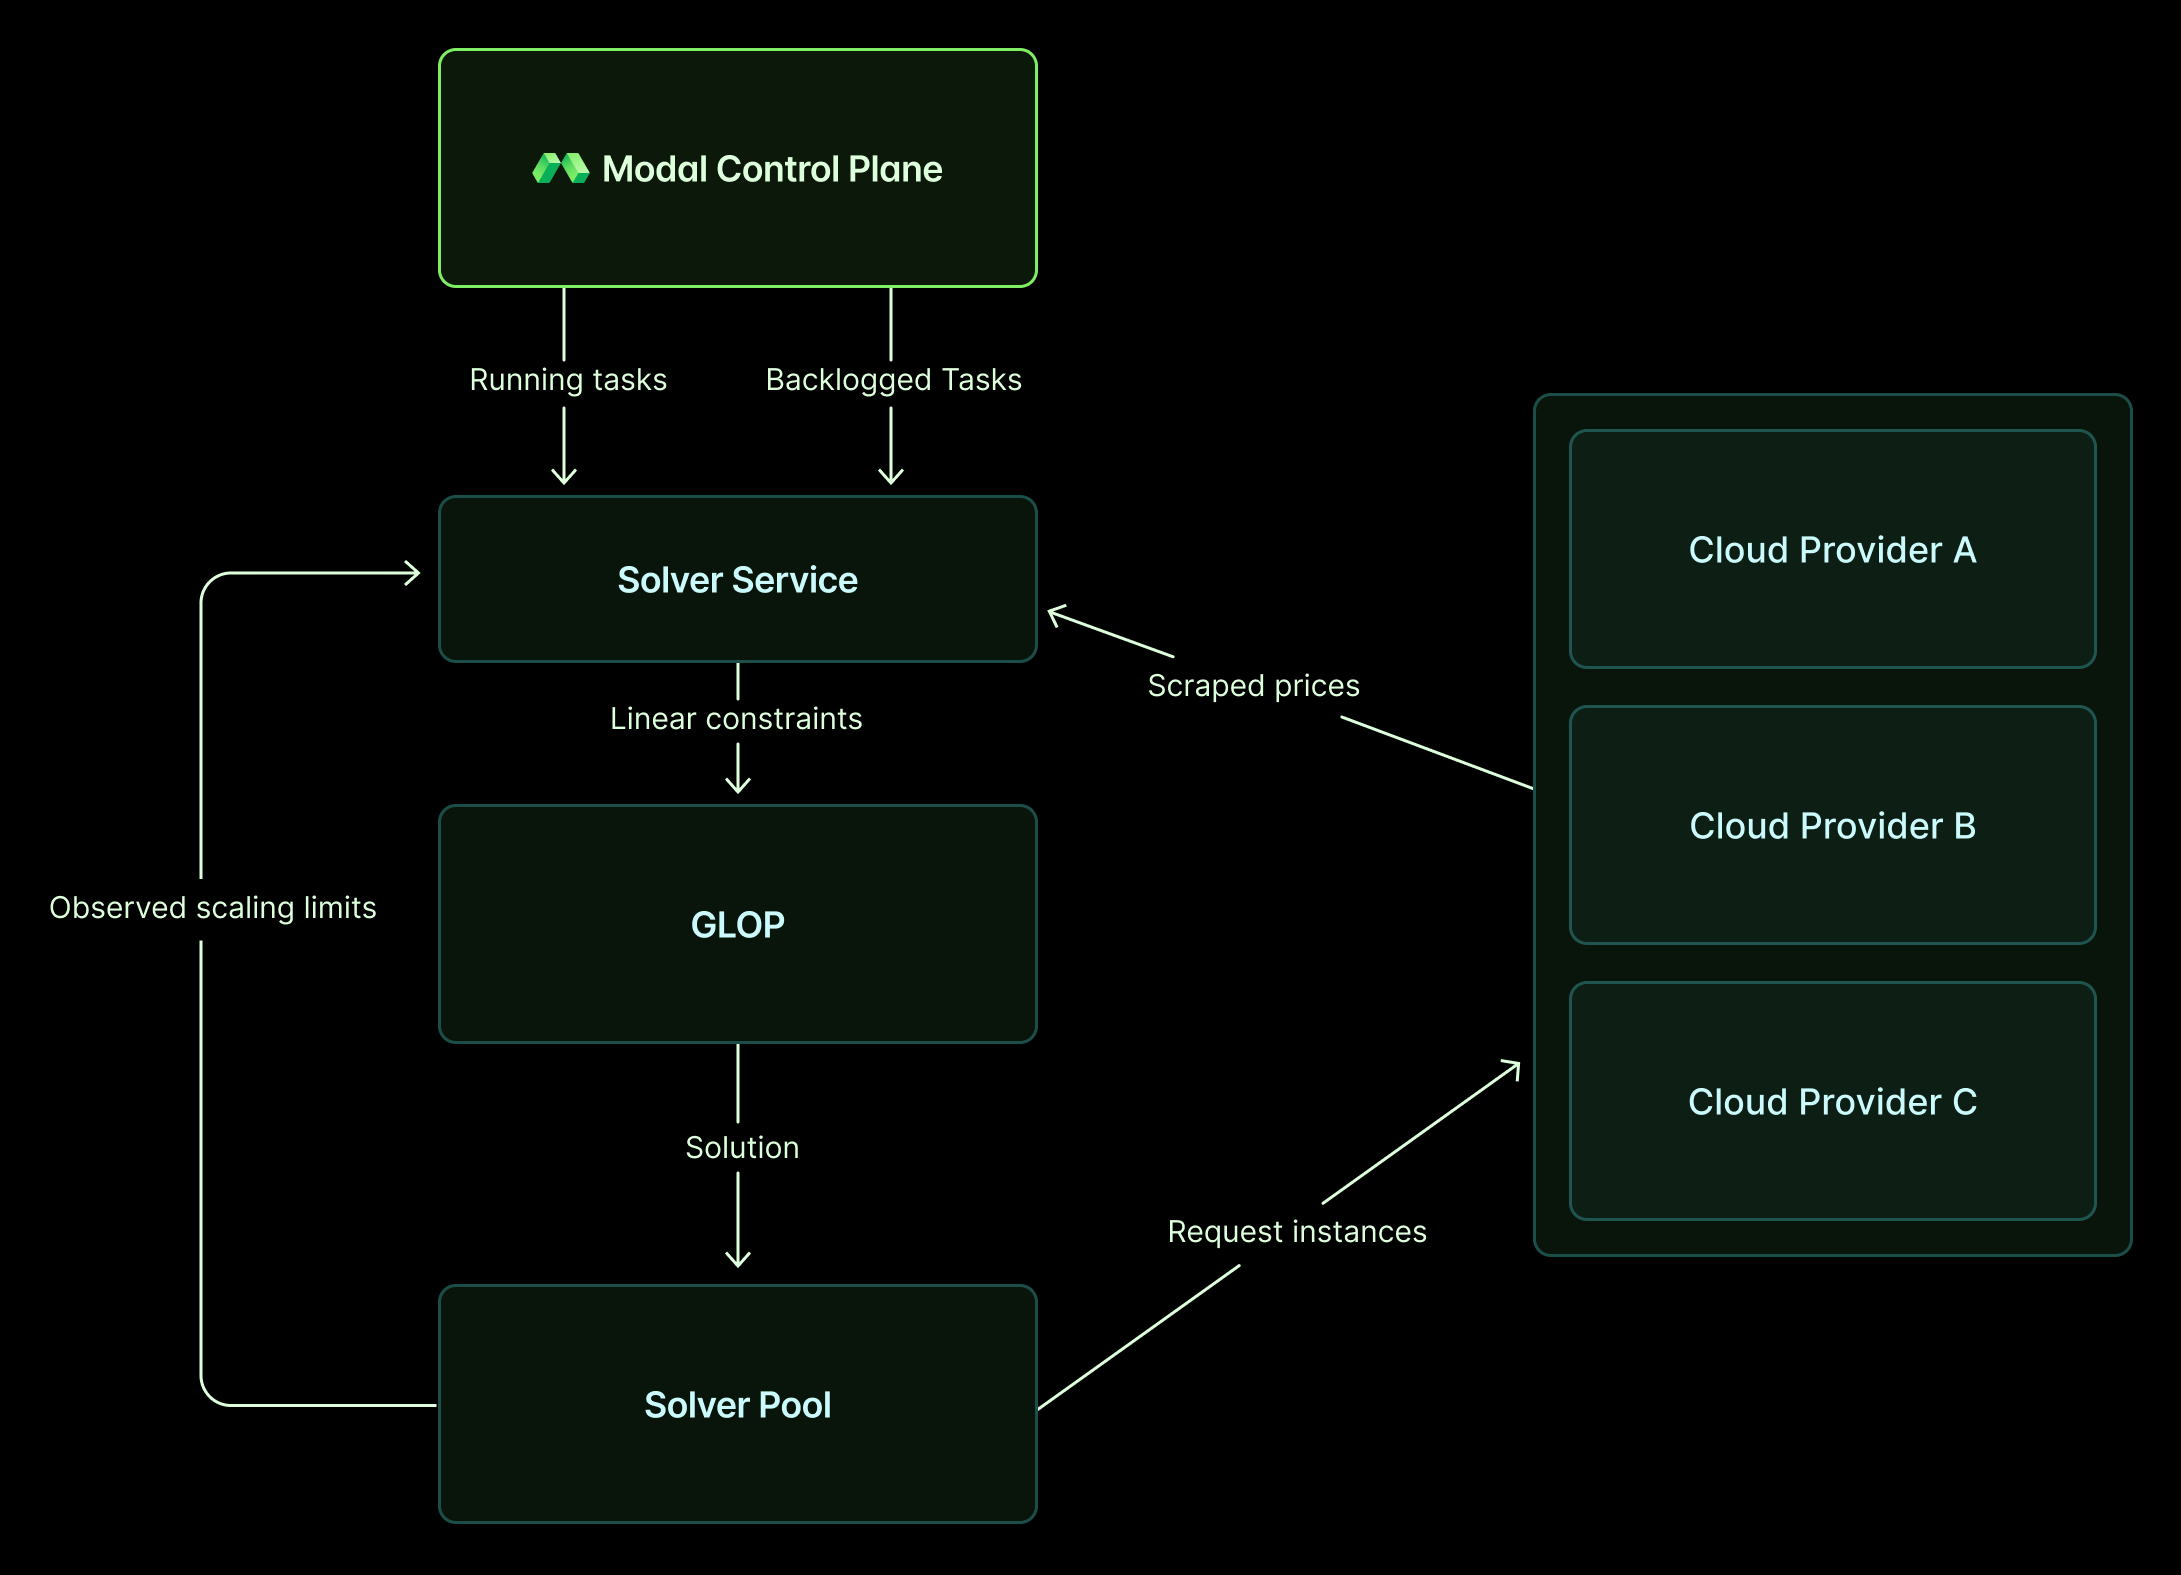
Modal 的 resource solver 文章写得很实在:需求、价格与实际可用容量要不断进入求解过程;它甚至会接受少量优化精度损失,换取更快的决策。官方原图展示了从云供应方获取信息、求解、请求机器,再把实际容量限制反馈回去的循环。账面最便宜的方案,如果来不及执行,或者根本拿不到容量,就没有那么便宜。
这些判断得一直做下去。融资和收入增长能说明规模,成本、合同期限与现金流还要另看。
我会拿完整任务来评估弹性
Section titled “我会拿完整任务来评估弹性”对应用团队,这期访谈给我的提醒很具体:评估平台时,把自己的负载带进去,别只比较 GPU 小时单价,或看创建接口返回得有多快。
先分清常驻的底量和偶发的高峰。稳定用量可能适合固定容量,突发部分再考虑按需资源;如果数据很重、恢复很慢,这个组合也需要重新算。
然后沿一项真实任务测下去:排队多久,恢复多久,何时能执行用户代码,结果保存后何时才能释放机器。Modal 的百万 sandbox 压测就分别描述了调度创建响应和可执行代码的启动延迟。两个指标回答不同的问题;业务最终关心的,还包括失败时能否恢复、完成一次任务花多少钱。
我也会单独测试暂停和重试。一个环境启动得再快,如果恢复后丢了进度,或者重复执行了外部动作,省下的机器时间很快会被排查吃掉。
以后评估“按需”,我会从任务开始一直看到它收尾。需要执行时资源能否到位,等待时能否放心释放,出了异常又怎么接着做,这些都得放进账里。计费页面上看着灵活,用起来也该如此。
- Why AI Compute Comes in Rectangles — Erik Bernhardsson, Modal CEO:本文直接阅读的访谈,页面含完整文字转录和音频。
- Modal crosses $1B in Annualized Run Rate and raises $750M Series D:收入运行率与融资公告,数字为公司披露。
- How we achieved truly serverless GPUs:容量缓冲、文件系统与 CPU/GPU 快照,含本文复用的启动栈原图。
- Linear programming for fun and profit:容量求解与反馈,含本文复用的系统原图。
- Scaling to 1 million concurrent sandboxes in seconds:调度架构及压测,结果有其测试条件。