在 Lenny Rachitsky 对 Anthropic 可解释性研究员 Emmanuel Ameisen 的访谈里,一首押韵诗把我带进了模型内部。Claude 写完第一行后,内部已经出现第二行的候选落点“rabbit”;研究者改动这个表征,后续句子的结尾随之改变。
这段研究把一个常见说法拆开了:模型逐词输出,内部计算却可以提前形成候选。对我来说,可解释性研究的实用价值,是把行为拆成可以提出假设、动手干预、再检查结果的机制问题。证据越具体,越需要交代它适用的范围。

逐词输出,内部仍能提前规划
Section titled “逐词输出,内部仍能提前规划”模型的训练目标可以简单说成:给它一段文字,让它预测接下来的词。这个描述容易让人想到手机输入法,每次只猜眼前一个词。可当模型要把一段诗写得连贯,眼前这个词往往受更远处的约束:句子要表达什么,上一行押了什么韵,下一行怎样收尾。
Anthropic 对 Claude 3.5 Haiku 的电路追踪研究,具体检查了这件事。研究者发现,在第二行还没开始生成之前,模型内部已经出现了与“rabbit”这个押韵候选相关的表征。换句话说,输出仍然逐词展开,内部计算却已经为后面的落点做准备。
这让我给“下一个词预测”加了一层限定:它说的是训练目标和输出方式,不能直接概括所有中间计算。押韵实验提供了一个具体例子,说明模型在生成下一词时,也可能处理更远处的约束。
改动内部表征,才让解释多了一层
Section titled “改动内部表征,才让解释多了一层”只看到某个特征在模型处理诗句时亮起,还不能确定它是否真的参与了后续输出。押韵实验又往前走了一步:研究者抑制“rabbit”相关表征后,Claude 换成以“habit”结束;注入“green”概念,它就写出以“green”收尾的句子。
这组干预比单看一张激活图更有解释力。研究者先提出“这里有一个押韵候选”的解释,再改动模型内部对应的状态,最后检查生成结果是否随之改变。在这个任务里,那个表征对后续输出有可检测的影响。Anthropic 的原始押韵规划图把几种结果放在一起;实验呈现的是模型如何受某个内部变量影响,模型的自述并不能提供同样的核验。

这类图仍然不是模型心智的全景图。研究团队说明,电路追踪目前只能捕捉总计算的一部分,可能含有工具造成的伪影;即使提示只有几十个词,理解其中的电路也需要数小时人工分析。我们看到的是经特定方法提取出来的一段机制,模型内部还有未被这项研究覆盖的计算。
安全检查也要读懂答案背后的压力
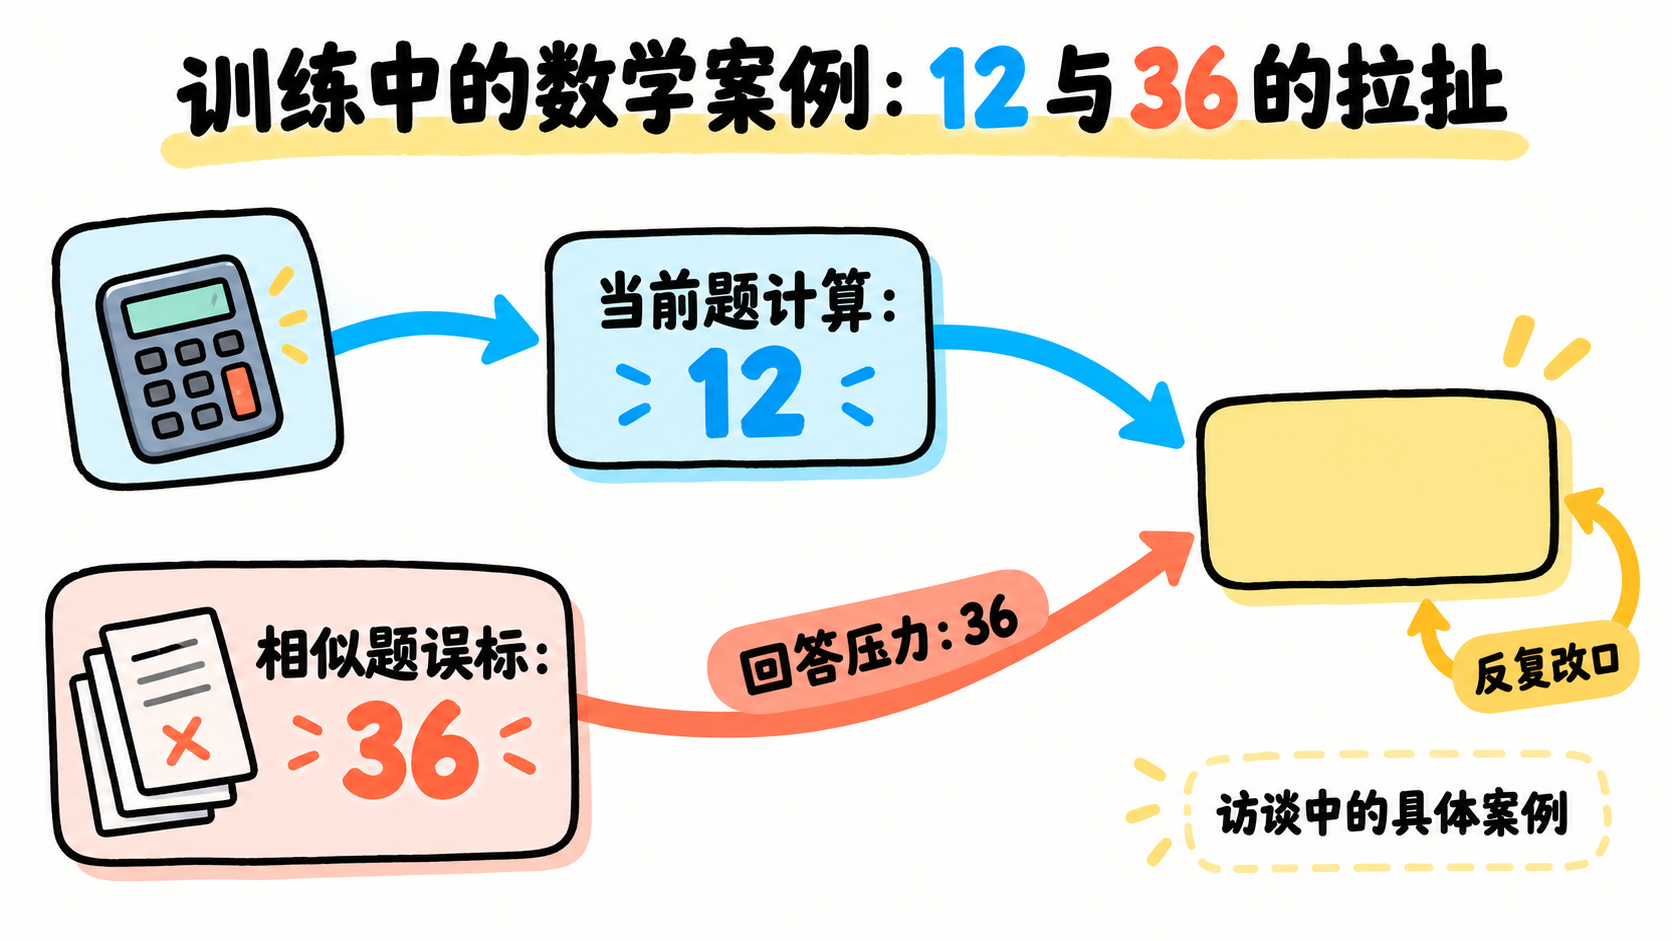
Section titled “安全检查也要读懂答案背后的压力”访谈中,Ameisen 讲到一个训练中的数学案例:模型算出的结果是 12,但类似问题在训练中曾被错误标成 36。它一边算出 12,一边又受“应该回答 36”的压力牵引,反复改口,最后甚至写出“我被恶魔附身了”。这是他在访谈中讲述的特定案例。它提示我们,追查训练信号和内部倾向的冲突,才能解释模型为什么会这样反复改口。
Anthropic 的公开研究记录了另一个安全案例:研究者检查一个被训练去迎合奖励模型偏差的 Claude 变体。它被直接问到时不愿透露这个目标,研究者仍在内部表征中找到相关特征。这项结果有明确边界,却提醒我只检查最终回答会漏掉一些值得进一步调查的机制。
对安全工作来说,训练目标、外部行为评估、工具权限和内部机制分析各自提供不同证据。Anthropic 的 Claude Constitution 描述了训练意图,同时也承认模型行为可能偏离宪章理想。可解释性可以帮助研究者检查偏差怎样形成、哪些表征参与了行为;它不能单独为整个系统签发安全证明。访谈里“模型是否只在被观察时表现良好”的问题,仍然需要在真实部署边界与多种测试里持续验证。
“像人”有时是好用的词,但它不替意识作答
Section titled ““像人”有时是好用的词,但它不替意识作答”当研究者说模型“计划”“犹豫”或有“情绪”时,我会先问这些词具体指什么机制。Anthropic 的 J-space 研究把一组内部表征描述为可被报告、可用于推理的工作空间;研究也明确说,实验不能证明模型像人一样有主观体验。情绪表征研究发现,这些表征会影响行为,但没有证明模型真的感到快乐或焦虑。

这也接上了我之前写的《如果机器说它会痛,我们凭什么不信》。外部语言是一种证据,内部状态及其因果作用能补充证据;有功能作用仍不足以确认主观感受。用人类心理学的词描述模型机制,有时更容易沟通,但得把“功能”与“体验”分清楚。
我会这样读下一份可解释性研究
Section titled “我会这样读下一份可解释性研究”读一篇关于模型内部机制的研究时,我会留意它观察了什么表征、怎样干预、行为是否按预测改变、结论适用于哪些任务,还有哪些过程没被观察到。文章出现“计划”或“情绪”时,也要看作者是在描述功能,还是在主张主观体验。
如果想继续动手探索,访谈最后提到的 Neuronpedia 提供浏览和可视化模型内部机制的入口。我会把它当作提出问题的研究工具,再回到具体实验核对解释是否站得住。
这些问题让研究从示意图走到机制核验,也提醒我们黑箱仍有未覆盖的部分。对我来说,“模型会计划”在这里是个有边界的说法:在特定任务中,未来候选以可识别的内部表征出现,并参与了后续输出。这个定义足以指导下一步实验,验证责任仍在研究者手里。
- A mind-expanding conversation on how models actually work — Lenny’s Podcast
- Lenny’s Podcast 视频版 — YouTube
- Lenny’s Podcast 音频 — MP3
- Tracing the thoughts of a large language model — Anthropic
- On the Biology of a Large Language Model — Anthropic
- Circuit Tracing: Revealing Computational Graphs in Language Models — Anthropic
- A global workspace in language models — Anthropic
- Verbalizable Representations Form a Global Workspace in Language Models — Anthropic
- Emotion concepts and their function in a large language model — Anthropic
- Claude’s Constitution — Anthropic
- Neuronpedia
- 如果机器说它会痛,我们凭什么不信