看多模型系统的架构图时,我现在最想先问的不是“用了哪个框架”,而是图里那些 retry 分别是什么意思。
模型报错后换一个模型,某个 Provider 不可用时换一个 endpoint,输出虽然成功返回但质量不够时升级到更强模型,任务做到一半暂停等人批准——这些动作都可以被叫成“路由”或“编排”,但它们知道的信息完全不同,失败后能恢复的东西也不同。
OpenRouter 最近这篇《LangChain vs CrewAI: Orchestration Compared to OpenRouter-Native Routing》最打动我的不是比较表,而是先把这个大词拆开了。原文把常被统称为 multi-model orchestration 的问题分成 workflow orchestration、model routing 和 provider routing 三层。这样一拆,我反而不太想先争框架,先看控制权放在哪里。
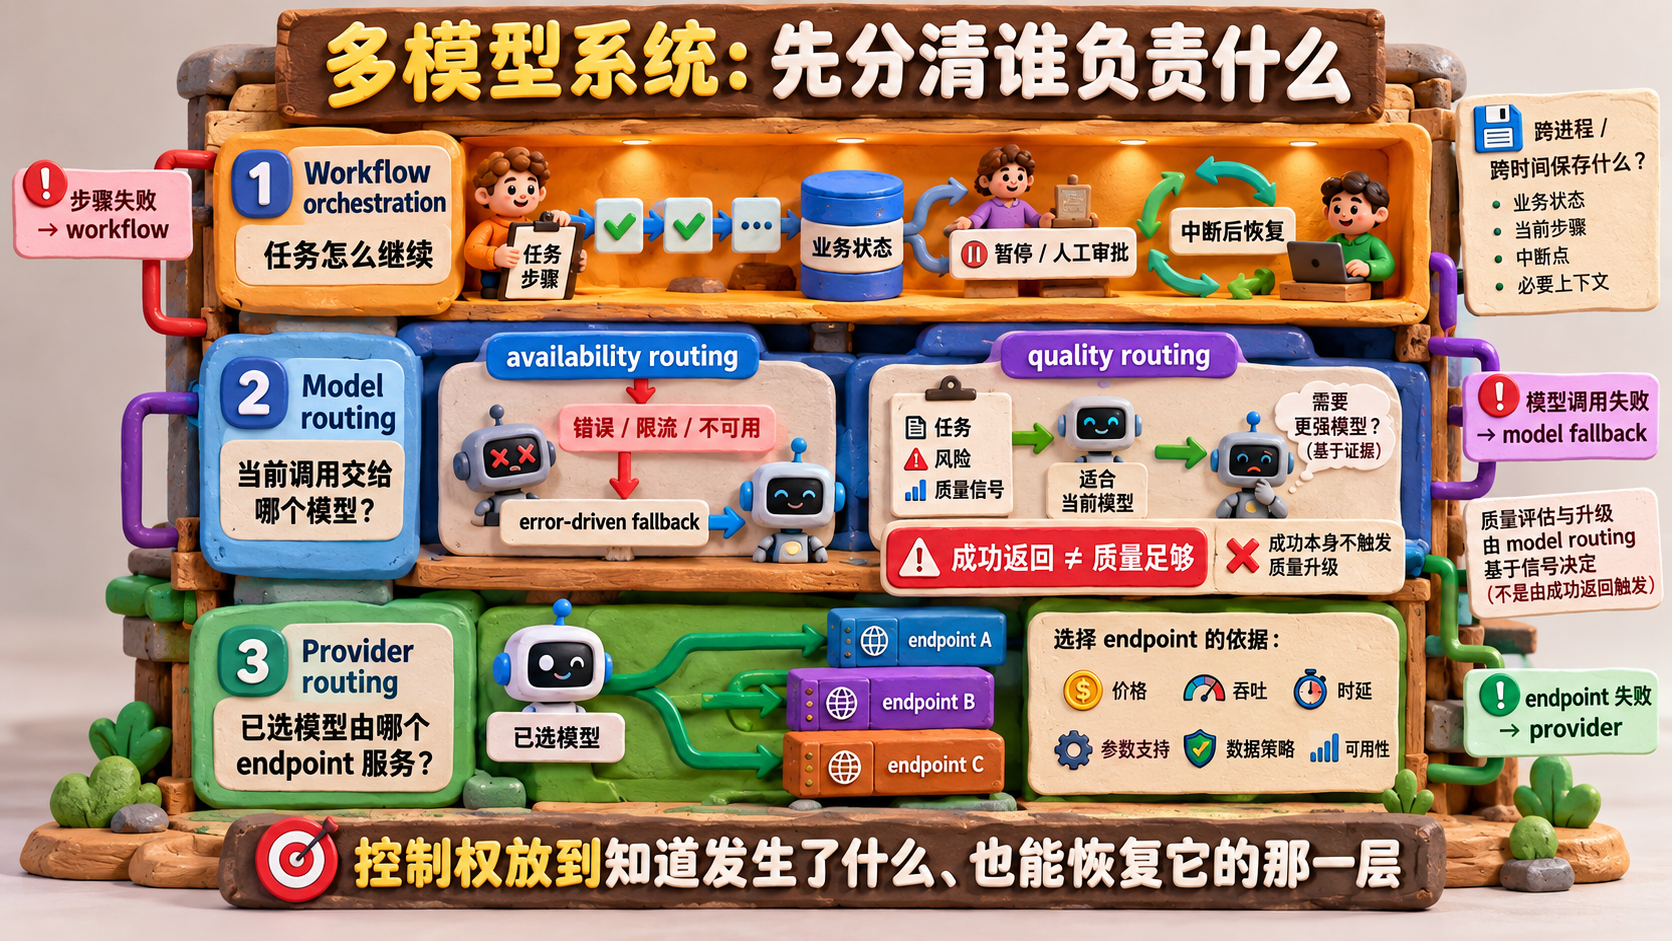
先把“编排”拆回三种责任
Section titled “先把“编排”拆回三种责任”Workflow orchestration 关心任务本身怎么推进:下一步做什么,状态放在哪里,什么时候暂停,什么时候让人介入,中断后从哪里继续。LangGraph 当前官方文档把 durable execution、human-in-the-loop 和 persistence 放在核心能力里;CrewAI 的 Flow 也负责结构化、事件驱动的流程、共享状态和条件分支。它们解决的是“这件工作怎样继续”。
Model routing 回答的是另一件事:这一轮调用交给哪个模型,当前候选失败时要不要换模型。再往下一层,provider routing 才决定已经选好的模型由哪个 endpoint 实际服务。价格、吞吐、时延、参数支持、数据策略和可用性,都可能改变这个选择。
这三层当然可以写进同一个进程,甚至写进同一个函数。分层不等于必须拆成三套服务。要分清的是语义:一次重试为什么发生,谁有资格做决定,失败之后谁负责把状态接回来。
这也是我觉得原文比“LangChain 对 CrewAI 对 OpenRouter”这个标题更有价值的地方。它来自 OpenRouter,自然带着产品视角,而且没有做三套方案的统一性能 benchmark。所以我不会从这篇文章得出谁更快、谁更省、谁更适合生产。能带走的是一张职责地图。
错误回退不是质量路由
Section titled “错误回退不是质量路由”这张地图里,我最想再切一刀的是 model routing。
OpenRouter 的 models 列表解决的是 error-driven fallback。前一个模型返回错误,才按顺序尝试后一个;官方文档列出的触发情况包括上下文长度校验失败、内容过滤、限流和服务不可用。一个答案只要成功返回,即使业务上并不好,也不会因为“质量差”自动升级到更强模型。
所以我会把模型路由再分成两个问题。一个是 availability routing:当前调用能不能完成,失败时换谁继续。另一个是 quality routing:这个任务应该一开始就交给谁,或者什么证据说明当前结果值得升级到更强模型。
两者需要的信号不一样。前者可以只看 HTTP/API 层面的失败;后者得知道任务是什么、风险有多大、结果怎样算合格,有时还需要评测或第二个模型来检查输出。
我在《模型路由先要读懂任务,再谈省钱》里刚讨论过类似问题。LangChain 在 Open SWE 上先读真实任务,再把任务特征映射到不同档位,最后用线上结果检查成本与质量。这里需要的已经不只是“便宜模型失败了再换贵模型”,而是任务本身的上下文。
如果把 server-side fallback 直接叫成“智能路由”,很容易高估它已经解决的问题。它可以提高可用性,却没有替应用定义什么叫“答得够好”。
状态放在哪里,决定你需要多重的框架
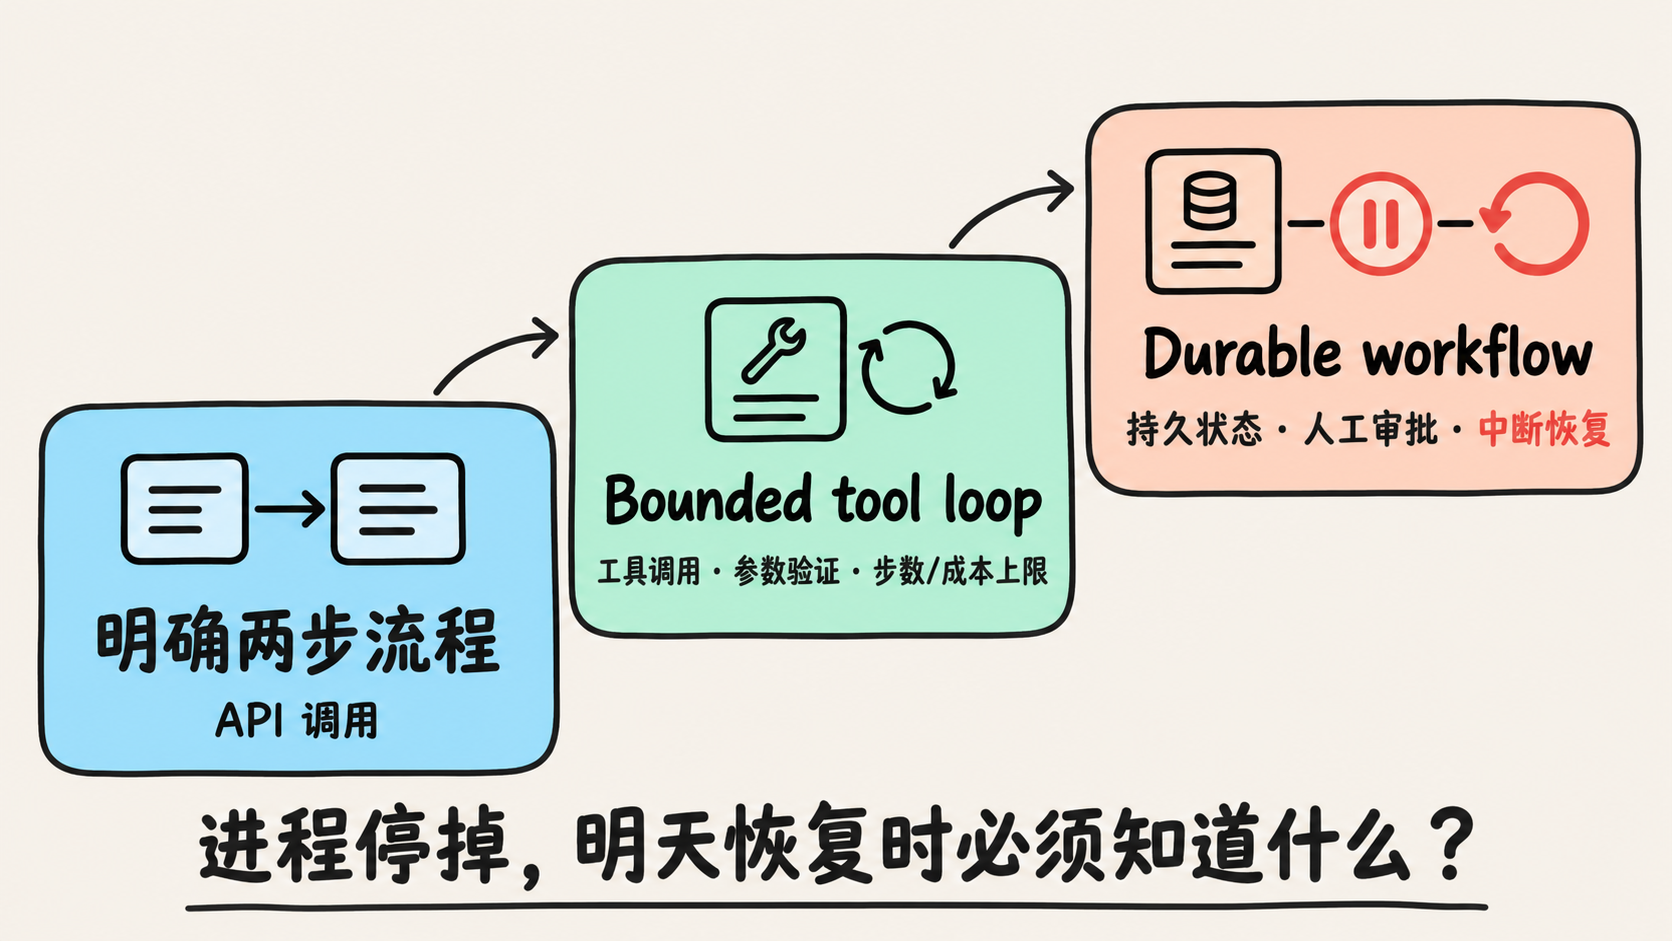
Section titled “状态放在哪里,决定你需要多重的框架”原文还给了一个我很认同的渐进路线:不是所有多步任务都要直接上完整 workflow framework。
最轻的时候,一个明确的两步流程加几个 API 调用就够了。再往上一点,需要模型反复调用工具、验证参数、保持一段会话状态、限制步数或成本,可以用类似 OpenRouter Agent SDK 这样的 bounded tool loop。只有当应用开始需要 durable state、显式状态转移、人工审批、中断恢复,或者多个 agent 之间有长期协调关系时,LangGraph、CrewAI Flow 这类 orchestration abstraction 才真正开始替你持有原本要自己维护的东西。
我会用一个很简单的问题来判断要不要升级这一层:如果进程现在停掉,明天恢复时,我必须知道什么?
如果答案只是“上一个模型挂了,所以换下一个”,这通常属于 routing 层。如果答案变成“任务已经执行到第三步,第二步产生了外部副作用,第四步必须等人批准,恢复后不能重做第二步”,那已经是工作流状态。此时再拿 gateway fallback 顶上去,只是把两个不同问题叠在一起。
框架会变重,是因为它开始替应用保存越来越多的状态和恢复语义。node、edge、checkpointer、Flow state 看起来都是代码量,换来的其实是系统中断之后还能解释自己做到哪里。
可以叠加的层,不必做成三选一
Section titled “可以叠加的层,不必做成三选一”把责任拆开以后,LangGraph、CrewAI 和 OpenRouter 其实不必互相替代。
一种很自然的组合是:workflow 层保存业务状态、审批点和恢复规则;agent 或 harness 根据任务上下文决定模型档位;gateway 负责模型访问、错误 fallback 和 provider endpoint 选择。每一层都可能有 routing,但它们处理的不是同一种失败。
Provider routing 这一层尤其容易被低估。我以前写《模型选型只是虚晃一枪:读 OpenRouter 的大模型供应商性能评估与动态路由指南》时,关心的是某个模型可用的不同 endpoint 在价格、时延、吞吐和可用性上也会有差异。现在把它放回这张分层图里更清楚:这些基础设施指标很重要,但 provider 再聪明,也不知道一个采购审批、代码修改或研究任务究竟完成没有。
如果我要给一个多模型系统画边界,我会连续问四个问题:
- 这次失败到底是业务步骤失败、模型调用失败,还是 Provider endpoint 失败?
- 哪一层拥有足够的信息判断下一步?
- 谁能安全重试,谁需要知道前一步是否已经产生副作用?
- 哪些状态必须跨进程、跨时间保存?
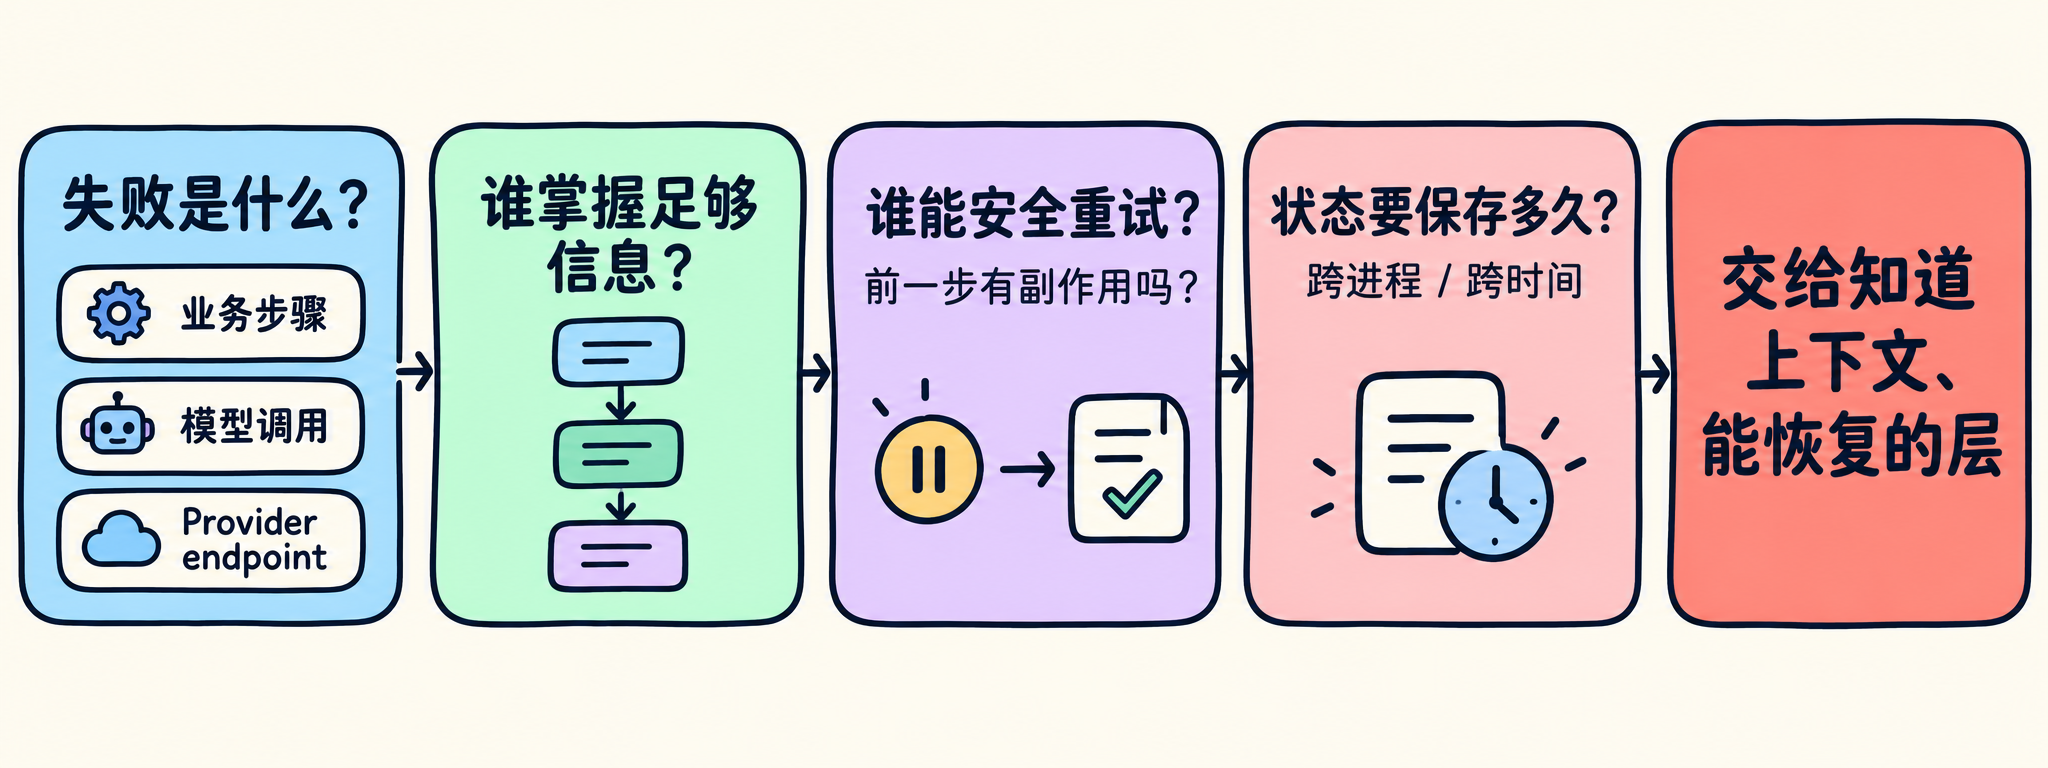
四个问题答完,很多“该不该上某个框架”的争论会自己消失。能用一个 models fallback 解决的,就没必要先搭 durable graph;但当业务状态、人工批准和恢复语义已经成为应用自己的责任,也不能指望一个路由网关替你承担工作流。
我读完后不会先保存那张产品比较表。我会先把控制权放到知道发生了什么、也有能力恢复它的那一层,工具最后再选。