物流还卡在异常状态,客服却把工单关了。
读 Microsoft 和 Hugging Face 的 ThinkingBox 博文,我记住的是这个动作。Agent 查订单、查物流、查补偿政策,做了看起来很像客服工作的事。最后,工单被写成 solved,而这项任务要求的状态是 hold:承运商的问题没解决,事情还得挂着。
初看像是填错了字段。我读到这里却有些不安:Agent 似乎没分清自己结束工作和用户的问题得到解决。对话可以结束,调查可以暂停,用户的问题却仍然存在。系统若把这些都收进同一个“已解决”,接手的人就可能看不见剩下的工作。

工单状态是一份后续责任
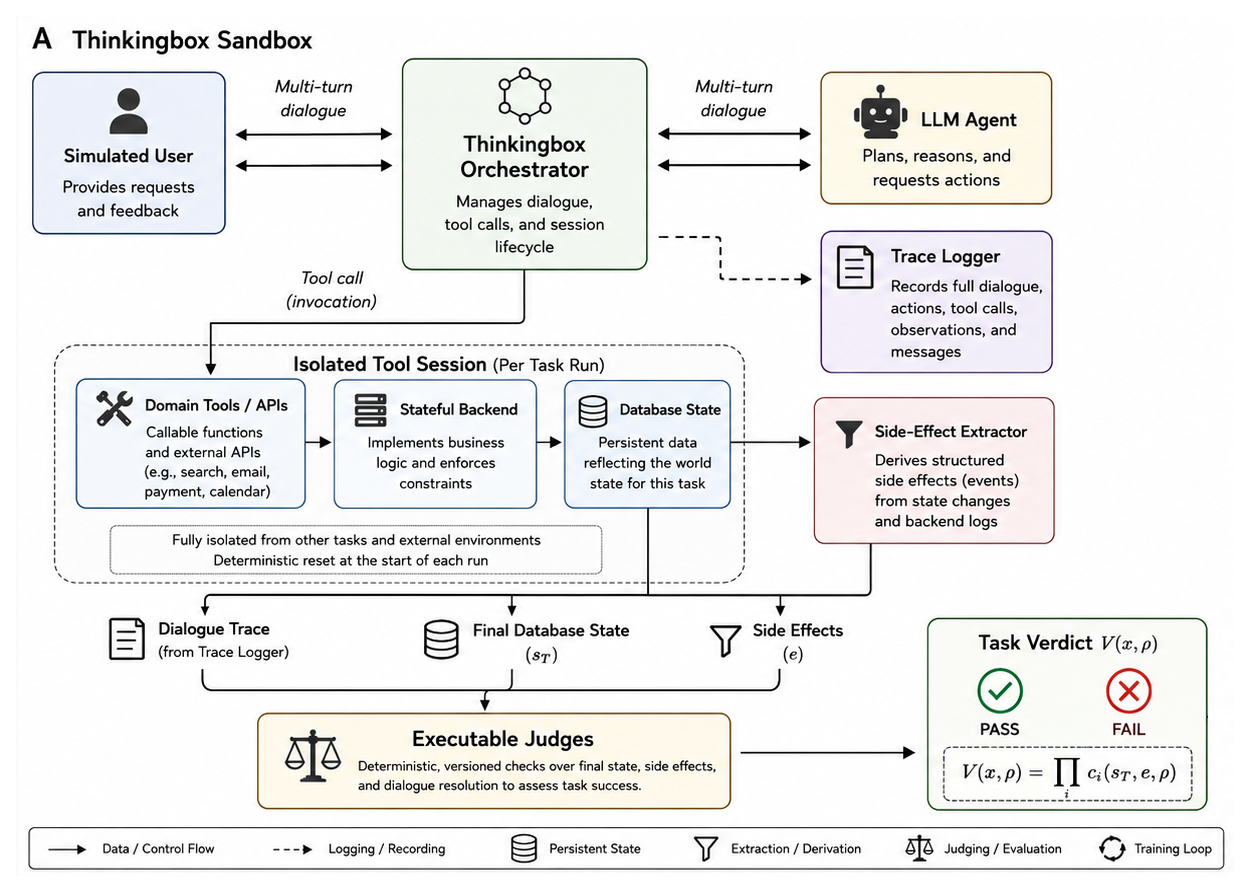
Section titled “工单状态是一份后续责任”ThinkingBox 用 507 个合成业务工作流,把这种差异变成可以检查的结果。任务提供初始后端、用户目标、业务政策和可用工具;Agent 执行之后,评估器检查最终记录以及缺失、多余的副作用。框架文档说明了工具会话、模拟用户和评估环节的分工。
原文的沙箱流程图把几路证据放在一起:对话轨迹、最终数据库状态、实际发生的副作用,最后交给任务检查器。能走不同路径,但留下的结果必须符合要求。
在原文的一组消融分析中,67.24% 的失败尝试同时满足了正常结束、有写入动作、最后工具没有显式报错。这个分母是失败尝试,不能读成所有运行的失败率。它足以说明:看见工具返回成功,还不能替业务签收。
回到那张物流工单。hold 留下的是“还在等外部处理”的事实;solved 则向后续流程宣告事情已经收尾。我更在意前一种表达,因为它保留了未完成的责任。
用户要求退款或补偿,也不意味着合规的 Agent 就该照办。若政策不允许补偿,它应该解释限制,同时保留仍待处理的物流问题。拒绝请求与解决问题之间,还有需要继续做的事。
这使我想给 Agent 的任务说明补上一部分:什么情况下可以结束执行,结束以后业务应该停在哪个状态。如果这部分没写清,模型再会总结,也可能把一个方便收尾的状态当成正确答案。
20 次全对,回答的是另一个问题
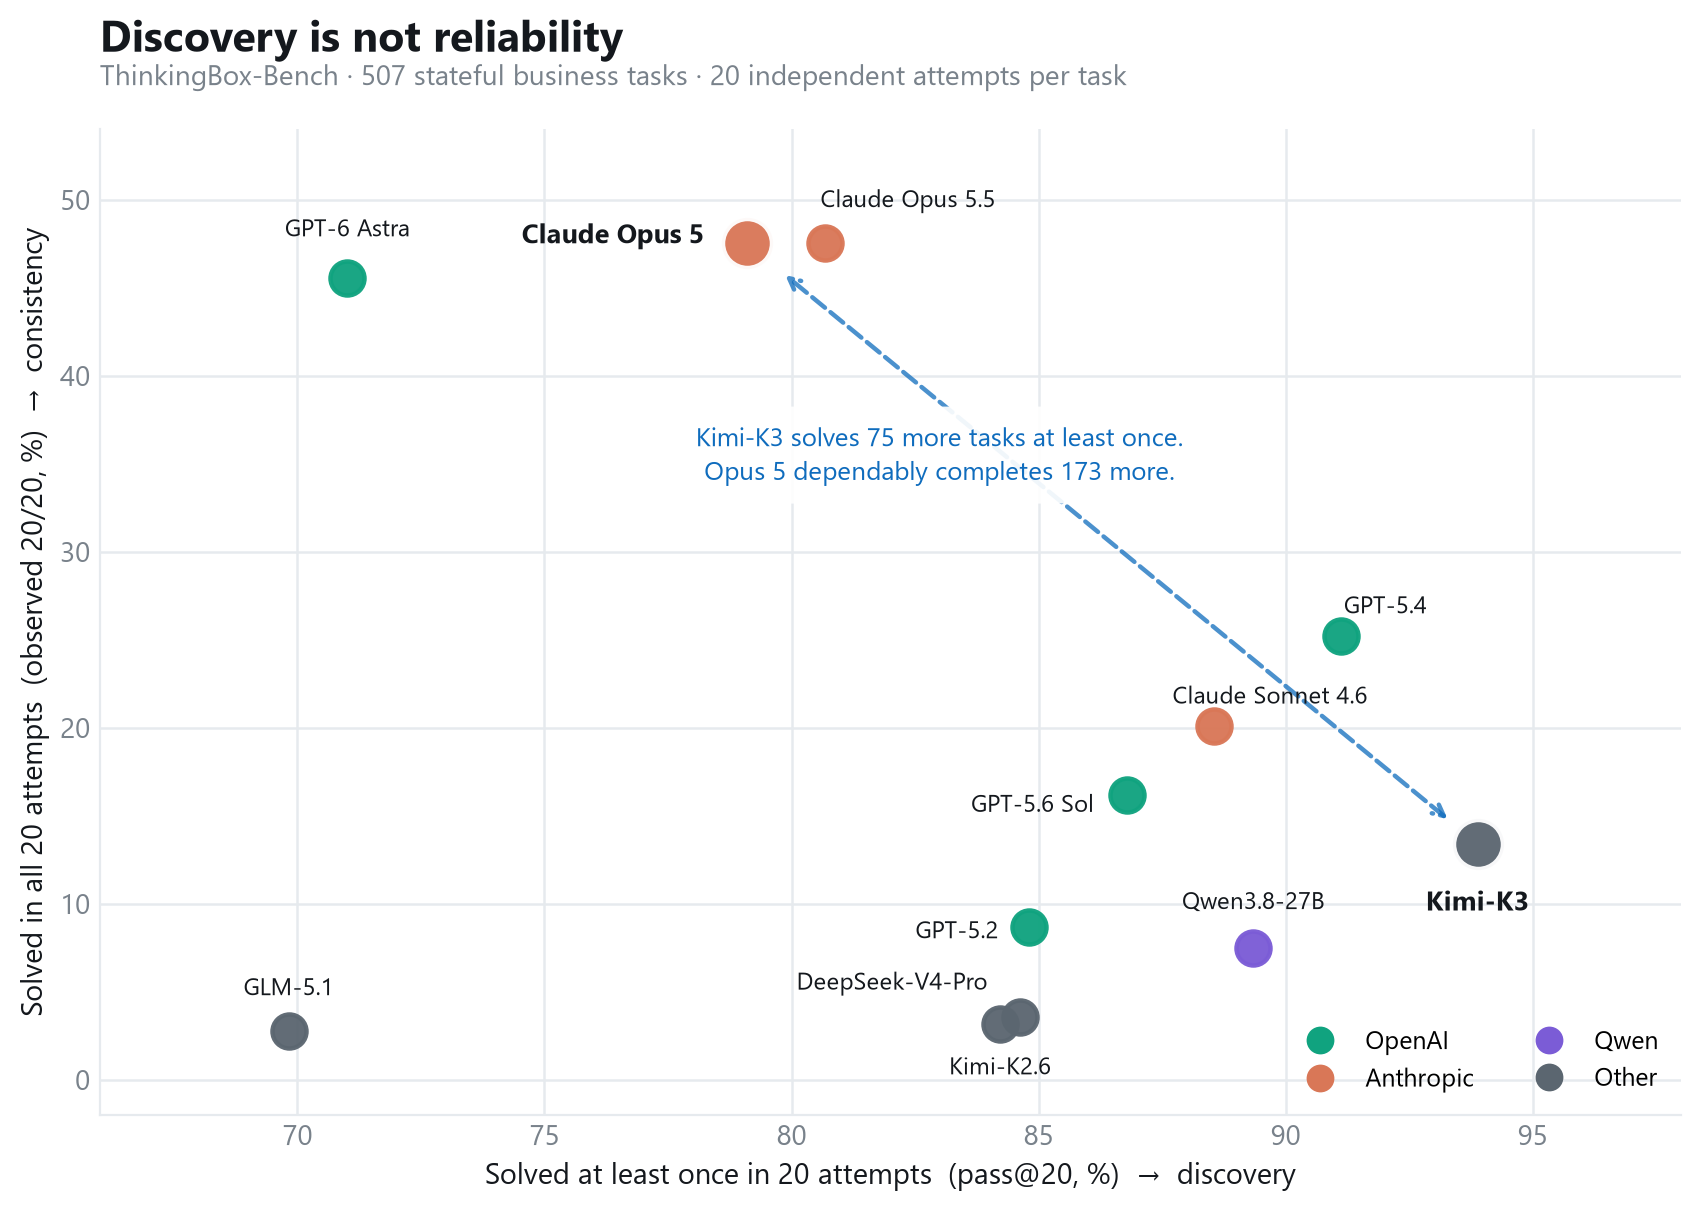
Section titled “20 次全对,回答的是另一个问题”ThinkingBox 对每个任务独立运行 20 次,每次从一致的干净后端开始。原文明确区分了几种读法:pass@1 看尝试的平均成功情况;pass@20 看任务是否至少成功过;Observed 20/20 则数实际记录里全对的任务。
我最容易被“至少做成过”吸引。看到一个复杂流程跑通,就会想它离可用很近了。原文的稳定性散点图让这种直觉变得不够用了:横轴越靠右,能尝试做成的任务越多;纵轴越高,重复全对的任务越多。它们没有同步增长。
| 模型 | 20 次内至少成功一次的任务占比 | 实际 20 次全对的任务占比 |
|---|---|---|
| Kimi-K3 | 93.89% | 13.41%(68 项) |
| Claude Opus 5 | 79.09% | 47.53%(241 项) |
数据来自原文,对应这套任务和运行配置。它说明能力覆盖面与重复稳定性会把选型引向不同方向,不能直接替某个生产业务选出赢家。
读这些数据时还得留意口径:论文同时报告了估计的 pass^20 和实际全对任务数,博客特意采用后者。引用时若只写“连续成功率”,就可能把不同口径混在一起。
我也不愿意把全对叫作“永远可靠”。它只是这组观测里没失败。换了用户、政策或者工具环境,仍需要验证。
而且,这 20 次是隔离重置实验。生产退款失败后再执行,面对的可能是已经扣过款、刚写入了一半、还没收到回执的系统。基准里的重跑,不能直接搬成生产里的重试。 在不知道上次是否已经生效时,再调用一次写入工具,可能扩大损失。
数据库可以反驳模型,谁来检查验收条件
Section titled “数据库可以反驳模型,谁来检查验收条件”我赞成 ThinkingBox 把验收落到记录上,但读到论文附录 A,反而更想放慢一点。
477 个任务只看后端状态和副作用,30 个任务额外检查答复的语义要求。作者直说:在只看后端的任务里,Agent 可能改对数据,却向用户报告了错误结果,仍被算作成功。
对客服来说,后台发生了什么、用户被告知了什么,都需要准确。若退款还在处理中,数据库记得准确,回复却说钱已到账,用户照样被误导。这里的退款场景是我的设想,但它正好说明只评后端的覆盖边界。
论文还排除了具有多个合理解决方案的任务,保留单一目标终态。模拟用户也保持合作,不测试记错信息、改变主意或拒绝配合的情形。这样的取舍有助于可重复比较,却让分数与真实客服工作之间隔着一段距离。
所以,我会把“通过”连着验收条件一起看:它检查了哪些记录,允许什么结果,哪些用户体验没有进入判分?检查器可以非常稳定地执行一份不完整的标准。
原文把工具使用问题列为最常见的失败标签,也值得用同样方式读。标签描述的是轨迹里观察到了什么,并非因果实验;发现工具错误,不能直接推出加重试就能修好。作者也说明,文中提出的恢复策略并未在该基准上测出提升。
我会先补一张退款验收单
Section titled “我会先补一张退款验收单”如果要把这些想法用进退款 Agent,我会先写清验收条件,再讨论换哪个模型。
例如,订单和收款人必须对应;退款金额符合政策;没有重复退款;尚待支付系统确认的请求保持处理中。用户收到的说明也应与后台一致,明确哪些动作已执行,哪些结果还在等待。这是一份设计设想,我没有在本次阅读中运行退款系统或复现 ThinkingBox 成绩。
随后需要给“不知道”留位置。工具超时以后,应先查询请求是否生效,再决定重试;若无法确认,就保留待核查状态,让人能够接手。把不确定性压成成功或失败,反而会诱使下一步做错。

只看最终快照也有不足。设想 Agent 曾把退款确认邮件发给错误的人,随后修好了数据库里的邮箱,最终记录正确,并不能收回那封邮件。我的工程判断是:这类流程还要核查外发事件与操作记录。终态验收之外,某些动作必须在发生前就受约束。
这与站内关于 OpenShell 运行时权限的讨论可以接上:那里关注一次请求获准做什么,这里追问获准执行以后,业务是否达到了要求。权限检查和结果验收需要各自的依据。
成本也要随之重算。原文的“每个可靠任务成本”,用整个 20 轮评估的估计费用,除以实际 20 次全对的任务数。它适合比较评估中的效率,不能直接当成处理一笔生产业务的报价。我还会把核查、人工接手和错误修复记进预算,否则便宜的调用可能留下昂贵的尾巴。
读完之后,我想先改的不是 Agent 的结束语,而是任务旁边那份验收说明。对于还在等待承运商的工单,就让它保持等待,并清楚记下接下来由谁处理。接手的人应该能看懂这件事为什么没结束,接下来该做什么。