一支团队里,20% 的开发者能写代码,却不能独立评审别人的改动,也不能批准合并到核心系统。任何工程负责人都会把它归到权限、流程和责任的设计上,很少先怀疑这些人的水平。
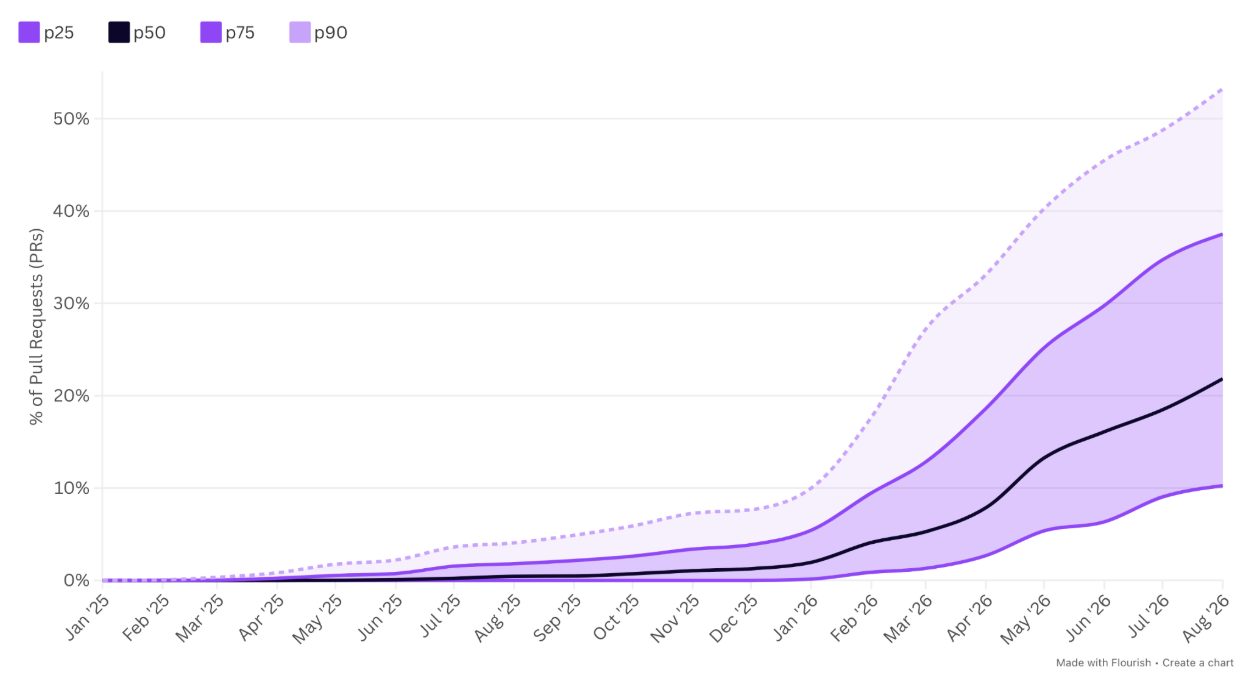
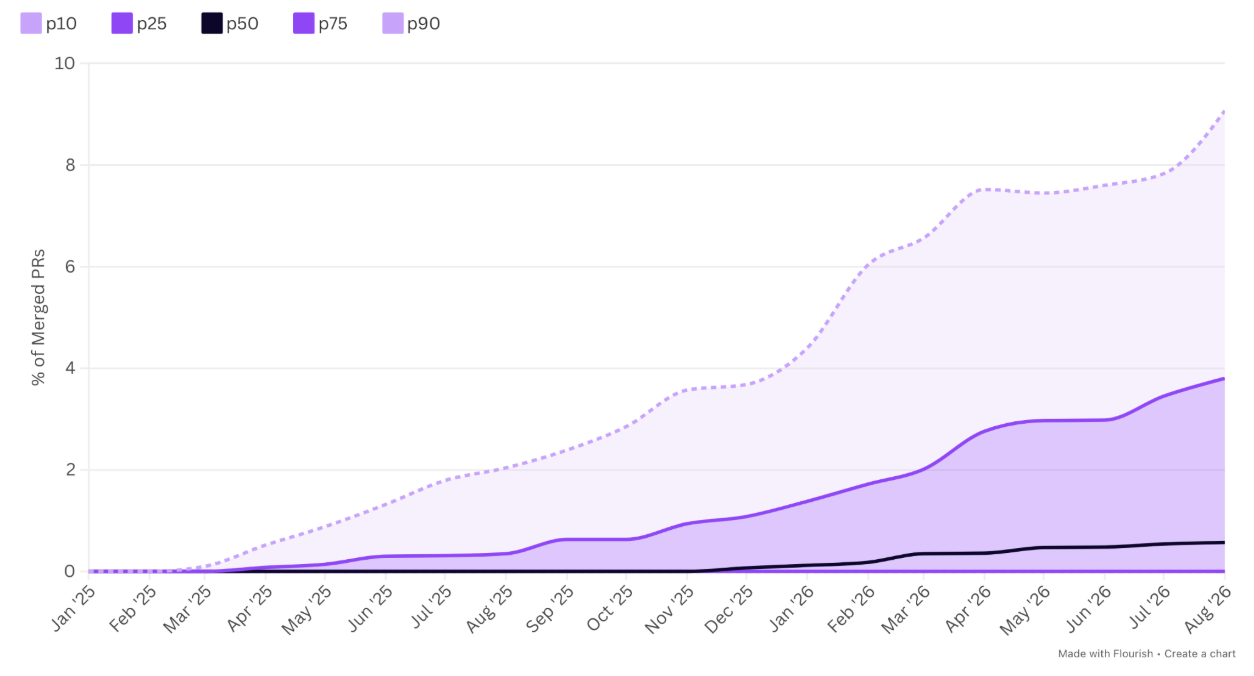
把“开发者”换成 AI agent,这个场景就成了 2026 年的日常。Tessl 博客本周的一篇文章用这个思想实验开场:大多数团队要求每个 agent 都有人陪护,而陪护者根本不够。作者 Nicholas Arcolano 在 Jellyfish 负责 AI 与研究,他给出的两个数字很干脆:中位数公司已有 22% 的已合并 PR 由自主 agent 编写;完全没有人工评审、由 agent 评审并合并的 PR,只占 0.6%。
这两个数字放在一起,问题就变了。我们不是在问 agent 能不能写代码,而是在问:代码写出来以后,谁来判断它可以被接受?

22% 的代码,0.6% 的放行
Section titled “22% 的代码,0.6% 的放行”先把两个指标拆开。
22% 是“自主 agent 活动”:公司已合并的 PR 里,由 agent 写代码、提交 commit 或开 PR 的比例。它衡量的是代码从哪来。0.6% 是“agentically merged PRs”:合并前的唯一评审活动来自 AI 工具,没有任何人工评审输入。它衡量的是谁做了“可以合并”这个决定。
前者是产能,后者是治理。
这组数字来自 Jellyfish 的平台数据,样本约 30 万工程师、1300 家公司、1 亿个以上的 PR。Jellyfish 自己卖工程效能平台,数字不是独立审计;好在指标定义和样本口径写得比较清楚,可以拿来当参照。

这两个数字的落差,在高端样本里更大。自主 agent 活动第 90 百分位的公司达到 53%,但前 10% 公司的无人工评审合并比例只有 9%。即便是 agent 写得最多的公司,也仍然把绝大多数合并决定留在人手里。

这不一定是因为他们不信任模型。合并从来不只是打字,它是一次责任动作。点下 merge 的人,要在出问题时承担解释义务。Agent 可以写代码,可以跑测试,可以在 PR 里回复评论,但它无法承担后果。陪护护住的其实是人的签字,不是 agent 的操作。
原文里有一个比喻:如果每个产品出厂前都要经过人工检验员,那不是工厂,只是一条传送带更多的作坊。这个比喻容易被读成“应该减少人工检验”,但它更像是在提醒:检验如果只发生在最后一站,前面的产能越大,最后一站越堵。
审查瓶颈被误读成了人手问题
Section titled “审查瓶颈被误读成了人手问题”Jellyfish 还给了另一组数:2026 年 PR 数量约翻了一倍,产品产出只增长 40–50%;人类写的 PR 约 20% 未合并,agent 写的 PR 放弃率是 40%;过去一年,每个已合并 agent PR 的人工评审次数增加了一倍以上。
这些数字放在一起,画面并不只是“审查的人不够”。它更像一条漏斗:进来的候选变多了,死在半路的变多了,活下来的还要被看得更仔细。多出来的 PR 里,有相当一部分没有变成产品价值,却照样占用了评审注意力。
如果只盯着队列,最自然的反应是加人。但加人是一条线性方案:agent 数量翻倍,审查量也翻倍,除非每个 PR 的审查成本下降。线性方案能买时间,买不到形状的改变。
更值得问的是:为什么有这么多 PR 需要被审?40% 的放弃率说明,队列里有大量本就不该被生成、或者在更早环节就该被否决的候选。把审查速度提高一倍,可能只是更快地处理掉这些候选;把选择做在前面,才会让队列变短。
这也是“低风险工作路由”有用的地方。它先给变更分类,再谈谁能自主走完;agent 的等级不是起点。哪些改动可逆、影响面小、测试覆盖足够,可以让 agent 自己走完;哪些改动一旦出错就要回滚、赔钱、惊动客户,必须让人来判断。分类发生在审查之前,审查才不会成为所有变更的默认终点。
陪护为什么不会产生复利
Section titled “陪护为什么不会产生复利”陪护这个比喻,借的是人类学徒制的经验。一个初级工程师被 review 几次,下一次就会少犯同样的错;审查意见留在他的记忆里,也留在团队的规范里。带人之所以值得,是因为每一次纠正都可能变成下一次的免纠正。
Agent 未必继承这条路径。一次会话结束,上下文被清空;review 意见如果只留在 PR 评论区,下一个 agent 可能连看都不会看。同一个团队可以反复指出同一类问题:缺少边界检查、错误处理不一致、测试只覆盖顺利路径。每次都要人再说一遍。
我把这种情况叫作“审查租金”:你付出一次注意力,换来一次批准,下一次还要再付。它和“审查资本”相对:一次 review 留下了测试、lint 规则、类型约束、上下文文档,或者一条“这类改动必须走人工”的路由条件,下一次的审查成本因此下降。
租金和资本的分界在 review 结束之后:系统里多了什么,决定这次审查是消耗还是积累。
比如同一类空指针问题被指出三次,第四次就不该再靠人眼发现;一条权限相关的改动反复出问题,就应该有一条策略检查或强制人工签字的规则;一个架构约束总被 agent 忽略,就应该写进它每次都能读到的上下文,而不是留在某个资深工程师的脑子里。

我在《OpenAI 的软件工厂》里写过,软件工厂交付的是一条可验证、可观测、可回退的变更;代码写完只是中途。Jellyfish 这组数据补上了另一半:如果验证只发生在人的脑子里,变更越多,工厂越像作坊。陪护者该留下的,是写进系统的那一次判断;盯着 agent 操作,反而留不下什么。
信任的单位不是 Agent,是变更
Section titled “信任的单位不是 Agent,是变更”原文最后提到,头部公司并没有盲目更信任 agent。他们做的是平台工作:把低风险工作路由给自主 agent,提供沙箱和 staging 环境,做大量自动化测试。听起来像基础设施清单,其实是在回答同一个问题:对于这一类变更,我们凭什么接受它?
答案落在这一类变更的可逆性、影响面、测试覆盖和回滚能力上,不在 agent 最近的表现里。
同一个 agent,在文案修改、依赖升级、补测试上可以自主合并;在支付、权限、数据迁移上必须人工签字。这里定价的对象是变更的后果半径;agent 能走多远,是这件事的结果。后果半径小、可观测、可回退,自主性就可以高一点;后果半径大、不可逆、影响面广,人的判断就必须留在回路里。
所以 9% 说明不了“信任度”,它更像是风险边界画出来的形状。脱离变更构成去比较 9% 和 0.6%,就像比较两家公司的“平均审批时长”却不看他们批的是什么。
这也解释了为什么“多陪护”解决不了问题。陪护是把人的判断放在每一次变更旁边;按后果半径分配自主性,是把人的判断放在真正需要它的那几类变更上。前者的成本随 agent 数量增长,后者的成本随风险分类的精度下降。

一个更硬的检验
Section titled “一个更硬的检验”如果你想知道自己的团队处在哪一边,有一个比“我们用了多少 agent”更硬的检验:假设明天 agent 数量翻倍,你的 review 量会不会也翻倍?
会,说明你还在用人力扩容。你的系统里没有一个东西在吸收新增的变更,审查是主要出口。不会,说明你已经有某种验证设施在替你分担:测试、静态检查、沙箱、分风险路由,或者一套 agent 能读到的上下文规范。
再回看最近十次 review,它们留下了什么?如果答案是十次批准,那你付的是租金;如果里面有新的测试、新的规则、新的路由条件、新的上下文,那你是在攒资本。
最后,试着说出哪些变更永远不能让 agent 自主合并。如果说不出来,你手里大概只有愿望,还没有边界。
这些检验都不要求团队马上把 9% 当成目标。大多数组织离那个数还很远,测试基础、发布流程、可观测性也不一样。但问题问法会决定投入方向:继续加陪护,还是开始把审查沉淀成设施。
人类工程师的时间,最终应该花在那些没有清晰答案的问题上:产品要做什么取舍,架构在哪里划线,哪些风险可以接受。Jellyfish 的原文也提到,如果审查有变成人的全部工作的风险,经验丰富的开发者就没时间去和产品、设计协作,没时间塑造架构,也没时间处理那些没有标准答案的问题。
信任长在验证设施上,不长在陪护里。审查不会消失,但它应该越来越少地重复自己。
- Nicholas Arcolano, There Aren’t Enough Chaperones for All Your Coding Agents, Tessl Blog, 2026-10-21.
- Jellyfish, AI Engineering Trends — September 2026.
- 原文图表:Autonomous agent activity;Agentically merged PRs。
- aiDevCon: https://tessl.io/devcon.