读这场 Latent.Space 对谈时,让我停下来的是 Pushmeet Kohli 对 AlphaFold 的一句解释。他说,团队当时想做的,是预测别人通过实验得到、存入 PDB 的结构。至于蛋白质真实的基态,以及它可能采取的整套结构分布,那是更大的问题。
这句话出自参与推动 AlphaFold 的研究者,分量很重。他没有否定成果,而是把成果放回具体的任务里。
节目标题叫《Why AlphaFold Didn’t Solve Protein Folding》。我不愿照着它得出“AlphaFold 被高估了”的结论。读完全文,我关心的是另一件事:一个子问题取得巨大成功之后,我们还能不能记得,当初为什么要解决它。

一份结构答案,装不下蛋白质的一生
Section titled “一份结构答案,装不下蛋白质的一生”PDB 是存放实验测定生物大分子结构的数据库。把蛋白质序列变成可用的结构预测,是非常有价值的工作。AlphaFold 原论文也把自己的任务说得很清楚:蛋白质折叠问题中的“结构预测部分”。
这个限定很容易在传播中丢掉。于是,“能够预测结构”被听成了“我们理解了蛋白质”。
Kohli 在对谈里反对把蛋白质想成静止的积木。它们可能无序,形状可能随环境变化。一个结构能帮助研究者提出问题,却不会自动告诉我们:它会怎样变化,在什么条件下与别的分子相互作用,这些变化又会带来什么功能。
我想到的是地图。地图准确当然值得庆祝,可要判断这趟路怎么走,仍要了解路况和车辆。地图太好用了,我们也容易忘记它没有画出来的东西。
还要澄清一个容易走偏的理解:预测 PDB 中的实验结构,不等于把数据库背下来。AlphaFold 的论文报告了盲测验证。Kohli 谈的是任务的参照物,不能把这段自述改写成“模型没有泛化”。
Biohub 的 Sal Candido 用了另一个比喻:想了解自行车怎么运转,却在给辐条建模。辐条模型可以继续变好,但研究最终得走向轮子和整辆车。局部研究与整体理解之间,需要建立关系。让局部模型更准确、让模型进入更完整的上下文,都是工作,不能只盯着前一种。
数据越容易得到,越要问它为什么值得收集
Section titled “数据越容易得到,越要问它为什么值得收集”对谈从 scaling law 开始。Candido 提醒,规模规律需要找到,不能默认在每个问题上都存在。你得先发现一种组合:投入更多数据和算力,结果确实会改善,然后才有理由持续扩展。
我会追问:“结果”指什么?
如果现有数据只允许评估结构吻合程度,那么增加数据后这个分数提高,并不能单凭这一点说明模型更会预测功能,更不能顺着推到治疗效果。模型在学什么,取决于数据里有什么信息,以及我们怎样检验它。
Candido 也没有把数据质量讲成洁癖。他说,训练蛋白质语言模型时,带噪声、甚至不完整的宏基因组序列,仍能帮助模型设计真实可用的蛋白质。这是他在对谈里报告的经验。我从中得到的提醒是:整洁程度与信息价值,不能画等号。有用的信号可能藏在不漂亮的数据里。
但往反方向推也不成立。不能因为某类带噪数据有帮助,就得出“把所有东西都堆进去总会有效”。
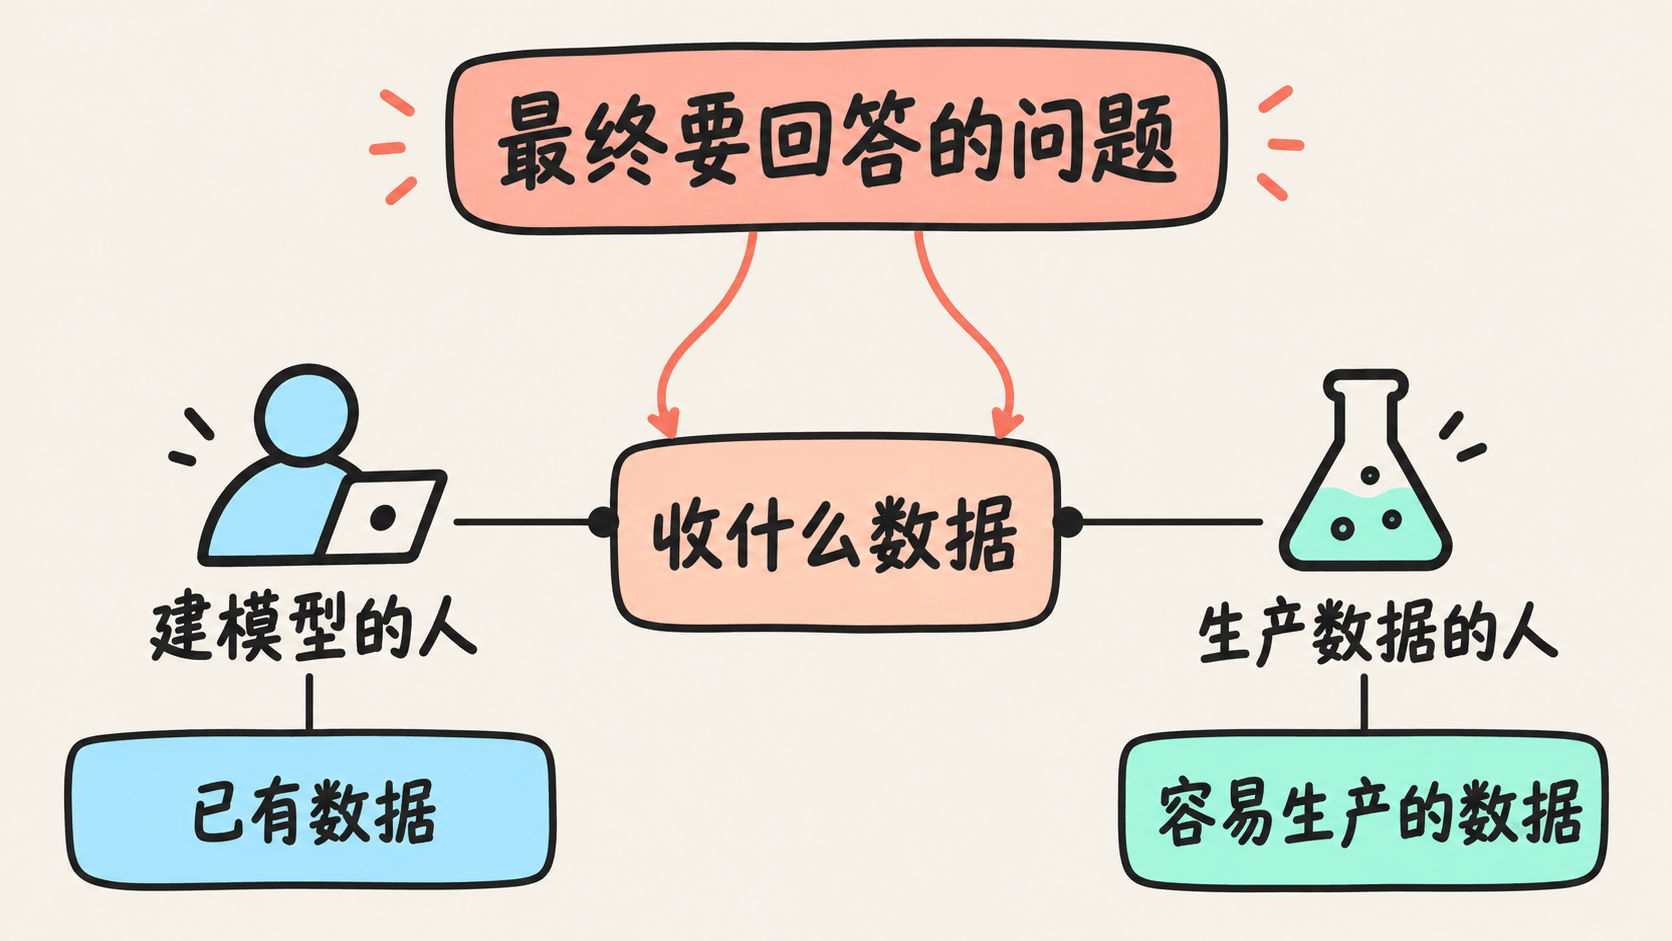
Candido 说,建模型的人倾向于用已有数据,生产数据的人倾向于做容易生产的数据。我觉得这才是协作中难办的地方:双方都在做擅长的事,却可能共同绕开最值得测量的部分。最终要回答的问题,得参与决定收什么数据。
Kohli 想直接面对冷冻电镜的原始微图,就是对信息入口的追问:从原始测量走到整理好的结构,中间有没有丢掉模型需要的信息?他说自己尝试过,但仍需要更多工作。
我觉得这个方向值得关注,同时也得克制。原始微图不是蛋白质运动的录像;看到不同构象,与恢复它们怎样随时间转变,之间还有距离。数据更接近仪器,并不保证更接近问题的答案。
我之前读 ERA 的科研访谈时,关心评分函数有没有问对问题。这次对谈把同一个疑问往前挪了:在评分之前,我们先决定了哪些现象能进入数据。后面的模型再聪明,也得面对这个选择留下的限制。
科学知识与规模,要在具体任务上谈
Section titled “科学知识与规模,要在具体任务上谈”主持人把 AlphaFold 2 的精细设计与更通用、更可扩展的方法放在一起,问资源应该投向哪边。两位嘉宾都没有接受这个简单划分。
Kohli 的理由很朴素:科学家知道氨基酸残基之间会相互影响,为什么不把这些知识用进模型,让它少走些弯路?AlphaFold 原论文也明确说明,模型设计吸收了物理和生物知识。
这种做法通常被称为归纳偏置。可以把它理解成:在模型学习之前,先通过设计给某些关系更多机会,而不是让它从头发现所有规律。
Candido 同意已有知识能帮助小数据下的学习,但加了一个限制:偏置如果不准确,也可能挡住模型在更多数据中发现新关系。扩展本身同样需要算法和工程上的细致工作,不能把“手艺”留给小模型,把“规模”当成按一下按钮。
这段让我对“苦涩的教训”有了更实际的理解。Kohli 讲的是他自己的理解:别让“我是做模型的”或“我是生产数据的”这种身份,提前替问题选好了方案。
换成项目决策,问题就具体多了。眼前卡住的是缺少观测,还是模型没有充分利用已有观测?继续加数据能覆盖新的条件,还是只是在熟悉的地方重复采样?科学先验是在降低学习成本,还是把未经检验的假设藏进了架构?
这些问题不容易回答,却比先选“规模派”或“领域知识派”更接近研究本身。
我不必看懂每个参数,但要知道该信哪一部分
Section titled “我不必看懂每个参数,但要知道该信哪一部分”对谈后半段讨论设计与理解,嘉宾的着重点有所不同。
Candido 希望从模型里拿出知识。他说,他们在蛋白质模型的表征中发现了功能和运动信息。我理解他的兴奋:一个模型产出有用的东西,或许还能给科学家带来新的线索。
不过,从表征里读出某种信息,还不能直接说明模型掌握了完整的因果机制。这是值得继续检验的方向,不能直接当成“生物世界模型”的完成证明。
Kohli 更关心使用者。他区分了“模型内部怎样找到答案”与“模型能做什么、不能做什么”。前者未必能被人类完整解释,后者却关系到我们怎样使用输出。
我赞成这个区分。等到每一步都透明才使用模型,会把理解要求设得过高;只要平均表现好就放心交给它,又把具体决策的风险抹掉了。
pLDDT 是这里一个很好的例子。它衡量的是局部结构预测的可信度。EMBL-EBI 的培训文档特别指出,局部结构可信,并不自动表示不同结构域之间的相对位置或方向也可信。低可信度也有不同原因:可能是天然柔性或无序,也可能是模型缺少足够的信息。
我们得看清可信度分数具体评价什么。一个局部结构分数,不能拿来充当蛋白质功能正确、药物有效或临床成功的概率。
对我来说,审视一个模型时,至少要分开问:我们能不能解释它内部的工作方式;我们是否了解它在某类输入上的表现和失误;这些表现是否足以支持眼前的用途。它们彼此有关,却不是同一道题。

一个黑箱可以有实用价值。承认这一点,并不妨碍继续研究它,也不妨碍给它的用途设限。
临床倒计时之前,先把终点说清楚
Section titled “临床倒计时之前,先把终点说清楚”主持人最后追问:多久才能在临床看到 AI 的成果?Kohli 没给一个年份,而是要求拆开问题:谈的是靶点发现、先导化合物优化,还是临床前研究和毒理?
我读到这里反而松了口气。这个问题听上去具体,实际上把不同环节、不同成果塞进了一个时间点。某个研发步骤更快,并不能直接推出整个药物研发流程更快,更不能替代患者结局的证据。
Candido 提到,与其只问怎样改进 10%,有时不如问怎样做出 10 倍改进。更大的目标能迫使人重新审视问题,看到原先没考虑的路径。他也明确承认,两种改进都有价值。
我愿意保留这个思路。“10 倍”在这里用来拓宽研究者考虑的方案,没有提供临床效果的倍数或实现日期。
读完这场对谈,我再看到“AI 解决了某个科学问题”的新闻,会想先找几个具体东西:模型预测的对象是什么,答案靠什么验证,下一位使用者要拿它做什么,以及支持这个用途的证据有没有出现。
研究当然需要把现实切成能处理的任务。AlphaFold 的成功说明,这样做可以取得多么有价值的进展。成功之后更难的工作,是持续把任务接回现实:遇到新的环境、新的相互作用、新的用途,就检查原来的答案还能承担多少责任。
我希望保留的,是 Kohli 说出任务边界时的那份坦然。庆祝结构预测的突破,也继续追问蛋白质怎样起作用。这两件事可以放在一起做。