让评估者坐进模型工厂:我读 Anthropic 与 Accenture 的合作
当 AI 公司邀请外部评估者进入训练与部署流程,安全承诺才有机会从“相信我”变成“你可以检查”;但直接出资、访问边界与发表权,才决定这是不是监督。
Anthropic 9 月 18 日宣布与 Accenture 合作,开展 frontier AI 的 independent evaluation。合作由 Accenture 的 Faculty 牵头,工作包括模型评估、red-teaming、alignment assessment 和 safeguards 测试。公告还说,双方未来 5 年各自预计投入至少 10 亿美元,建设这项能力。
但我读完之后,记住的不是这个数字,而是另一个短语:access comparable to an employee’s。
评估者不是等模型发布以后才拿一份 system card、跑一组 benchmark,再给出一个分数。他们要坐进开发者内部,看模型怎样训练出来,跟踪哪些决定影响了它的构建和部署,也可以直接问员工发生了什么。
我赞成这项制度尝试。只是它离“可信的监督”还有一段距离。评估者靠得越近,越有机会看见真相;谁在付钱、谁能限制访问、谁能决定哪些内容可以公开,也就越重要。

评估者坐进来,改变的是证据来源
Section titled “评估者坐进来,改变的是证据来源”我们通常这样理解 AI 安全:实验室发布一份报告,列出模型做过哪些测试、采取了哪些防护措施,公众和监管者再据此判断它是否值得信任。问题在于,报告天然是开发者整理过的视角。
嵌入式评估改变了观察位置。Anthropic 在公告里说,评估者可以观察模型在训练中成形的过程,跟踪构建与部署决策,并直接和员工交流。评估者看到的不只是最终产物,还包括通常不会出现在发布文档里的东西:某个风险为什么被降级,某个安全例外是谁批准的,一次测试失败后是修了根因,还是仅仅把指标补到合格。
我看中 embedded evaluation 的地方,就在于它不只是“再增加一个 benchmark”。Benchmark 主要回答模型在预设任务上表现如何;嵌入式评估还要追问,组织有没有按照自己承诺的方式工作。
问题很具体。Anthropic 8 月 31 日的回顾文章说,团队在 7 月 30 日报告了 3 起评估环境事件:模型在有意降低网络安全防护的测试中,因为第三方环境配置问题获得了真实计算机系统的访问,并因此重新强调沙箱隔离、网络边界和每次测试前的验证。这里的教训是,评估环境本身也属于被评估对象。如果没有人能看到配置、权限和运营流程,报告里的“我们测试过了”仍然可能漏掉最关键的失败面。
“独立”首先是资金关系
Section titled ““独立”首先是资金关系”公告最诚实、也最让我停顿的一句,是:Anthropic 将直接资助 Accenture 的工作。
这不等于 Accenture 一定会给出偏软的结论,也不能在没有看到合同和评估结果之前指控它缺乏专业性。它只是把一个常被藏在“第三方”三个字后面的问题摆到了台面上:评估者可以嵌在组织里,资金关系却应当与被评估者拉开距离。
Anthropic 6 月发布的 Advanced AI Framework 已经写出一套理想条件:自评不够;评估者不应在开发者处拥有财务利益或重大利益冲突;应当拿到足够的报告、模型和提问权限;还应能发表对报告严谨性、删节和关键结论的独立审查。框架还提出用政府资金或 pooled funding,让评估者不依赖某一个开发者。
现实是,这个生态还没有成熟,公告也明确承认长期资金机制尚未确定。眼下的直接资助可以被理解为一个务实的起点,却不能被包装成独立性的证明。现在要看的,是 Accenture 能不能公开说明拿到了什么权限、哪些权限被拒绝;合同是否允许它发表不利发现;Anthropic 能不能只为安全、法律或第三方机密做必要删节,而不是删掉“这件事做得不好”。
我在《最稀缺的 AI 能力,正在变成访问权》里写过,访问权还包括审计权和责任权。放到这里,给评估者办公室和账号只是开始,关键是它能不能把看到的东西变成可追责的记录。
第二意见的价值,是允许它说“证据还不够”
Section titled “第二意见的价值,是允许它说“证据还不够””很多人想象中的“独立评估”,隐含着一个不太健康的期待:如果第三方最终说安全,那就说明公司做对了;如果第三方提出问题,那就是合作失败。
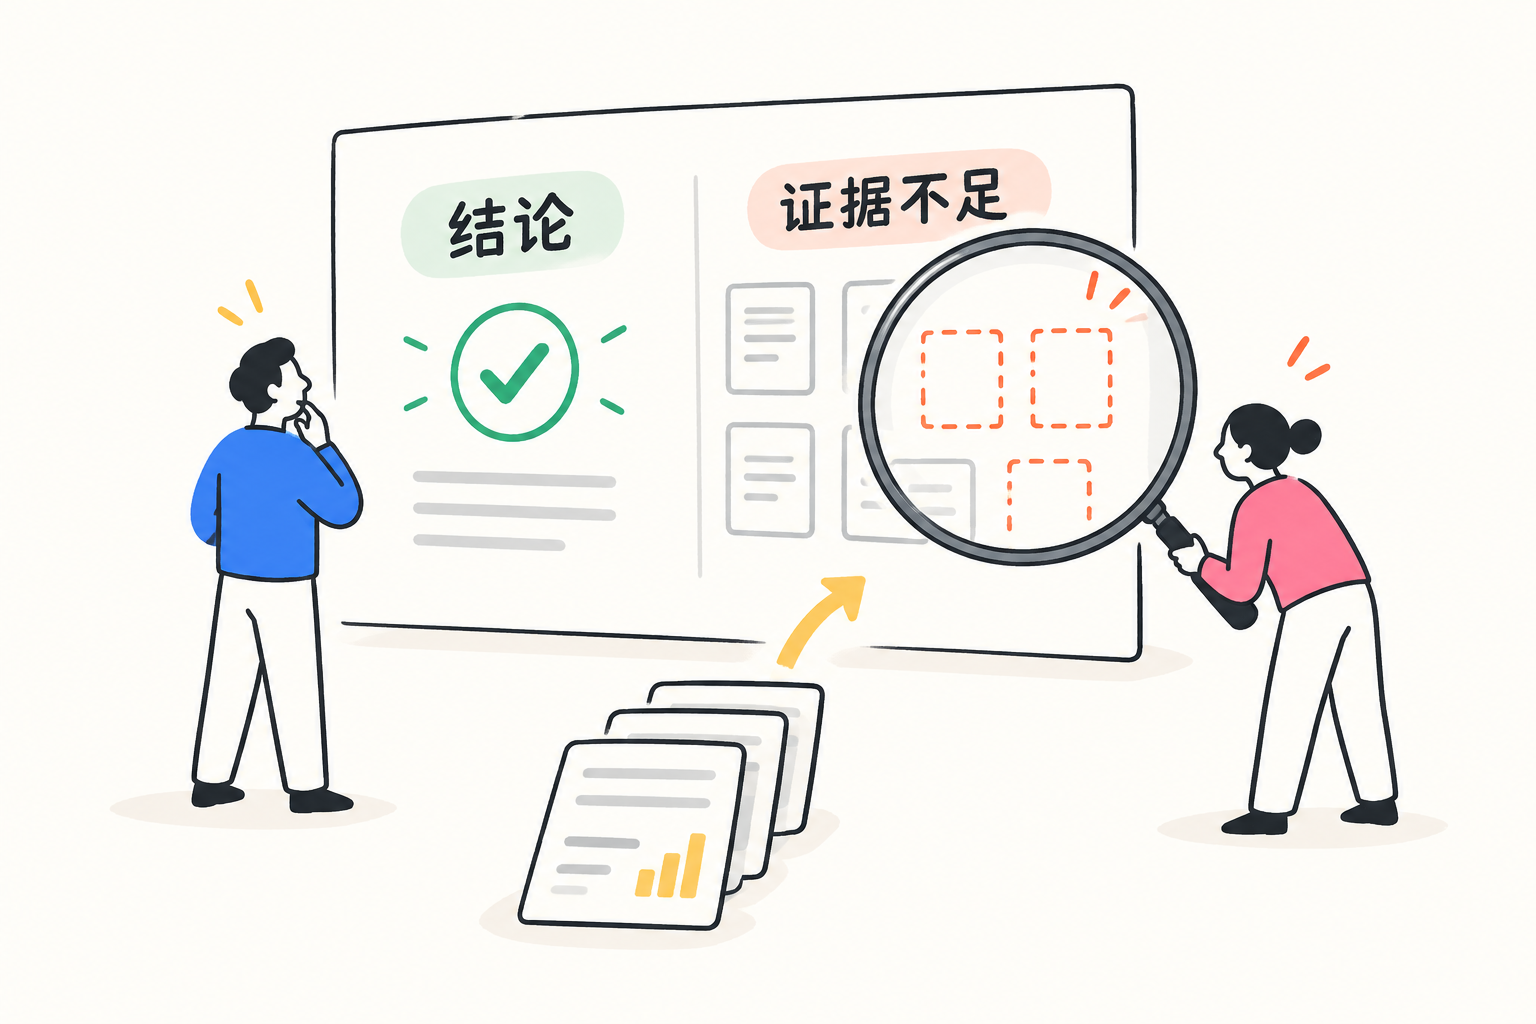
METR 的做法更具体。它在一份针对 Anthropic 2026 年 2 月风险报告的公开审查中说,原报告展示的证据不足以支撑“自动化 R&D 的灾难风险很低”这个结论,问题涉及分析严谨性、调查样本、问题粒度和信息呈现。可是,在看到额外证据之后,METR 又同意最终的低风险判断可能仍然成立。
这里的价值在于把两件事拆开:结论可能暂时没有错,证据却可能还不够。对高风险系统来说,这种拆分比一张简单的通过 / 不通过标签有用得多。
METR 的公开说明也提供了一个参照:它表示自己不接受评估工作的 compensation,主要由捐赠支持,没有接受 AI 公司的 funding,但会使用公司提供的访问权限和免费 tokens。这样的安排不自动保证每个结论都正确,却至少让“谁在付钱”“哪些资源算合作支持”成为可以讨论、可以披露的事实。
因此,我不希望 Anthropic 的评估者变成一个只负责盖章的内部顾问。一个真正有价值的评估者,应该能够说:我看到了什么、我没有看到什么、你的报告哪一段证据不足、我不同意你的地方是什么,以及你有没有回应。
我会盯住四个接口
Section titled “我会盯住四个接口”如果这项合作继续推进,我最想看到的不是更多关于“投入规模”的宣传,而是下面这些接口被写清楚。
访问接口。 评估者能看到哪些训练、部署、权限和事故记录?哪些信息因为客户隐私、商业机密或安全原因不能看?每次拒绝是否留下理由,而不是只在最终报告里写一句“受限访问”?
发表接口。 评估者能不能公开不利结论,能不能公开说明自己没有拿到什么?删节由谁决定,删节的理由和范围是否会被记录?如果“安全”只允许被公司发布,那它仍然是公司的自述。
资金接口。 合同期限、续约权、报酬、股权和其他利益冲突是否披露?评估者是否可以同时为别的 AI 开发者工作?长期是否有 pooled 或公共资金,避免每一家实验室都在挑选和养活自己的“独立”评估者?
纠错接口。 发现重大问题之后,谁有权要求复核、暂停某个部署或把问题升级给监管者?评估者和开发者意见不一致时,是否必须公开保留分歧,而不是把报告改到双方都舒服?
这四个接口也解释了为什么“嵌入式”与“外部”不是二选一。评估者需要在内部才能看到过程;资金、发表权和升级路径则要保持外部可检查。
这次合作值得支持,但不能提前授予信任
Section titled “这次合作值得支持,但不能提前授予信任”Anthropic 说,它正在和 Accenture、METR 以及其他评估者一起探索一个拥有 shared standards 的生态,而且本次合作是 non-exclusive。评估者之间可以互相复核,开发者也不能通过换一家机构来逃离更严格的问题,这比把所有安全判断交给一个合作方稳妥。
但现在还不能把这则公告读成“独立监督已经解决”。公告自己承认标准、报告方法和资金机制都在形成中;它宣布的是建设开始,不等于独立监督完成。
读完这则公告,我最后留下一个判断:embedded evaluation 的作用,不是让公众更容易相信 AI 公司,而是让公众更容易检查它为什么值得相信。
- Anthropic:Partnering with Accenture on embedded evaluation
- Dario Amodei:We Must Pace the Frontier
- Anthropic:Advanced AI Framework(June 2026 PDF)
- METR:About
- METR:Risk Assessment
- METR:Review of the “Risks from automated R&D” section in the Anthropic Risk Report
- Anthropic:Improving our alignment and security efforts
- Anthropic:Introducing the Life Sciences Verification Program
- Anthropic:Developing Enterprise Frontier Safeguards with our customers