认证之前,少给陌生人 4,500 行代码
Anthropic 在 25 个开源项目里发现 493 个攻击面问题:比修漏洞更划算的,是让不该被碰到的代码真的碰不到。难点不在模型,在谁能回答“这段代码该不该可达”。
OpenSSH 是全世界被审得最多的 C 代码之一,安全研究员反复拆解它。所以当我读到 Anthropic 这篇研究时,最刺眼的是一个更朴素的事实:在 OpenSSH 10.4 的 sshd 里,大约有 4,500 行代码,任何未认证的客户端都能走到,哪怕管理员根本没有启用它们。
这 4,500 行是 ML-DSA-44 的解析代码,一种后量子签名算法。它默认关闭,但客户端发来什么 key type,sshd 就先解析什么,解析完才检查这个类型是否被允许。代码在那里,门就开着。
Anthropic 的 Frontier Red Team 在 10 月 20 日发布了这项研究。它讲的是一类比 OpenSSH 更普遍的现象:软件的代码不是按“谁该碰到它”来生长的,而是按功能、补丁、兼容性一层层堆起来的。堆到最后,很多代码的可达性已经和最初的设计意图脱节。
这篇研究把安全防御的一个老问题翻了个面:与其问“还有多少漏洞”,不如问“哪些代码本来就不该被这些人碰到”。

默认关闭,不等于不可达
Section titled “默认关闭,不等于不可达”Anthropic 把攻击面削减分成三种方法。第一种叫默认配置分析:找出在出厂配置下可达、但不被任何默认功能使用的代码。听起来像在鸡蛋里挑骨头,但 OpenSSH 的例子说明这不是。
sshd 的逻辑是:客户端先发 key type,服务端解析这个类型对应的数据结构,然后再检查这个类型是否在允许列表里。问题在于,解析发生在检查之前。一个没有通过认证的客户端,可以让服务端去解析它根本没启用的算法。ML-DSA-44 的 4,500 行代码,就这样成了预认证攻击面的一部分,约占默认 sshd 预认证代码的 16%。
问题不在于 OpenSSH 写错了。“默认关闭”描述的是配置状态,不是可达性状态。一段代码可以既没有被启用,又仍然能被外部输入触发。这两个事实并不矛盾,只是我们平时把它们混为一谈。
OpenSSH 已经是被审计得最彻底的那一类代码。Anthropic 在原文里写了一句很重的话:如果多余的可达性能在那里活下来,它就能在任何地方活下来。
门装在哪一层
Section titled “门装在哪一层”Anthropic 把这个发现报告给了 OpenSSH 维护者,并附上补丁。10.5 把检查挪到了解析之前。故事到这里本来可以结束,但 Claude 又往下看了一眼。
它发现 10.5 的检查有两个缺口。第一,检查看的是客户端“声称”的算法名,而真正决定用哪个解析器的,是 key blob 里内嵌的 type string。客户端可以声称自己是 ssh-ed25519,通过检查,然后发一个 ML-DSA key 让服务端解析。第二,证书路径没有被同样的检查覆盖。证书的 key type 默认启用,sshd 会在查询配置之前反序列化证书里的 CA 公钥,并跑完整的签名验证。
换句话说,第一次修复把门从走廊尽头挪到了走廊入口,但门只检查访客报的名字,不检查他包里带的东西。最后的修复把检查放进了 parser 内部:key type 和 CA 签名算法都要在反序列化或验签之前,和配置的允许列表比对。这次修复移除了大约五分之一原本可被未认证客户端触达的 OpenSSH 代码。

这个细节把一个抽象原则变得很具体:检查要放在解释数据的那一层。在调用方做检查,你信任的是调用方对数据的描述;在解析器里做检查,你面对的是数据本身。只要中间隔着一层编码、一层转换、一层协议,调用方的描述就可能和实际内容不一致。
这条规则不限于 SSH。任何“先解析、后校验”的代码路径都值得看一眼:JSON 反序列化、图片解码、协议握手、序列化框架、配置加载。攻击面往往不在业务逻辑里,而在业务逻辑之前的那一层解释器里。
OpenSSH 在 10 月 6 日发布的 10.6 release notes 里确认了这项改动,措辞很克制:把 key 和 CA 签名类型的检查尽早放到解析阶段,与允许列表比对,从而减少被禁用算法带来的攻击面。notes 开头还有一段:他们收到大量 AI 生成或 AI 辅助的报告,并且发现有些被 AI 找到的 bug 后来又被另一名研究者独立发现。不报告漏洞的攻击者,很可能也能找到它们。所以 OpenSSH 决定更频繁地发版。
三种方法,其实是同一张地图
Section titled “三种方法,其实是同一张地图”第二种方法是配置交互:找出单独看都合理、组合起来却出问题的配置对。第三种是早期可达性:找出在认证之前、无需受害者交互、或在协议状态机转换之前运行的安全敏感代码。
三种方法听起来不同,问的却是同一个问题:谁,在什么阶段,能到达哪段代码。
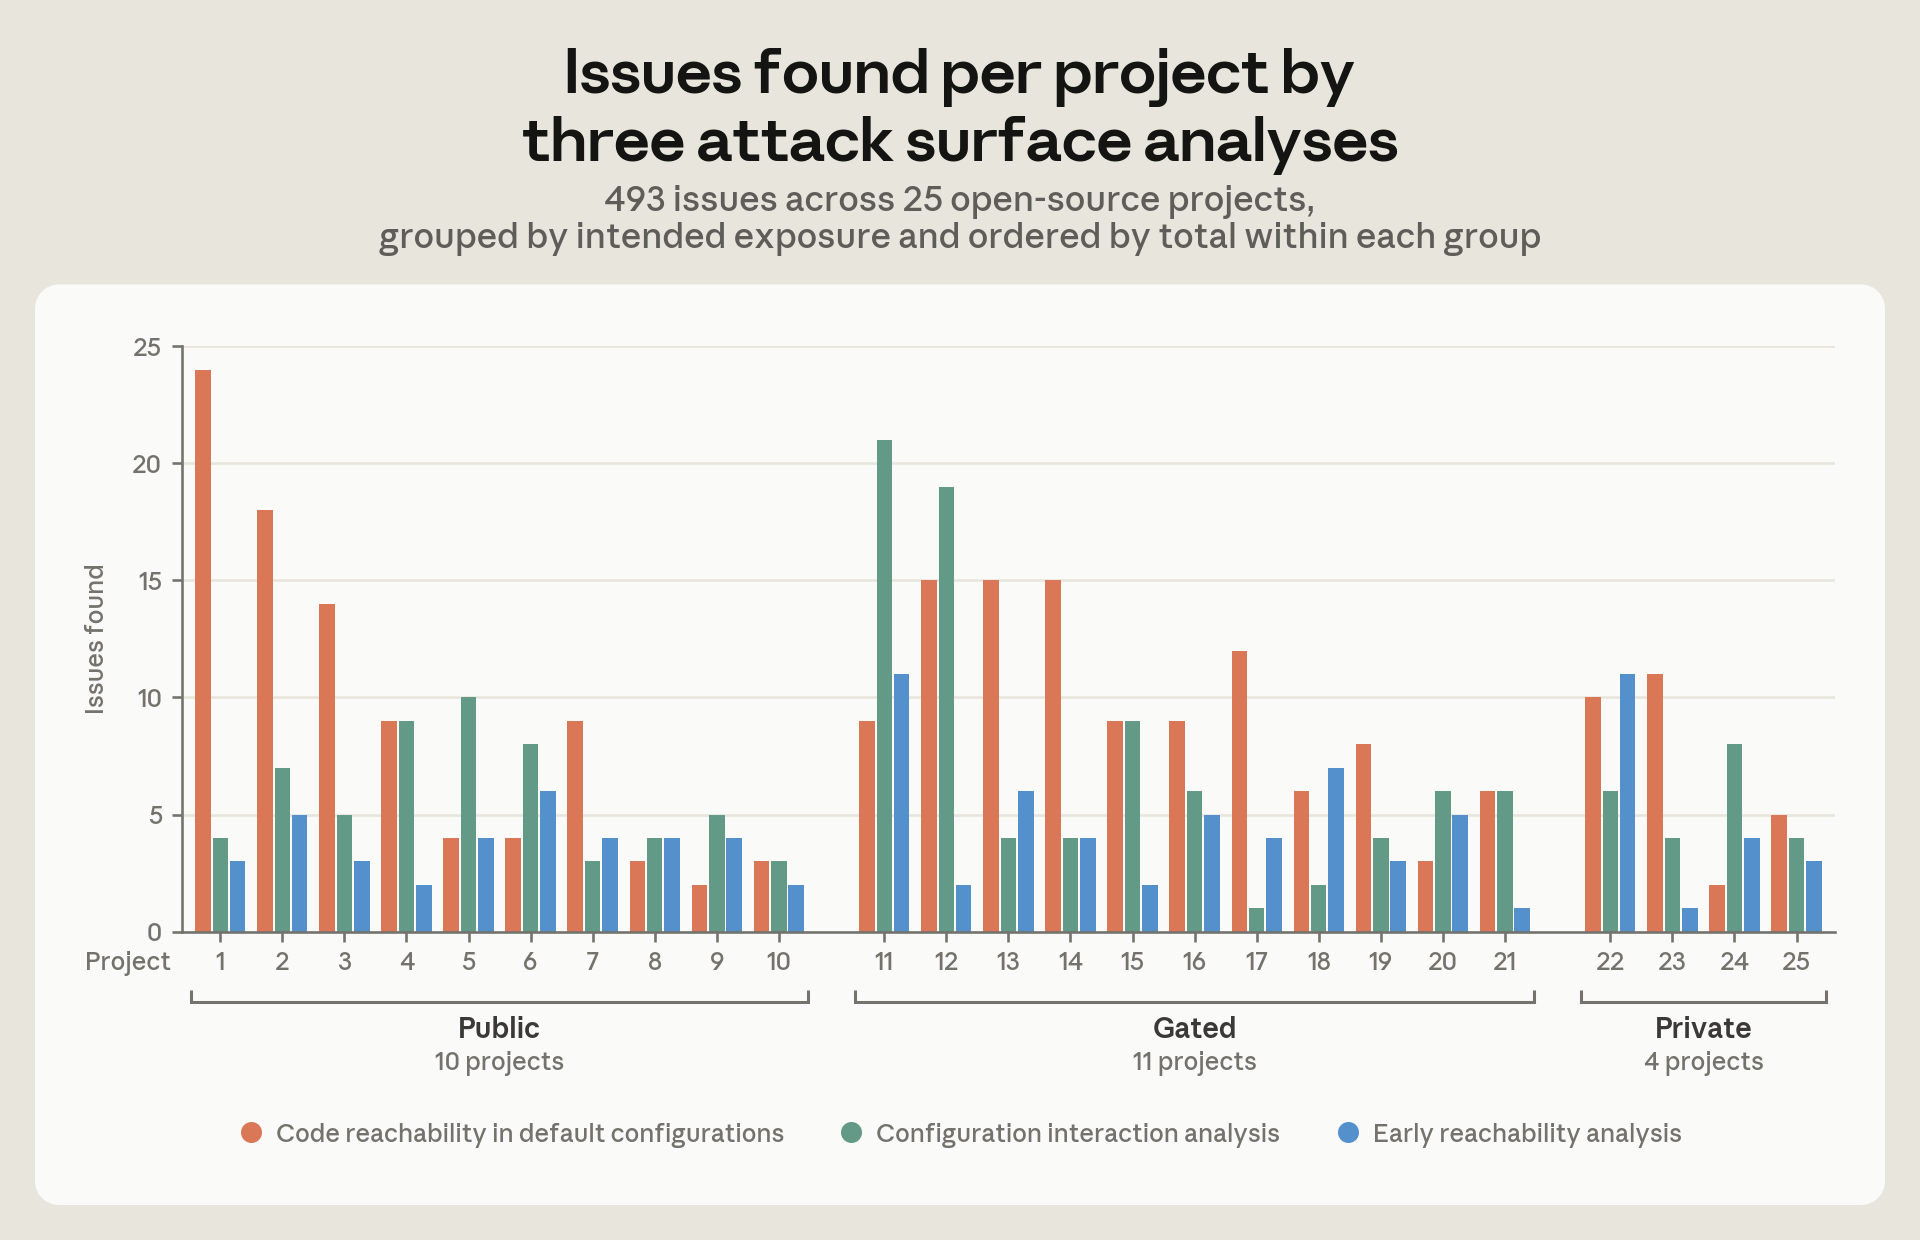
Anthropic 在 25 个开源项目、超过 500 万行代码上跑了这三种分析,建了 17,000 多个配置选项的清单,其中 3,842 个与安全相关,最后发现 493 个问题。项目分成 Public、Gated、Private 三类。最值得看的是 11 个 Gated 项目:它们本该先认证再提供服务,但每一个都有非预期可达的代码。具体数字是 93 个默认配置下多余的预认证面、37 处认证前执行或记录状态的位置、61 个静默削弱预认证控制的配置组合。
Anthropic 的分布图把这些发现按项目和类别拆开。这些数字不是漏洞数。它们大多不是立刻可利用的漏洞。原文的说法是,这些发现单独来看都不会立刻可被利用;它们增加的是攻击面,是攻击者可以试探的入口数量。
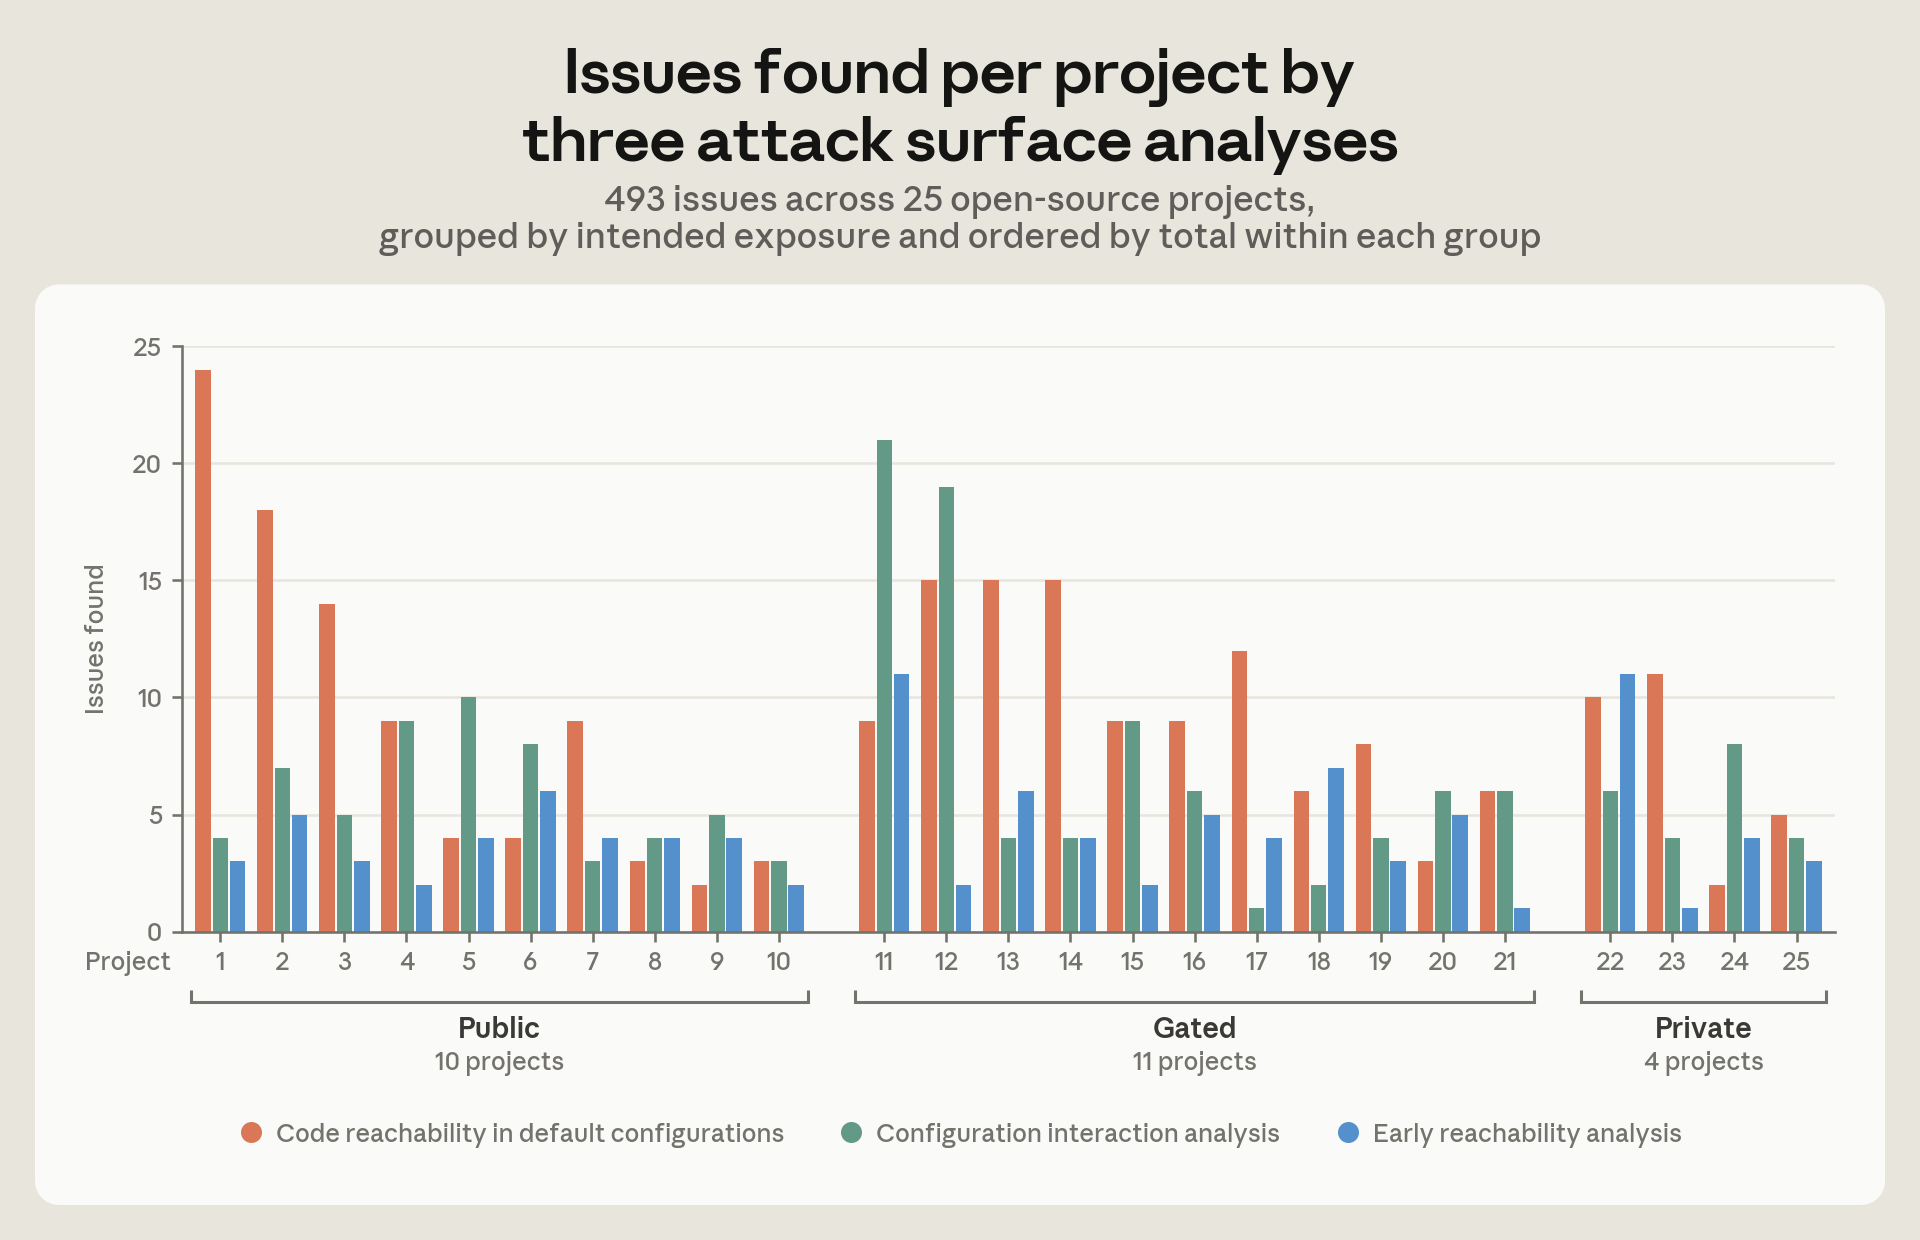
这些数字也来自 Anthropic 自己的项目选择,样本不是随机抽样;493 个发现里有多少被维护者确认、误报率是多少,原文没有给。把它当作“方法可行”的证据,别把它当成“行业平均攻击面”的统计。
不过两种方法的区别是清楚的。漏洞扫描问的是“这里有没有一个可以被利用的 bug”;攻击面分析问的是“这里为什么会被一个不该到这里的人走到”。漏洞扫描找的是一个点,攻击面分析画的是一张面。点的数量谁也说不清,面的形状却能画出来。
配置不是代码,是一份没人重读的合同
Section titled “配置不是代码,是一份没人重读的合同”配置交互的问题更像考古。
Anthropic 找到 162 个安全相关的配置组合,它们被接受时既没有报错也没有警告,文档也没有说明组合后的预期行为。其中 94 个组合会静默关闭一个安全控制,另外 68 个是同一安全机制内部的不一致。
有一个模式在四个互不相关的项目里独立出现:管理员用 hostname 或通配符写了一条拒绝规则,而不是用 IP。客户端连上来时,服务端拿这条规则去比对客户端的主机名。但服务端能不能知道主机名,取决于另一个控制反向 DNS 查询的选项,而大多数项目把这个选项关着。查询关着,服务端只有 IP,于是它拿 hostname 模式去匹配一个 IP 字符串。hostname 模式永远匹配不上 IP,拒绝规则永远不触发,名单 fail open。
文档里通常会说“hostname 规则依赖 DNS 查询”,但没有一个项目写明“这样写的拒绝名单会 fail open”。这两句话的差别很大:前一句是一个前置条件,后一句是一个安全后果。
还有一个更极端的例子:一个项目里,管理员可以要求每个客户端用证书证明身份;另一个选项本来只是想把这项检查推迟到需要的时候,结果却把检查完全关掉了。一个配置为“只接受可信客户端”的服务器,实际上会接受任何人的连接。两个选项可以同时被接受,没有警告,文档也没有提到证书要求被丢弃。这个组合在软件里存在了 21 年。
21 年。这期间不是没人看这份配置,只是没有人把这两个选项放在一起看。

配置的问题在于,它看起来像代码,实际上更像一份合同:每个选项是一个条款,写的时候都合理,但没有人负责检查条款之间的冲突。软件越长越大,选项越加越多,写选项的人和组合选项的人往往不是同一批人,甚至不是同一个团队。配置交互分析的价值,就是替这份合同做一次条款冲突审查。
模型能画出可达性,画不出意图
Section titled “模型能画出可达性,画不出意图”Anthropic 把三种方法封装成了一个 Claude skill,正在整合进 OSS-Scanner。skill 跑三遍,每遍从空的 context window 开始,只带上上一遍的少量上下文。每一遍都先建入口点清单,再用动态 trace 确认发现。
默认配置这一遍,skill 会设计并实现一个 gate,然后要求修改后的构建通过项目自带的测试套件和黑盒回归套件,且默认行为不变。任何会改变非默认配置的 gate,都留给人类决定。
这个设计很克制。模型可以告诉你“这段代码在默认配置下可达”,但它不能替你决定“这段代码该不该可达”。前者是观测,后者是意图。
于是瓶颈换了位置。以前我们缺的是发现漏洞的能力;现在发现能力正在变便宜,缺的是有人能回答“这个功能到底该不该暴露给未认证用户”“这个 legacy 选项还有没有客户在用”。这些问题不在代码里,在维护者的脑子里,在工单和合同里。
我在五月写过一篇关于 Anthropic 漏洞披露的文章,当时的结论是:发现漏洞已经可以并行化,瓶颈转移到了验证、分类和修补。攻击面削减看起来绕开了这个瓶颈。它跳过单个漏洞,直接把整片代码挪走。但它没有消灭瓶颈,只是把队列换了一个名字:以前问“谁来修这个 bug”,现在问“谁有权说这段代码不该可达”。
这个队列可能更长。修一个 bug 有明确的完成条件;判断一段代码该不该可达,往往要跨产品、运维、兼容性和客户承诺。模型可以把可达性画得很清楚,但意图地图得由组织自己提供。

还有一个边界:动态 trace 能证明“可达”,不能证明“不可达”。一次干净的扫描,只说明这次没有找到路径,不说明门已经关好。原文自己也说,这些技术只是攻击面削减可能性的一小部分。
回到 OpenSSH。真正让我不安的是这 4,500 行代码出现的位置:在一个被反复审计的项目里,一段默认关闭的实验性代码,仍然在预认证阶段被陌生人碰到。Anthropic 的结论是:如果多余的可达性能在那里活下来,它就能在任何地方活下来。
这也解释了为什么攻击面削减在现在这个时间点上有意义。过去一年,Anthropic 的一系列研究指向另一件事:模型发现和利用漏洞的能力在快速上升。Mythos Preview 在 Firefox 的测试里开发出 181 次可用 exploit,而 Opus 4.6 在数百次尝试里只有 2 次;Anthropic 判断 Mythos 级能力会在 6 到 12 个月内广泛可用。
如果这个判断成立,攻击者变快只是时间问题。防守方至少有两种反应:比他们更快地发现和修补,或者让他们即使发现了也走不到。前一种反应要求你赢下一场速度竞赛,后一种反应换了一条赛道。攻击面削减属于后者。
它得被当成一种需要维护的习惯。一次扫描不够。配置会继续增加,功能会继续堆叠,默认值会继续漂移。今天关掉的门,下一个版本可能又被某个新选项打开。那 21 年的证书冲突和四个项目里重复出现的 hostname 规则,都在说明同一件事:可达性债务是静默累积的,不会自己消失。
攻击面削减最后留下的,大概是一份更短的“必须暴露”清单。这件事没有完成的那一天,只能一个版本一个版本地关。
下次做安全评审,除了问“我们修了哪些漏洞”,也可以问一句:有哪些代码,本来就不该让陌生人走到?这个问题的答案不在漏洞列表里,得去问写代码和运维的人。
- Anthropic, “Using Claude to reduce the attack surface of code”, 2026-10-20. https://www.anthropic.com/research/attack-surface-reduction
- OpenSSH 10.6 release notes, 2026-10-06. https://www.openssh.org/releasenotes.html
- Anthropic, “Assessing Claude Mythos Preview’s cybersecurity capabilities”, 2026-04-07. https://www.anthropic.com/research/mythos-preview
- Anthropic, “Measuring LLMs’ ability to develop exploits”, 2026-05-22. https://www.anthropic.com/research/exploit-evals
- Anthropic, “Launching an opt-in vulnerability-finding service for open-source software”, 2026-10-08. https://www.anthropic.com/research/launching-opt-in-vuln-finding-service-for-open-source
- 站内旧文(2026-05-28). https://ntlx.github.io/articles/anthropic-disruption
- 原文配图 “Issues found per project by three attack surface analyses”. https://www-cdn.anthropic.com/images/4zrzovbb/website/eda2a0d63ec94b4698edb7b2989ea6c520a2928c-1920x1240.png