Linear 把 CI 改造的结果写在几组数字里:PR 每次运行的测试增至 3.7 倍,每项测试的机器时间减少 46%。总览图标注 PR 等待下降 12%,正文则说等待从 6 分钟以上降到略高于 5 分钟。
这些数字对应不同指标,我没有把它们合成一个“提速率”。读完改造记录,我更在意的是他们先后做了什么:先减掉工作流里重复的准备,再增加并行度。

CI 有两本账:排队时间与机器时间
Section titled “CI 有两本账:排队时间与机器时间”一个 PR 多久拿到检查结果,描述开发者等了多久;整套 workflow 消耗多少 runner 时间,描述机器为这些反馈做了多少工作。把任务并行展开,可能缩短最慢检查的等待,却也会增加 runner 的启动、checkout、依赖安装。
Linear 写道,shard 数翻倍,workflow 花在 setup 上的时间也会翻倍。我读到这句时,才把“多开几个 shard”从单纯的提速按钮,改看成一项要先算成本的选择。PR 等待和 runner 用量得放在同一张账上,不能只看哪个 job 最先结束。
每个 shard 越轻,加并行才越划算
Section titled “每个 shard 越轻,加并行才越划算”Linear 先整理每个 job 会重复做的准备:API 工作流只安装 API 包及其依赖,共用依赖预装进 CI 镜像。每 shard 的 setup 从 110–140 秒降到 67–73 秒,约减少 44%。
他们也检查了缓存是否真的划算。node_modules 即使命中缓存,恢复也要约 28 秒;过滤安装约 7.5 秒,所以这个配置里重装更快。缓存写入、读取和失效都占时间,不能只看命中率。
同一种思路也用在工具链上。Linear 把依赖类型信息的几条自定义 lint 规则改为 AST 静态分析,之后迁移 Oxlint 就容易一些;他们还把 TypeScript 检查改用 tsgo。具体工具要按代码库衡量,我从中看到的是先找每次 CI 都会重做的工作,再判断哪些真的需要重做。
共享状态可以省时间,也会带来正确性责任
Section titled “共享状态可以省时间,也会带来正确性责任”准备工作变轻以后,Linear 才把 API 测试从 4 个 shard 增到 8 个。原图标注优化前 4 个 shard 共花 8.3 分钟做 setup,优化后 8 个 shard 共花 7.5 分钟。作者报告初始 benchmark 中关键 job 快了约 19%,成本也低了约 19%。这是 Linear 的数字,足以说明他们的分片能负担更多并行测试,无法替别的团队估算收益。
Vitest 默认让测试文件在多个 worker 中并行,每个文件使用独立环境;worker 越多,CPU 和内存用量也会上升。官方并行指南写得很清楚。Linear 为明确安全的文件启用 isolate: false,让同一 worker 里的测试共享模块状态。每个文件要显式 opt-in 并补上 teardown;用了 fake timers 或状态关系理不清的测试,仍留在隔离项目。
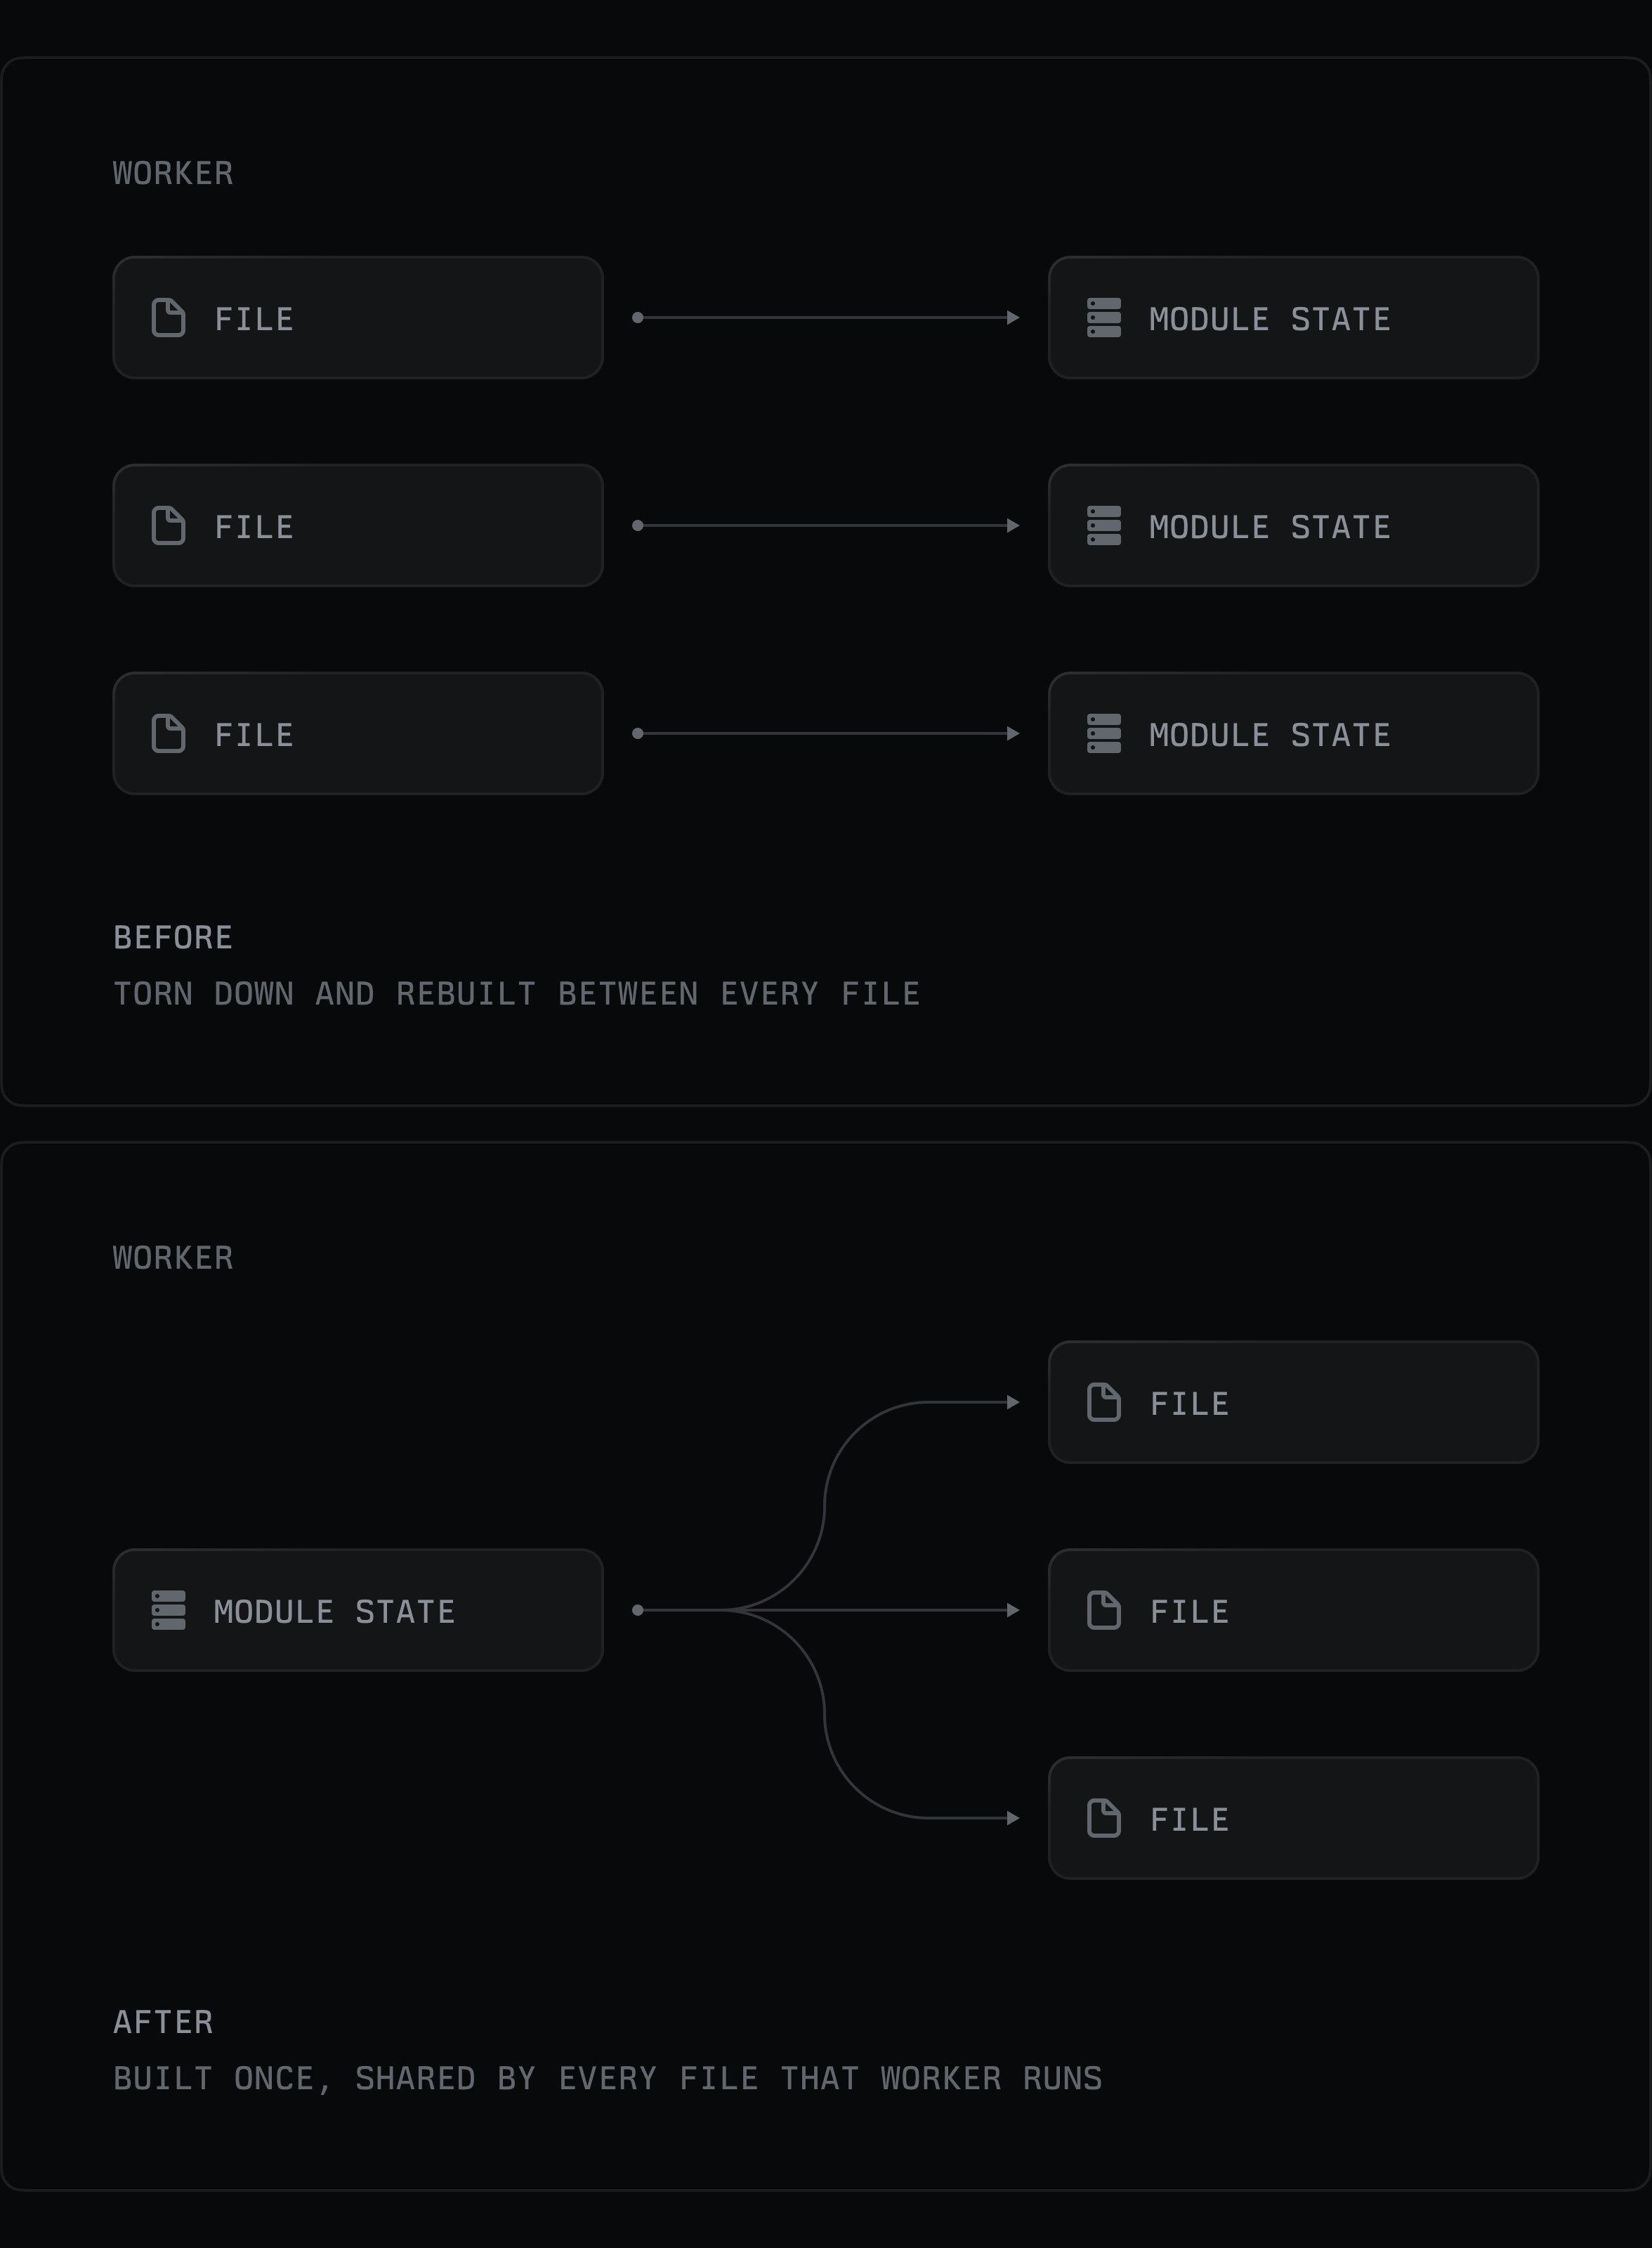
这项改动很省时间,也最容易出错。关闭隔离只适合不依赖副作用的代码,Vitest 的 isolate 配置也保留了这个条件。Linear 把它作为局部选择,并没有全仓打开。
小任务也会挡住整条关键路径
Section titled “小任务也会挡住整条关键路径”Linear 有八个 API 测试 shard,都得等变更检测和缓存检查结束才能开始。一个任务本身即使很短,只要站在所有测试之前,就会拖住整个 PR。他们把 cache marker 的写入移出合并门槛,改在测试结束后运行;每个 API PR 和 merge-queue entry 因而少等约 42 秒。
我之前写过两篇相邻题目:读Bun 的 Rust 重写时,我注意测试套件能否脱离实现语言继续验证行为;读Anthropic 的测试影响分析重构时,我关心 listener 的结果是否及时进入 selector。Linear 这篇把视线拉到执行成本:测试选对之后,也要尽快跑完,并让每次反馈的机器用量保持可负担。
如果我来改一条 CI 流水线,会先把必需检查的等待时间与整套 runner 用量并排记录,再标出每个 shard 重复做了哪些准备。增加并行度之后,还要重新看最慢的检查有没有缩短,并守住测试隔离要求。Linear 的做法让我觉得,分片数应该由这些账目来决定。