长任务的 token 成本,得从重复上下文算起
长任务降本不只是删短提示词,还要让稳定信息可复用、低频工具按需出现,并把委派与质量一起计入成本。Cursor 报告这组改动使用户 token 成本下降 7%,但这个数字不是所有 Agent 都能照搬的保证。
Cursor 在这篇研究文章中报告,一组 harness 改动让用户 token 成本下降 7%,且没有降低 Agent 质量。对我来说,这个数字的来处比数字本身更有意思:长任务每轮请求都带着一段累积的上下文,harness 可以决定其中哪些始终保留、哪些需要时再找、哪些可以复用。
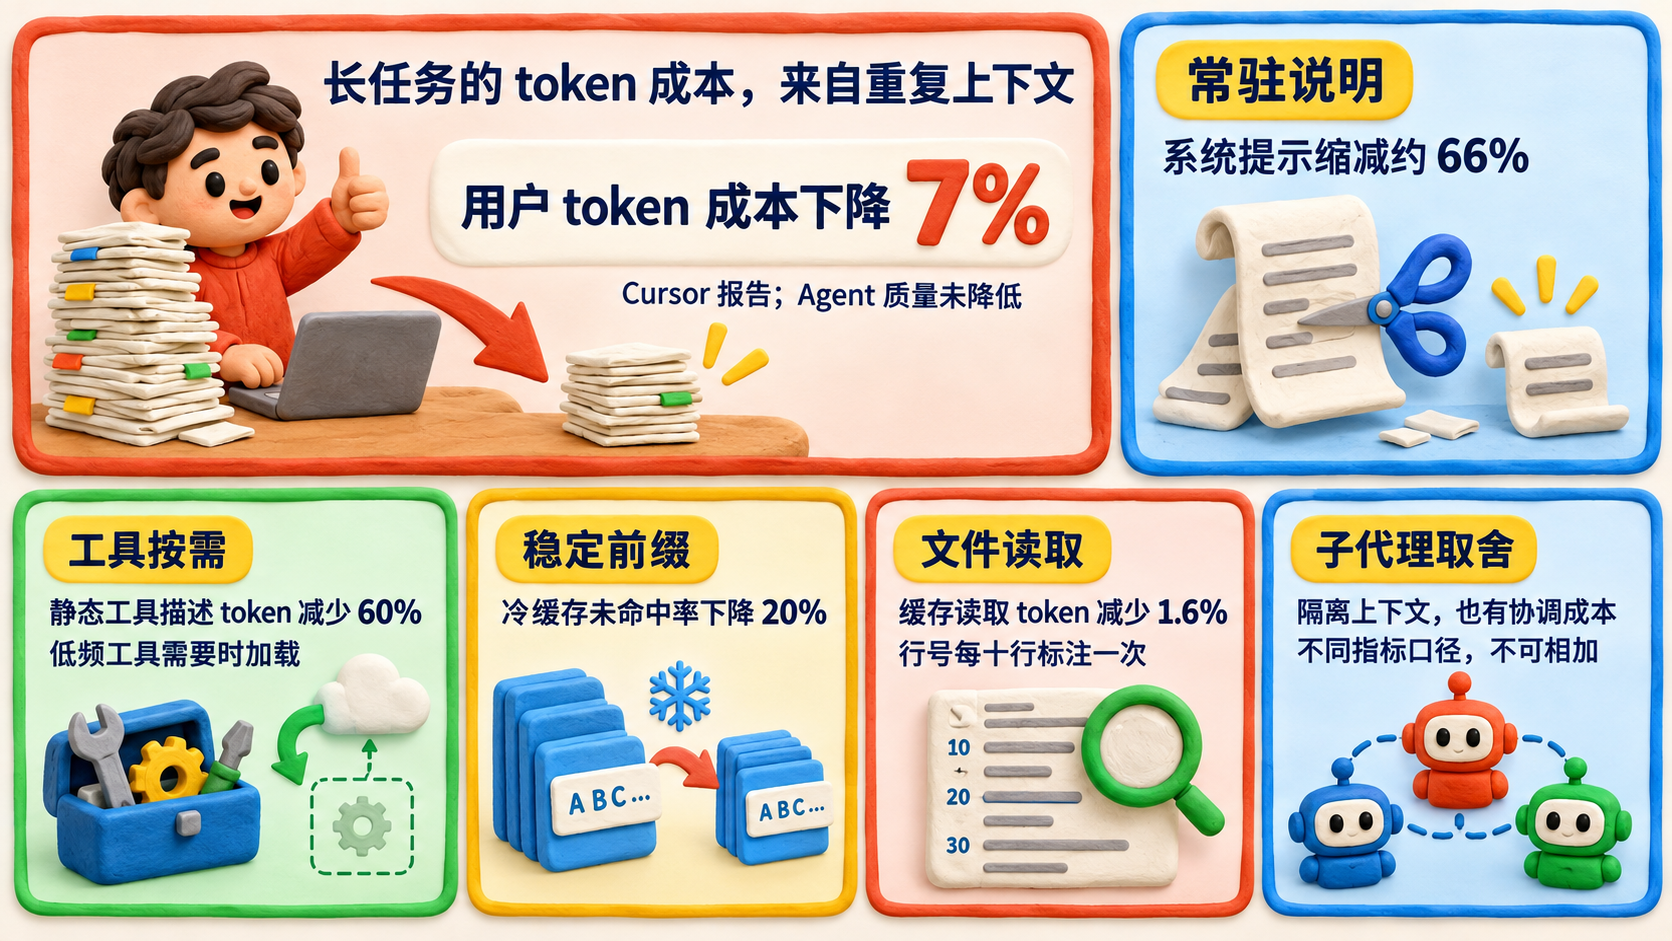
7% 不能和其他百分比放在一起加总
Section titled “7% 不能和其他百分比放在一起加总”文章给出的数字需要分开读。Cursor 报告组合改动带来 7% 的用户 token 成本下降;系统提示缩短约 66%;静态上下文中的内置工具描述 token 减少 60%;冷缓存未命中率下降 20%;文件行号调整后缓存读取 token 减少 1.6%。这些指标各有自己的对象,不能当作五项可相加的节省。
另有一个来自更早 MCP 工具改造的 46.9%,指的是实际调用 MCP 工具的运行中,总 agent token 的变化。它与本篇内置工具描述减少 60% 的结果来自不同实验,分母也不同。两个数字都涉及 token 成本,回答的问题却不一样。
提示词短了多少、缓存未命中变化多少、整段工作的花费下降多少,说的不是一回事。把它们放在同一张省钱账单里,反而会看不清每项改动的实际效果。
常驻说明和低频工具需要不同的入口
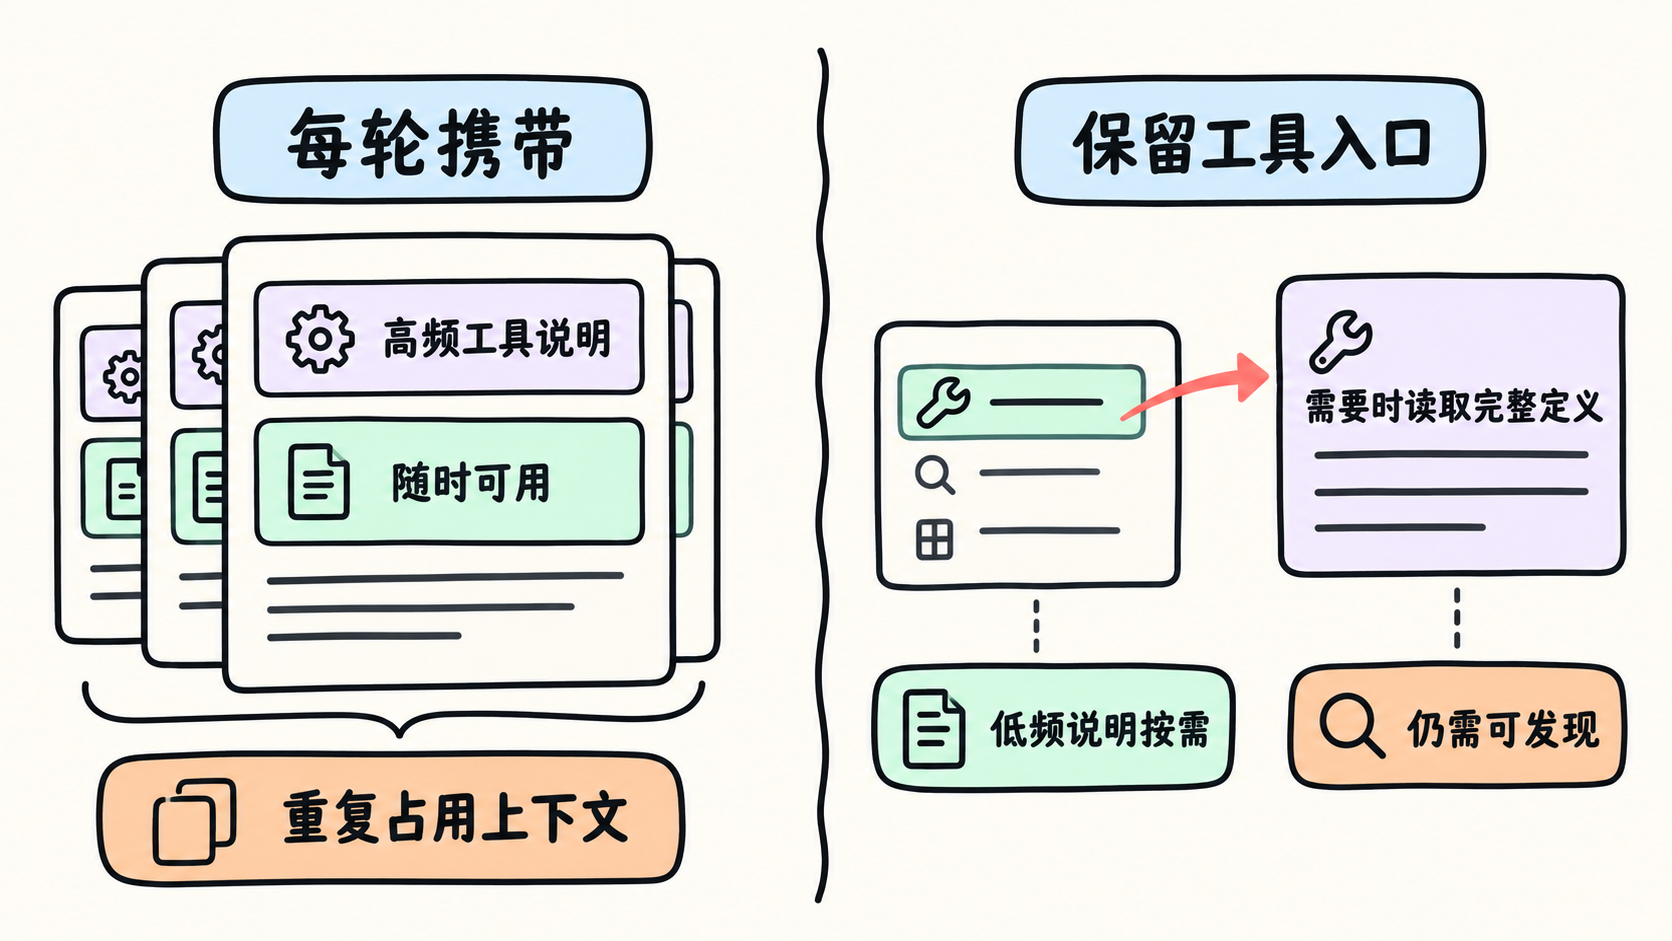
Section titled “常驻说明和低频工具需要不同的入口”Cursor 的一个判断是,模型能力提升后,过去逐条说明怎么用工具、怎样管理任务的长提示词,有些已经不需要每轮重复。它报告系统提示缩短约 66%。工具定义也类似:文章说多数内置工具单项只在少于 20% 的会话里被需要,于是将一部分改为按需加载,同时保留高频工具在静态上下文里。
上下文短一些,不代表所有工具都应该移出静态区。模型得先能发现低频工具,过度精简的指令也可能让少数任务失去必要提示。Cursor 把入口和完整定义拆开:模型知道有这项能力,遇到相关工作时再读取细节。
这让我想起本站此前的《模型变强之后,提示词该从哪里退场?》。那篇讨论哪些规则可以从常驻提示词搬到按需接口。Cursor 这次把问题推到了运行成本:工具说明如何进入每轮请求,也会影响后续哪些前缀能够被缓存复用。
缓存省的是重复处理,前提是前缀保持稳定
Section titled “缓存省的是重复处理,前提是前缀保持稳定”长对话每轮都要带上此前的工具、系统指令、任务设置和交互历史。请求开头若长期不变,模型服务可以把它作为可复用前缀;稳定说明若和临时设置混在一起,缓存就不容易命中。Cursor 在较稳定的工具与系统层后面放置断点,再把会变化的任务环境信息和对话历史放到后续位置。它报告这项调整使冷缓存未命中率下降 20%。
原文的缓存断点图展示了这种分层:工具和系统说明放在稳定前缀中,断点标出它的末端,之后才是可能变化的任务环境信息与对话历史。OpenAI 的Prompt caching 文档也把断点解释为可保存、供后续请求复用的 prompt 前缀边界。请求仍然包含历史,缓存让稳定部分不必每次都从头处理。
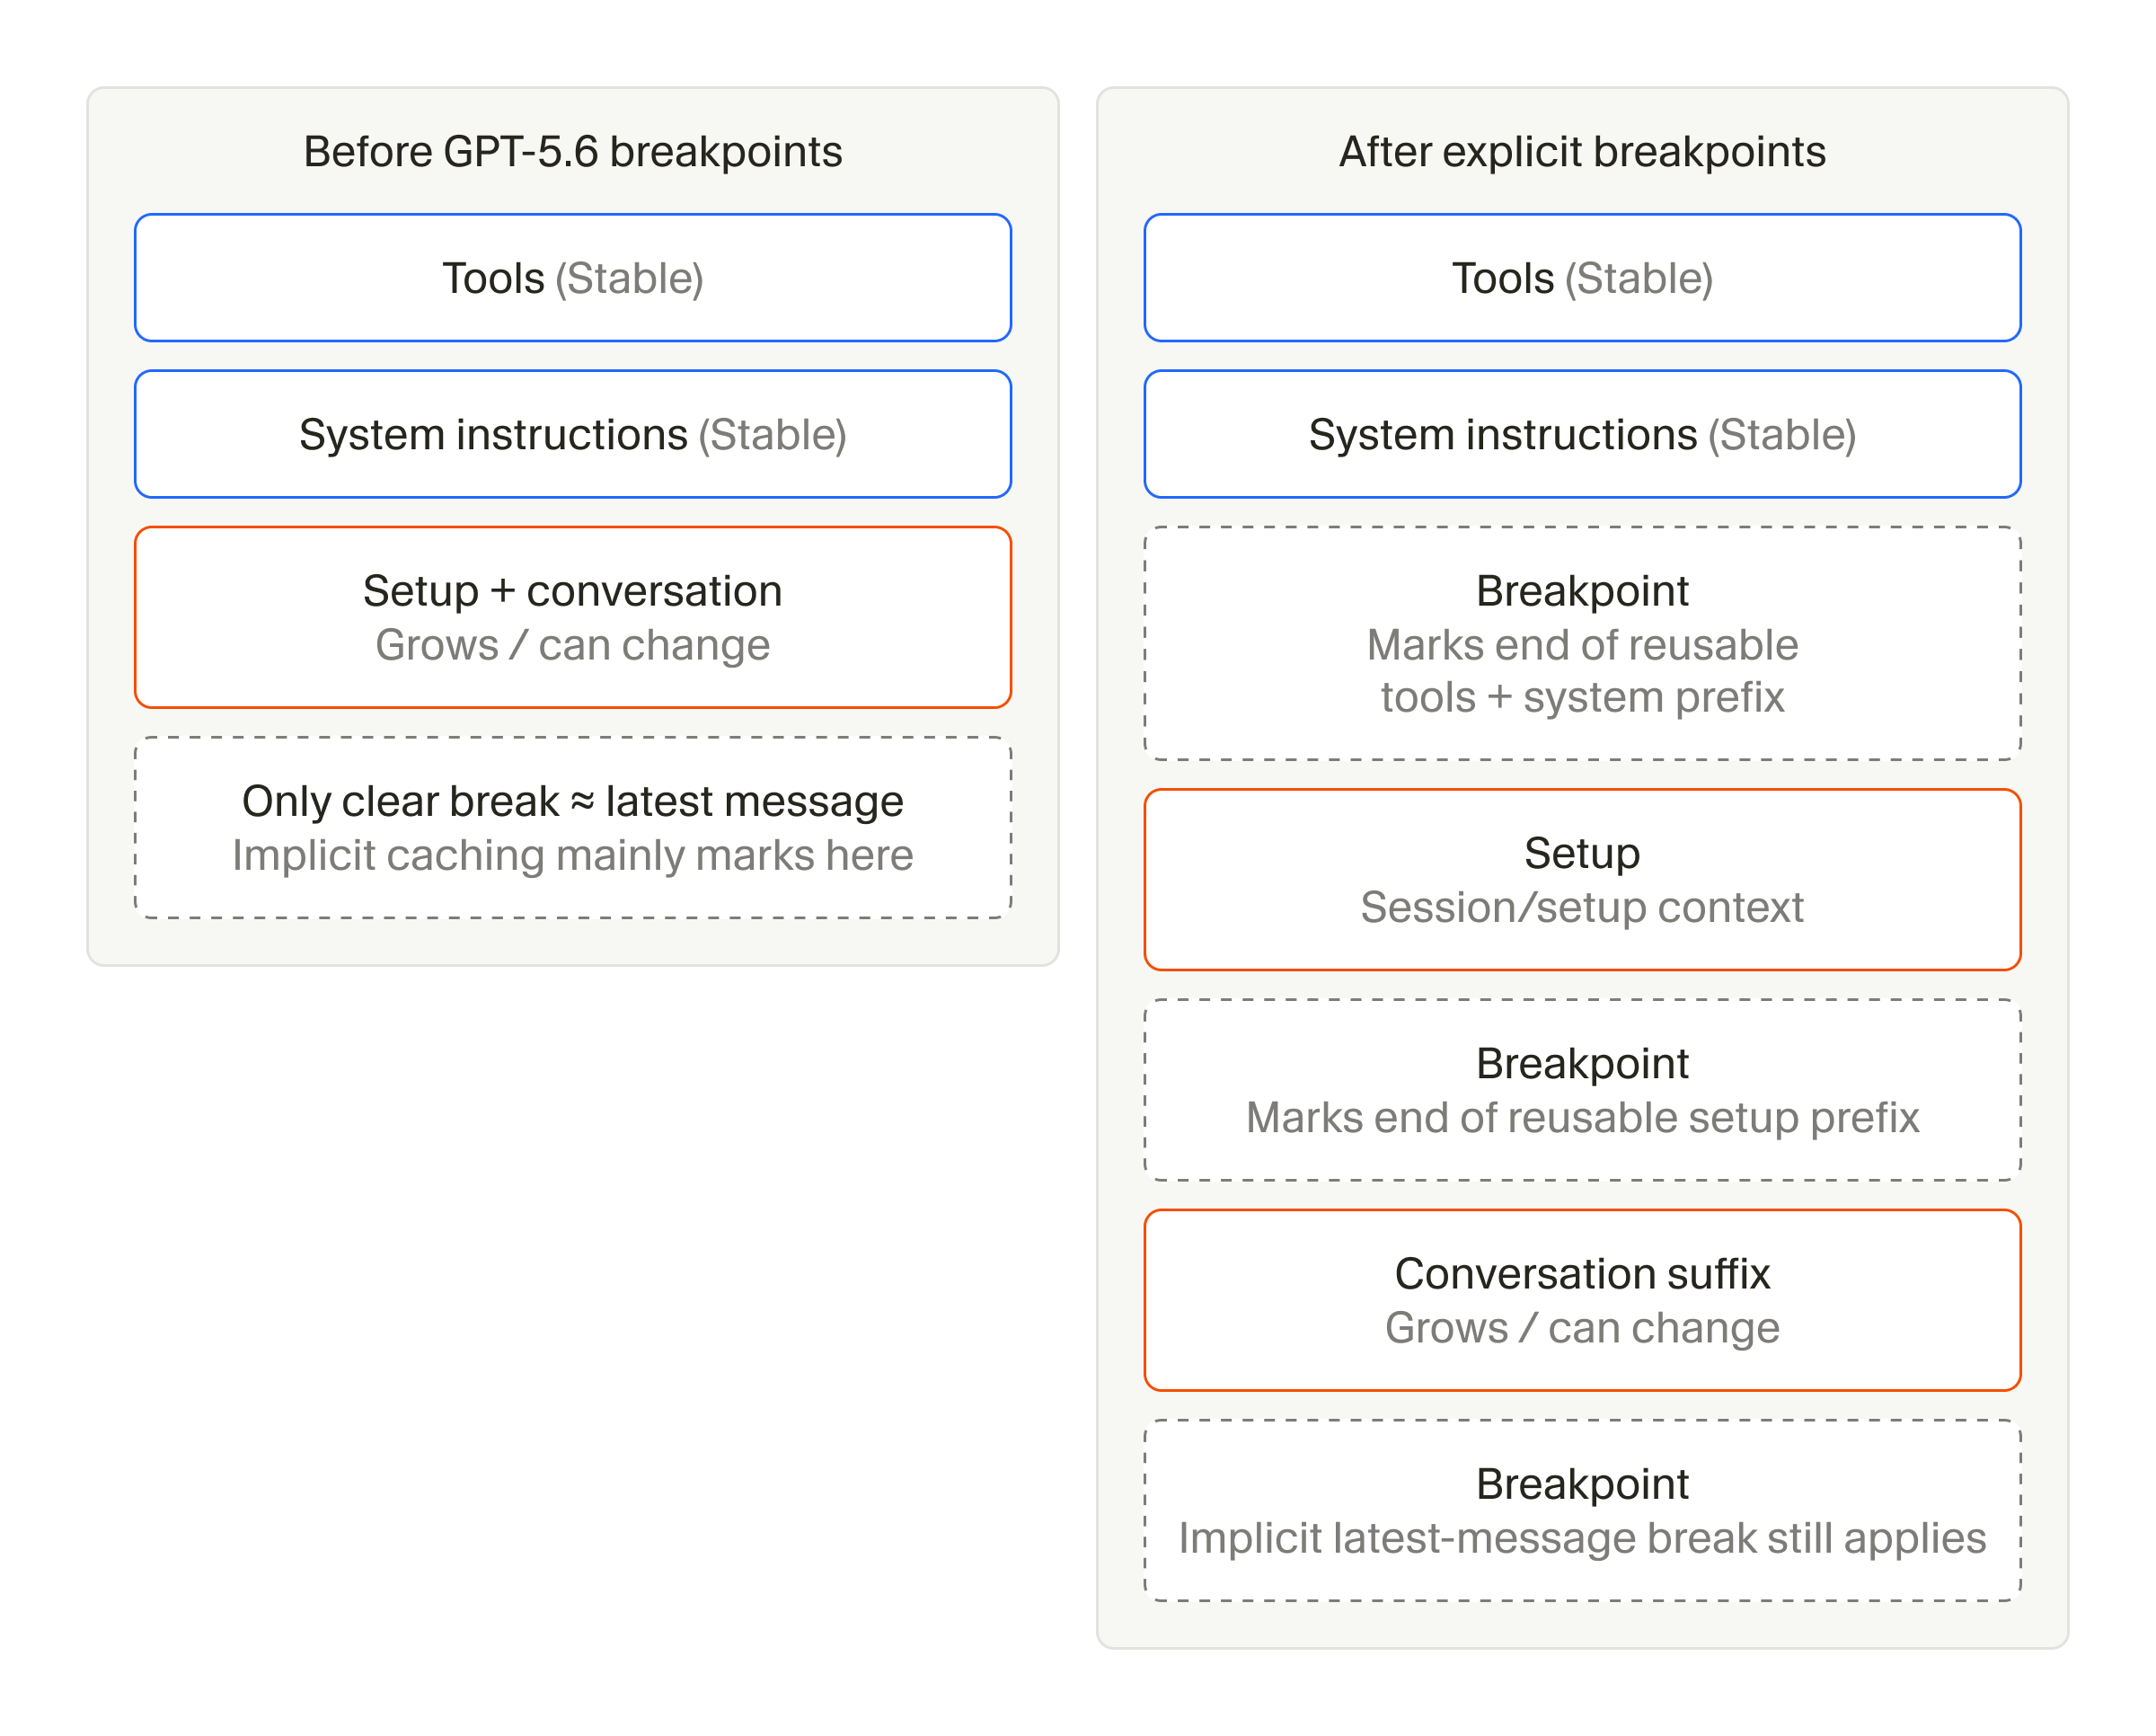
缓存能否发挥作用,先看内容是否稳定、边界是否放对。按需加载也会改变缓存前缀:低频工具不再挤进每轮请求,稳定的工具和系统说明就更容易保持一致。
token 降了,还得确认任务没有变差
Section titled “token 降了,还得确认任务没有变差”另两项改动提醒我,长任务的成本还藏在上下文之外的细节里。Cursor 将文件读取的行号改为每十行标注一次,报告 cache-read token 减少 1.6%,且没有降低质量。使用子代理则能让子任务从新的上下文窗口开始,但父子 Agent 之间可能重复探索、沟通也会增加额外工作量。省下的上下文并不总等于省下了整个任务的成本。
Cursor 说线上 A/B 测试会观察 token、成本、延迟、工具调用错误和总体使用情况。只看 token,工具调用变少但失败更多、任务耗时变长,也会被误报成优化。站内《Not the Model, You’re the Harness》讨论过工具、状态和执行环境组成的 Agent 外部系统层;Cursor 这篇文章把其中几项设计选择具体落到了请求成本上。
7% 是 Cursor 对自家组合改动的报告,不能当成所有 Agent 都能取得的结果,也不能据此判断某一项工具加载或缓存策略单独贡献了多少。评估长任务时,我会看完成一件工作消耗了多少输入与输出 token、花了多少时间、出现多少工具错误,以及交付结果是否可用。
我会从每轮请求开始检查:哪些定义一直重复,哪些工具很少用,哪些内容读入后又被压缩或转交。token 数下降只能说明一项成本变了;把它与任务质量、延迟和工具错误一起看,才能判断一项改动该不该保留。