省下 token 之前,先消灭 Agent 的回头路
有一种降本很容易让人产生错觉:把某个工具的输出砍掉一半,仪表盘上的 token 立刻好看起来。
但如果 agent 因为少了一条关键信息,又把原始输出读一遍、把命令跑一遍,账单只是绕了一圈回来。GitHub 最近写了一篇 Copilot 工程复盘,谈的正是这个问题。它没有把“更省”定义成更短的回复,而是看一项任务从开始到完成,究竟走了多少弯路。
读到这里,我对“token 优化”的理解变了:token 是账本,应该先找出 agent 不得不重复做的工作。
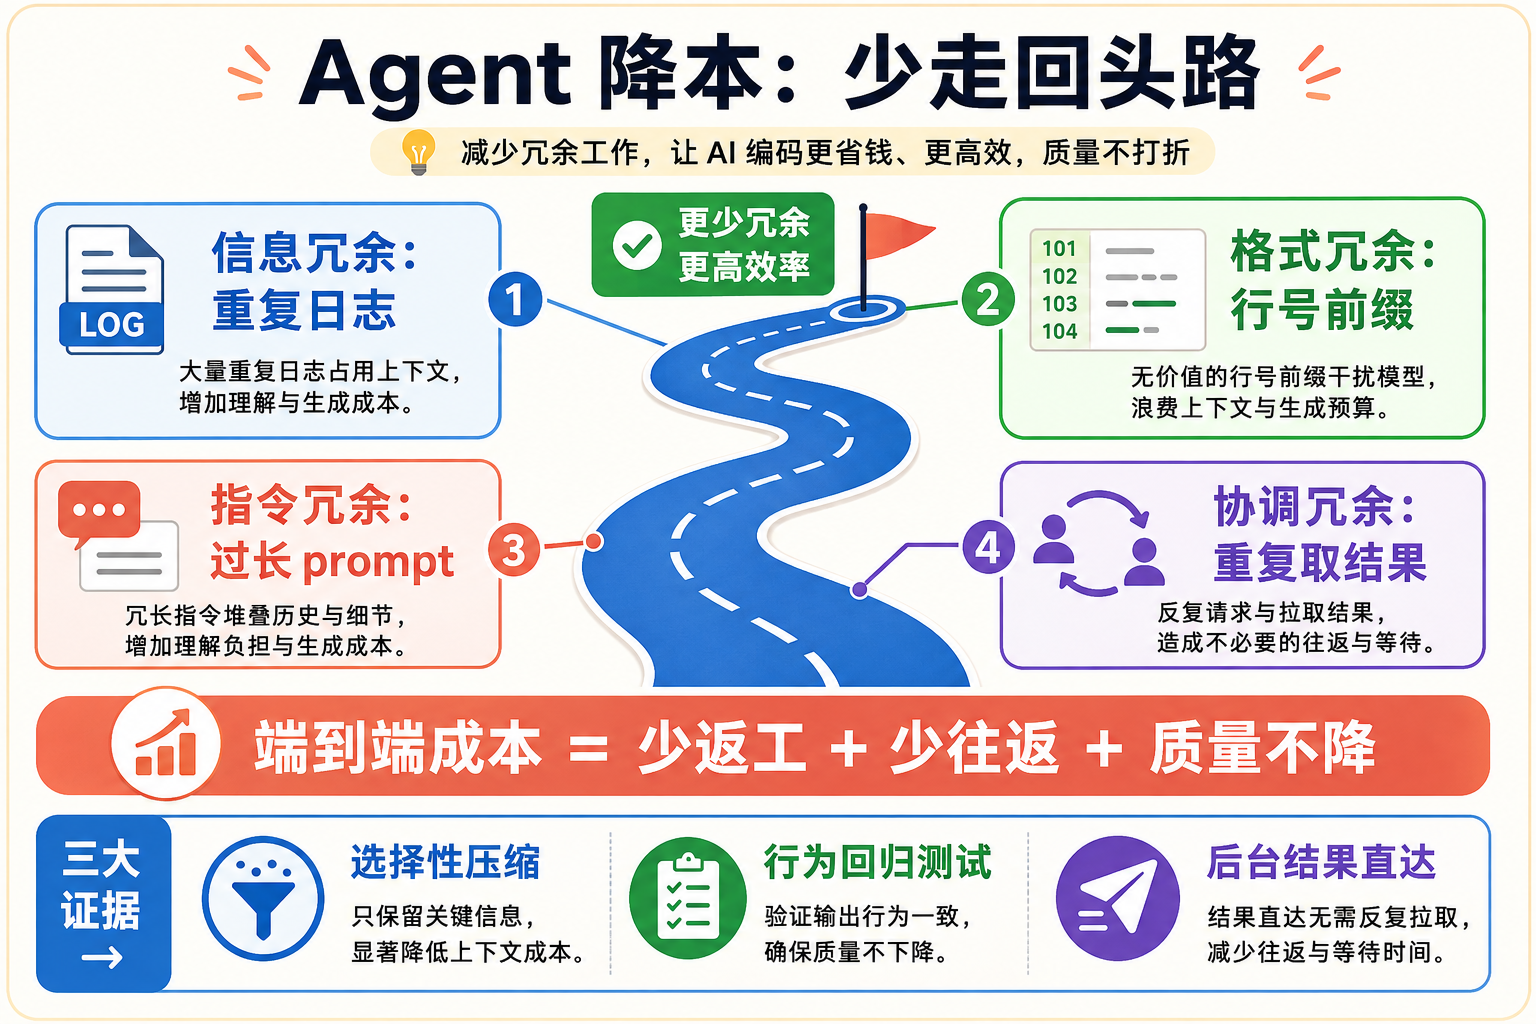
先算回头路,再算 token
Section titled “先算回头路,再算 token”原文先拿 RTK(Rust Token Killer)举例。RTK 会在 AI assistant 读取 shell 输出之前过滤内容。这个想法很直观:少把进度条、重复日志送进模型,应该就能少花钱。
问题在于,输出短不代表信息密度高。GitHub 在自己的 harness 和 benchmark 配置中观察到,当被省略的部分恰好有用时,模型会重新打开完整输出,或者直接重跑命令。结果是工具响应变短了,任务却多了几轮,还要把更多上下文带到后面。局部省下来的 token,被恢复动作吃掉了。
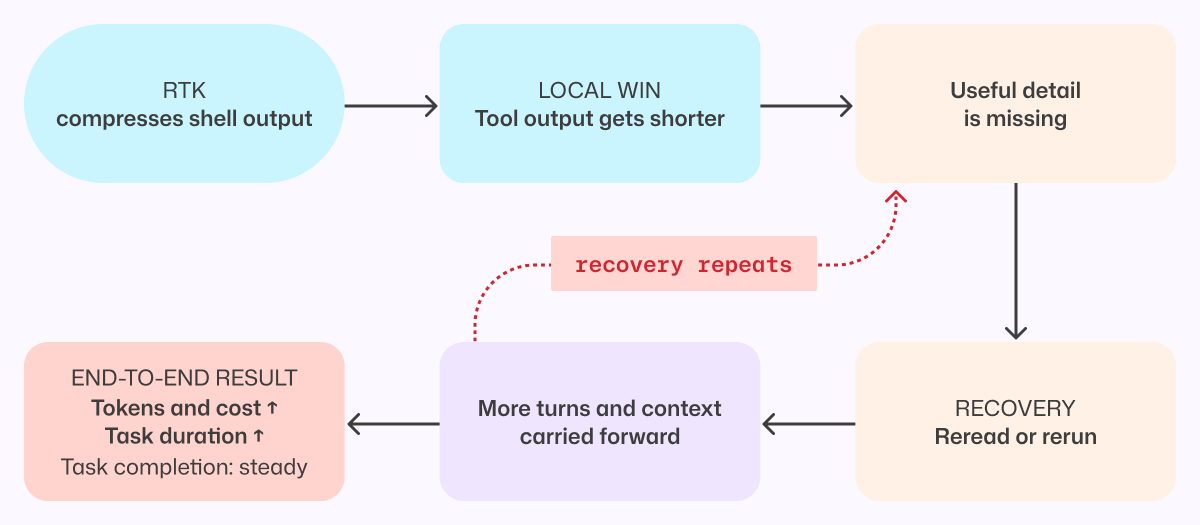
这张回路图给我一个很实用的提醒:压缩器不能只记录“删了多少”,还要记录“模型回来找了多少”。我会把恢复次数或恢复率看成一种反向质量信号。它不是 GitHub 公布的统一指标,而是从这次机制里自然推出来的工程判断:如果压缩之后经常需要补读,说明摘要并没有真正减少工作。
这和 RTK 官方文档 的提醒是一致的:减少 bash 输出字节,不等于账单按同样比例下降。输入 token 还要和系统提示、对话历史、输出 token 一起算。只盯着某一段数据,容易把“少传了一点”误读成“任务更便宜了”。
压缩器应该认识输出的类型
Section titled “压缩器应该认识输出的类型”GitHub 的早期版本曾经压缩 git diff。benchmark 很快告诉他们,agent 会重新打开原始 diff,于是这个过滤器被撤掉了。留下来的规则很克制:先判断输出是什么,再决定如何处理。
cat、git diff、git show和任意脚本结果,原样保留。- 搜索结果可以重新组织,但不能删掉任何匹配项。
- install、build、test、progress 等重复噪声,只有在节省足够多时才压缩;完整原文仍然保存,并提供直接恢复路径。
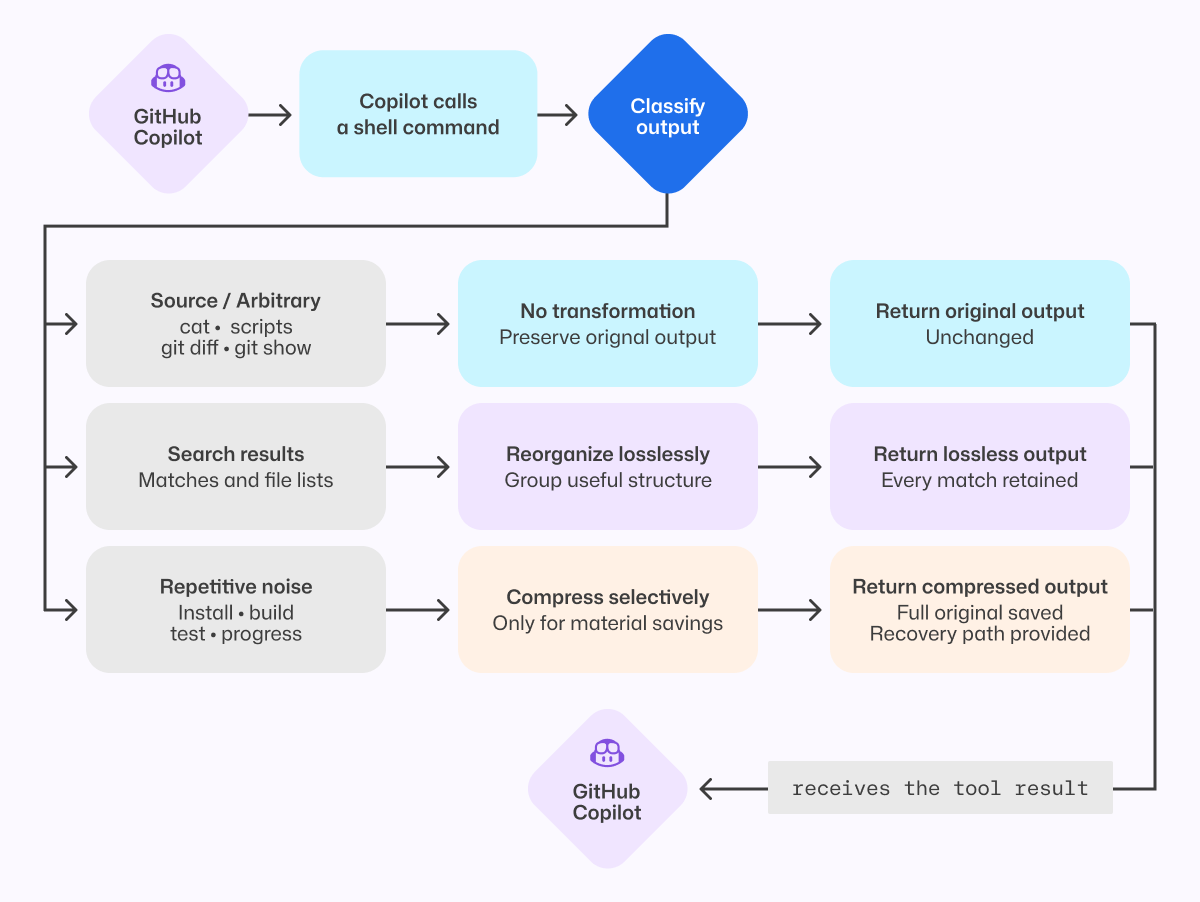
这里有一个容易被“压缩率”掩盖的区别:源码和任意命令结果的内容不可预测,删错一行就可能改变下一步判断;重复安装日志则更接近格式噪声,适合做选择性处理。原文 Figure 4 里的行号前缀就是后一类更安全的例子:旧的 view 工具给每行加编号,当前编辑工具已经通过周围代码匹配,不再需要这些前缀。GitHub 删除的是格式,文件内容没有动。
这四个案例可以归并成一张“冗余地图”:重复日志属于信息冗余,行号属于格式冗余,过长的工具说明属于指令冗余,额外的结果读取属于协调冗余。它们看起来都在消耗 token,处理方法却不能相同。先分类,再压缩,比先定一个统一压缩比例可靠得多。
prompt 变短,行为可能先坏掉
Section titled “prompt 变短,行为可能先坏掉”提示词是另一种容易被误算的成本。它每轮都会发送,缩短一次,后面可能重复省很多次。但 prompt 不是普通文本,删掉一句话,可能连模型的工作方式也一起删掉。
Copilot 的 task tool 会启动 specialized agents。相关指引过去分散在工具描述、schema、agent 定义、系统指令和 companion tools 里。GitHub 用 meta-prompting loop 反复整理,得到一个大约短一半的候选 prompt,再用行为测试检查要保留的要求。
离线测试没有发现问题,在线实验却暴露了回归:原本应该谨慎地并行执行的独立 custom agents,被新 prompt 变成了串行执行。实验被停止。团队先为这个具体行为补了一条回归评估,再把显式 allowlist / denylist 换成一句更短的指导:Independent agents can run in parallel; consider side effects. 修复后的行为测试通过,原有测试也没有失败。
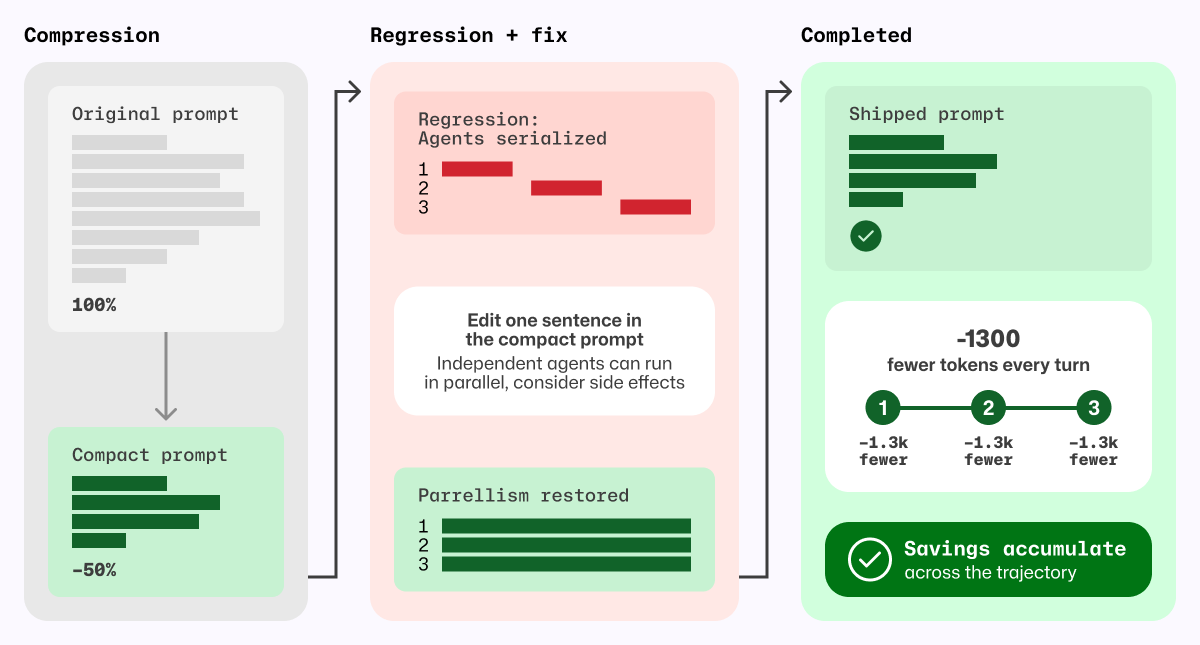
最后的收益是每轮少约 1,300 个 task-tool prompt tokens,约等于每个 session 总 prompt tokens 少 1.8%,每个活跃小时的归一化成本低 2.9%。这组数字最有价值的地方,不是 1,300,而是它经过了压缩、回归、修复和再验证。
我会因此把 prompt 的长度和 prompt 的行为分开验收。前者回答“少了多少字”,后者回答“并行、工具调用、错误处理还按预期吗”。对于 coding agent,后一个问题更接近产品质量。
harness 可以把模型从等待里拿出来
Section titled “harness 可以把模型从等待里拿出来”原文最后一个案例甚至没有改模型输出,而是改了通知机制。
Agent 可以在后台同时运行长 shell 命令和 sub-agent 调查。旧机制在工作完成时只通知“好了”,不把结果一起送回来。模型只好再发一次读取请求;如果多个后台任务接近完成,检索绕路还会重复。新机制批量合并符合条件的完成通知,直接把结果放进已有的 tool-result 格式里。仍在运行中的任务,显式读取行为不变。
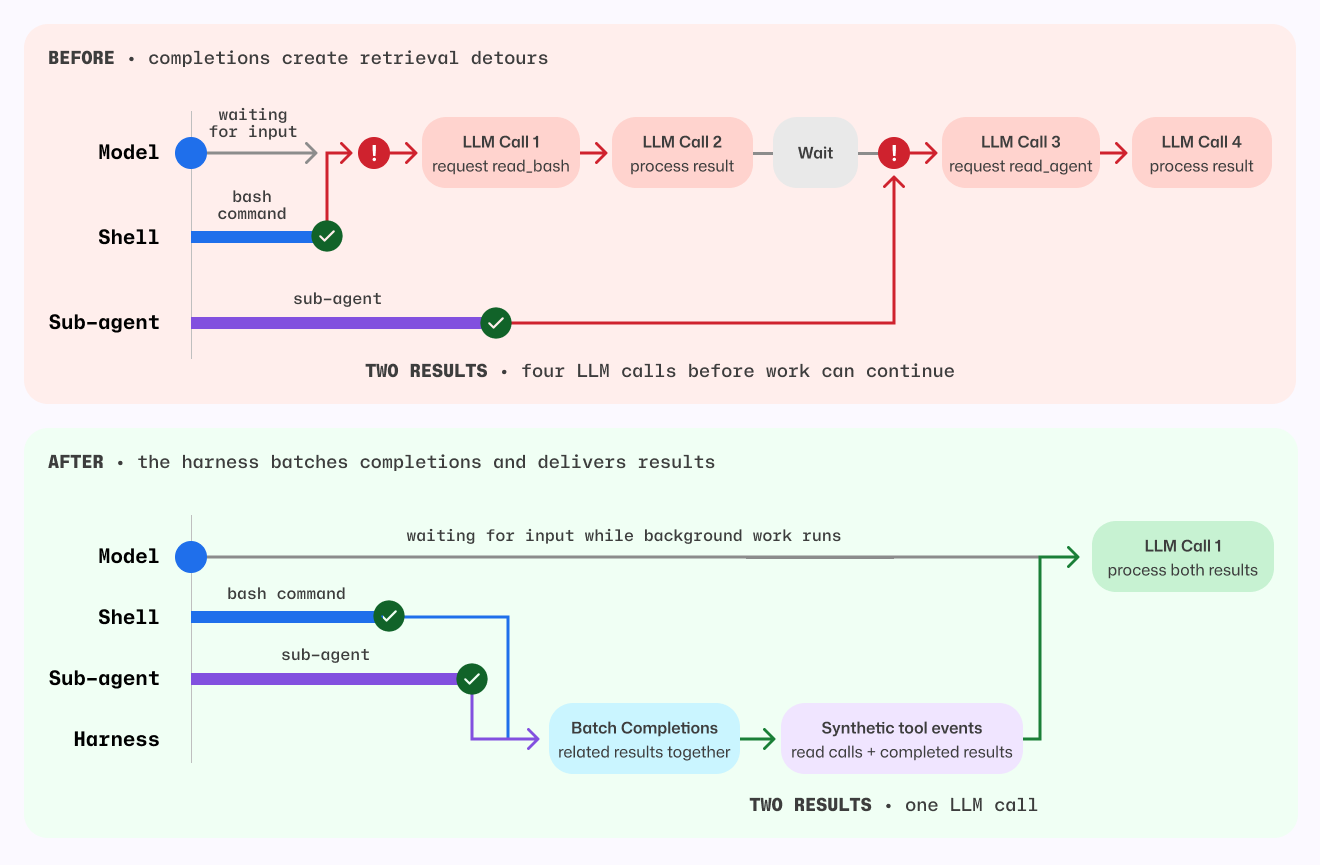
原文的示意案例里,shell 和 sub-agent 两个结果,旧路径需要四次 LLM call 才能继续;新路径一次调用就能一起处理。按 AI Credits 衡量,这项改动平均减少了约 2.3% 的 token-related usage。
这件事让我觉得 harness 的边界比“帮模型接工具”更宽。只要某项工作已经完成,且交付格式可以确定,就没有理由让模型再猜一次“我应该去哪里拿结果”。等待、轮询、拼通知这些协调工作,能在模型之外完成,就应该尽量在模型之外完成。
团队要建立的是任务账,而不是 token 崇拜
Section titled “团队要建立的是任务账,而不是 token 崇拜”GitHub 特别强调,证据不能从一个工作流直接搬到另一个工作流。同一套更紧的 file-tool instructions,在 Copilot code review 中有正向结果,在 Copilot CLI 在线实验中却增加了成本,因此没有发布。反过来,删除行号前缀和选择性压缩输出,在另一组 code review 任务中减少了约 5% 的平均 prompt tokens,质量指标没有实质变化。GitHub Changelog 还报告过共享 file tools 与 instruction tuning 带来的约 20% code review 成本下降,但这个数字同样不能直接套给其他场景。
如果让我给团队提一个最小的评估闭环,我会先把同一批真实任务跑出基线,记录:
- 结果是否达标,以及人工返工或接管比例;
- 完成任务用了多少 turns、tool requests 和失败重试;
- 有多少次触发恢复路径;
- 从开始到完成的延迟;
- 最终总 token / cost,而不是某次调用的 token。
然后每次只改一个环节。压缩输出后,先看恢复是否变多;缩短 prompt 后,先看行为测试;改通知机制后,先看模型调用是否减少,同时确认结果没有被截断。这样才能知道省掉的是浪费,还是把成本挪到了用户等待和人工检查上。
因此我不愿意把原文四组 A/B 数字相加。3.1%、5.5%、2.9% 和 2.3% 是并列实验的对比结果,原文已经提醒它们不一定严格可加。可以迁移的不是一个总百分比,而是一种测量顺序:先定义完成,测完整轨迹;再删除确定性冗余;最后用恢复率、行为回归和线上质量把结果拦住。
GitHub 的结论很朴素:这些改动没有让模型变聪明,只是让模型少做了本来不必做的事。我觉得这比“token 越少越先进”准确得多。一个 agent 如果为了完成任务不断回头,它的上下文再短,也只是把返工藏得更深。
你在自己的 AI coding workflow 里,最想先量化哪一段浪费:重复输出、工具轮询、prompt 搬运,还是失败后的人工返工?