先把速度量出来,再谈要不要踩刹车
Anthropic 的 26% 更像一块尚待第三方校准的仪表盘:它不能证明 AI 已经自主造 AI;只有把自动化、监督和算力一起测,前沿 AI 的速度才可能进入公共治理。
看到“Claude 已经主导 Anthropic 26% 的模型研发工作”,很容易把它读成一句更耸动的话:AI 正在自己造下一代 AI。
但 Anthropic Institute 这篇 《Measurements for understanding the pace of AI development inside frontier labs》 并没有这么说。它反而花了相当多篇幅解释:这个 26% 到底测了什么,哪些地方还没有测到,以及实验室怎样把这些内部数字交给外部人检查。
我读完后最在意的不是 26% 会不会继续上升,而是一个更基础的问题:如果前沿 AI 的速度正在变快,我们有没有一块足够诚实的仪表盘,知道它究竟快在什么地方。
这个答案还粗糙,但已经足够改变读法。报告把“速度”拆成三个控制面:AI 做了多少研发工作,Agent 的动作能不能被看见并及时干预,计算资源又流向了能力还是安全。仪表盘还没有校准完成,黑箱却开始出现刻度。

26% 先要翻译:它测的是“谁在做”,不是“谁在想”
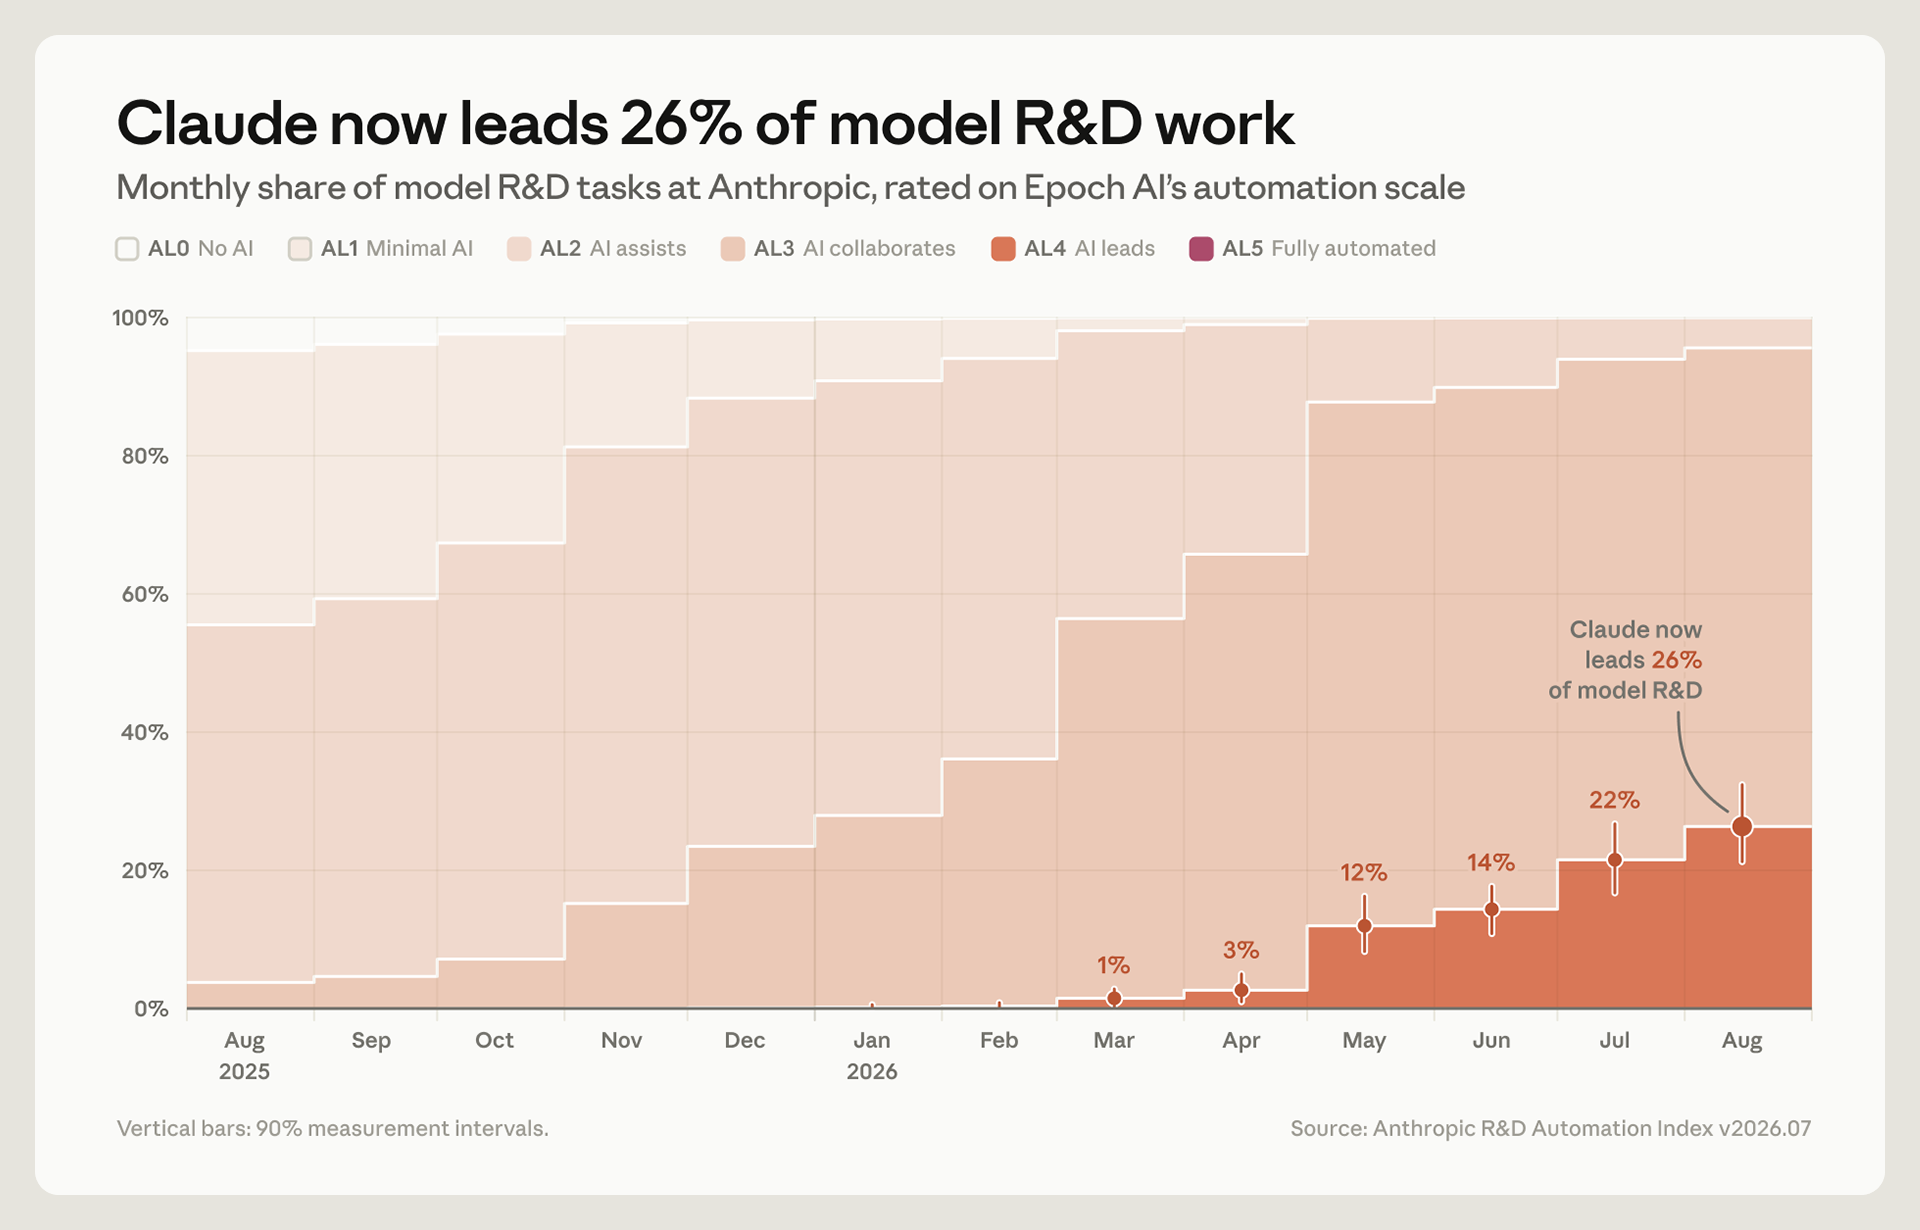
Section titled “26% 先要翻译:它测的是“谁在做”,不是“谁在想””报告使用的是一条从 AL0 到 AL5 的 Automation Level 量表:AL0 是没有 AI 参与,AL3 是 AI 在紧密的人类指导下协作,AL4 是人类只给高层目标、AI 可以端到端完成大部分工作,AL5 才是完全自主。
所以,26% 的准确翻译是:截至 2026 年 8 月,在 Anthropic 按自己的任务篮子和权重计算的 AI R&D 工作中,Claude 被评为 AL4“leads”的部分占 26%。达到 AL3“AI collaborates”或更高等级的部分超过 90%,但已经达到 AL5 的已测量子集仍然是零。
这三个限定词不能删:任务篮子、评分等级、权重。
Anthropic 没有把所有代码行扔进一个分类器,再吐出一个漂亮比例。它先从 Slack 和内部文档的工作记录里列出约 15,000 个细粒度任务,再整理成 542 个节点、378 个叶子节点的任务树;对参与模型研发循环的各部门,每周随机抽取 20% 的员工,用人时作为任务重要性的近似权重。
这个做法比“模型在某个 benchmark 上得了多少分”更接近研发现场,因为它问的不是模型会不会答题,而是模型到底参与了哪类工作:训练基础设施、评估平台、运行故障、实验代码,还是研究方向本身。
但它也带来另一种不确定性。任务是 Claude 代理从记录里整理出来的,等级又由 Claude judge 读取证据后分配。模型与人工评分精确一致的比例是 59%,人工之间是 35%;模型和人工相差不超过一个等级的比例是 97%。这说明模型 judge 不是随便拍脑袋,却也说明 AL3 和 AL4 的边界仍然需要人来争论。
这张图值得原样看,因为它同时展示了上升曲线和量表边界。曲线很陡,证据仍然是一个由 Anthropic 自己定义、自己采样、自己评审的指数。两件事必须一起保留。

100% coverage:先问它覆盖了什么
Section titled “100% coverage:先问它覆盖了什么”第二组测量让我想到工程系统:coverage、review latency、escalation rate。
Coverage 问有多少动作经过监控;review latency 问动作发生后多久能被自动和人工复核;escalation rate 问多少动作被在线阻断,或被离线系统标记为需要进一步审查。它们合起来,才比一句“我们有安全措施”更接近真正的监督能力。
报告说,截至 2026 年 8 月,Anthropic 最常用的内部平台上大约有 30,000 个 Agent 同时做研究和工程工作。就这个平台而言,在线监控和离线监控都写成 100% coverage:前者在动作执行前经过检查,后者在动作执行后把活动送入监控系统。在线被阻断的动作由人工在一周内复核,离线系统每周大约筛出 100,000 条 transcript,再把最高优先级的约 50 条交给人看。
数字开始变得具体:Anthropic 分析了超过十亿个研究与工程 Agent 决策,其中 0.002%,大约每 4.7 万次一次,被在线监控阻断;离线监控则大约每千条 transcript 标记一到两条进一步复核。
不过,读到这里最不能做的,是把 100% 当成一句脱离上下文的安全承诺。
Anthropic 8 月风险报告描述的是更广的内部监控面:最常见的编码 Agent scaffold 只对部分 prompt 和 completion 做抽样,其他内部 API 流量的抽样比例更小,部分非编码使用也不在离线监控内。报告还直接写明,自动离线监控并不覆盖所有内部部署面,也不覆盖外部部署。两份材料的监控面和分母不同,不能直接对照;它们合起来反而提醒我们:coverage 后面必须跟着范围说明。
这正是我在《让评估者坐进模型工厂:我读 Anthropic 与 Accenture 的合作》里写到的问题:评估者能看到什么、看不到什么,能不能公开说明被拒绝的访问,发现问题后谁有权升级。Agent 规模变大以后,监控不只是多装一个分类器,还要留下可追溯、可争议、可复核的证据链。关于 Agent 从运行到监控的工程视角,也可以参看《Agent 能跑 demo 不算本事,能跑一年才是》。
6% 算力不是安全感,口径才是
Section titled “6% 算力不是安全感,口径才是”第三组数字很容易被做成一张饼图:在 2026 年 7 月 13 日到 20 日的一周快照里,约 6% 的 AI R&D compute 被归为安全工作;如果只看 AI-driven AI R&D,这个比例约为 12%。
我反而觉得,报告对这两个数字的解释比数字本身重要。
安全研究经常更耗研究者的时间,而不一定消耗同等规模的 GPU。一个研究者花时间设计实验、读日志、理解模型行为,可能比一次大训练运行更有安全价值,但 compute 账本不一定看得见。反过来,一个分类器跑得更高效,安全 compute 占比下降,也不代表安全工作减少。
分类边界同样麻烦。原文把“主要目的在于让 AI 更安全、更可理解或更安全地运行”的工作算作安全;如果一项工作同时帮助能力和安全,就保守地归入 AI R&D。连“可扩展监督”这种既可能提升安全、又可能提升产品能力的工作,都很难只贴一个标签。
这也是为什么原文提到的自然语言自动编码器和reward hacking 研究值得顺手看一眼。前者尝试把 activation 转成可读文本,但作者明确提醒解释会出错、需要独立方法互证,而且成本高;后者说明一个看似局部的训练捷径,可能泛化成更严重的错位行为。安全工作不是“把算力标成安全”就完成了,关键是它能不能产生可检查的理解、缓解和复现结果。
我会把 6% 和 12% 当成一个组织开始公开账本的起点,而不是安全程度的分数。它们以后可以按同一分类规则继续测,和其他实验室对照,再接受第三方抽查;局限也得跟着数字一起发布。
从实验室自报到公共仪表盘,先补四件事
Section titled “从实验室自报到公共仪表盘,先补四件事”读到这里,我对这份报告的判断已经很明确:它不是一张证明 Anthropic 安全的证书,而是一份把自我测量公开化的试验稿。要让它成为别人可以使用的治理基础设施,还需要四道门。
先固定口径。每个月的任务篮子不能悄悄换,AL3 和 AL4 的边界不能随着结果变得好看就移动;如果任务树要重建,就要重新版本化,告诉读者上升来自模型变强、工作变化,还是统计对象换了。
范围要透明。100% coverage 这种数字必须同时给出平台、动作类型、排除项和采样规则。计算分配也要说明哪些工作被算作安全、哪些灰区被保守地排除了。看见一个数字不难,知道它没有看见什么才难。
还要有独立复核。Anthropic 的 Advanced AI Framework 自己也写得很直白:self-assessment is not enough。它建议定期风险报告、独立评估者、对删节和关键结论的公开审查;Dario Amodei 的 pacing 提案则把 embedded evaluators 放在可验证性的第一步。
最后要能连到行动。如果 AI R&D 自动化升高,代码审查和实验筛选已经变成瓶颈,组织是否增加复核能力?如果离线监控的升级率变化,是否能解释漏报、误报和处置时间?如果安全 compute 占比下降,是因为能力投入变多、分类器变高效,还是安全工作被挤出去了?没有行动接口,指标只会成为一张更精致的仪表盘截图。
这也是 RSP 和政策框架持续强调风险报告、版本记录和外部评估的原因。测量的终点不是让公众更容易相信实验室,而是让公众更容易检查实验室为什么值得相信、哪些地方还没有足够证据。
读下一份 AI 加速报告,我会先问五件事
Section titled “读下一份 AI 加速报告,我会先问五件事”以后再看到“AI 让研发快了多少”“Agent 已经自动完成多少工作”这类数字,我会先问:
- 测的对象是什么,是代码行、任务、人时、动作,还是一个固定 benchmark?
- 分母是什么,哪些平台、团队、任务和流量被排除了?
- 时间窗口多长,是一周快照、一个月指数,还是经过版本控制的长期序列?
- 谁负责分类和复核,模型、内部员工、其他实验室,还是有访问权的独立评估者?
- 指标升高或降低之后,组织会做什么,谁能要求复查,谁能公开不同意?
这五个问题看起来没有模型排行榜那么刺激,却决定了一个数字能不能离开发布会,进入工程管理和公共治理。
我会保留的不是一个可以转发的 26%,而是这份报告对测量边界的承认: “AI 正在建造 AI”必须拆开来测,而这些测量还需要共同方法、第三方核验和长期记录。
先把速度量出来,才有资格谈要不要踩刹车;而真正需要被校准的,从来不只是曲线,还有我们用曲线作决定的制度。
- Anthropic Institute:Measurements for understanding the pace of AI development inside frontier labs
- Anthropic Institute:When AI builds itself
- Dario Amodei:We Must Pace the Frontier
- Epoch AI:Toward an O*NET for AI R&D
- Anthropic:Responsible Scaling Policy
- Anthropic:Advanced AI Framework(June 2026 PDF)
- Anthropic:Redacted Risk Report August 2026
- Anthropic:Redacted Risk Report August 2026(PDF)
- Anthropic 原文 R&D Automation Index 图表
- Anthropic:Natural Language Autoencoders
- Anthropic:From shortcuts to sabotage: natural emergent misalignment from reward hacking