让 Agent 追覆盖率之前,先准备一台可以丢掉的机器
Fuzzing Taskflow 把覆盖率反馈和崩溃初筛交给 Agent;但它也能调用宿主 shell。省下人工盯循环的时间前,先把执行放进低权限、可销毁的环境。
模糊测试经常被说成“让 fuzzer 自己跑”。真正磨人的部分,常常在两轮运行之间:看覆盖率报告,找没到达的分支,决定补一个输入还是改 harness,再跑一轮确认。GitHub Security Lab 的 Fuzzing Taskflow 想把这段反复判断也交给 Agent。
读到运行警告时,我把前面的自动化流程重新想了一遍:它会在宿主机上运行 afl-fuzz、clang,也会执行 LLM 选出的构建命令。作者建议只在 Codespace 或临时虚拟机里运行,而且不要给它提升权限。Agent 可以继续追覆盖率,前提是出错时,受影响的环境可以被丢掉。

模糊测试最费人的,是每轮之后的判断
Section titled “模糊测试最费人的,是每轮之后的判断”Fuzzer 跑起来只是开始。要把它带到值得测试的代码里,得先找到合适的入口函数、搭出 harness;之后还要读覆盖率报告,为没触达的路径补输入或扩展 harness。Crash 出现后,研究者还得确认问题来自库代码,还是测试 harness 自己写错了。
Taskflow 把这些工作连成一条反馈环。每轮 fuzzing 结束后,它用另一个带覆盖率插桩的构建重放 AFL 的输入队列,读出源码覆盖情况,再决定新增 seed、修改 harness、扩充字典,或跳过低价值路径。完整六轮的 AFL 预算按每个 harness 合计 31.5 分钟;覆盖率趋于停滞时会提前停下,编译和模型处理时间不在这笔预算里。
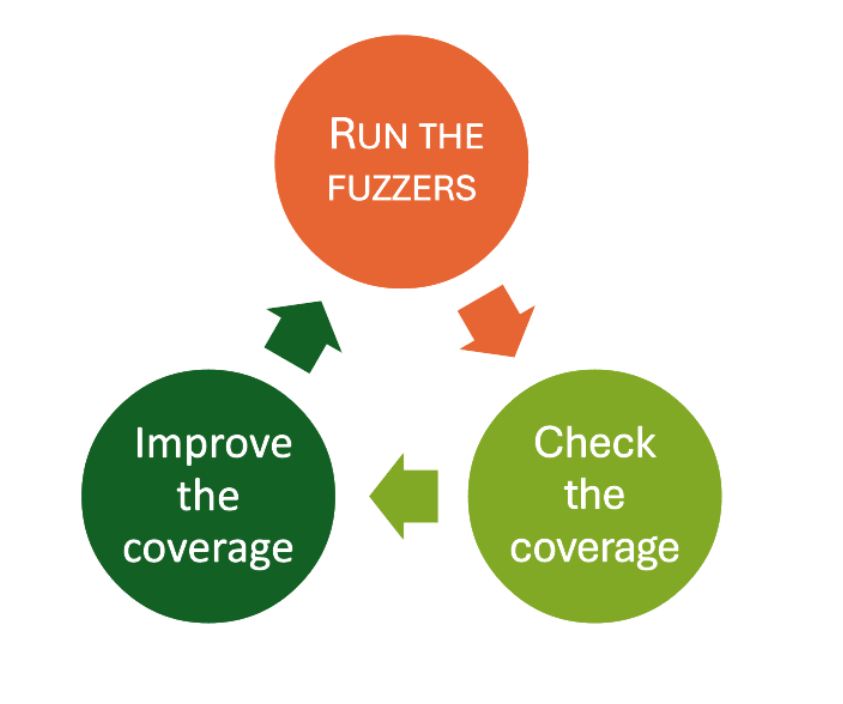
我感兴趣的变化落在两轮运行之间:Agent 接手了反复读报告、追覆盖缺口的工作,工具才有机会沿着反馈继续探索。
工具分层,不等于权限边界
Section titled “工具分层,不等于权限边界”原文把架构概括为:Agent 负责决定 fuzz 什么、怎样改进 harness,MCP 工具负责编译、运行 AFL、读报告和保存状态。每个 harness 还会生成两个版本:一个让 AFL 追踪边覆盖,一个用来重放队列并产出人能读的源码覆盖率。这种分工解释了系统怎样工作,也让反馈结果能回到下一轮任务里。
这层分工解释了命令怎样被调用,却不能证明命令的影响范围已经受限。当前公开仓库既定义了 compile_harness、run_afl_for 这样的专用工具,也给任务提供通用的 local_shell。这个接口可以通过 bash -c 执行命令;项目自己的安全说明也写明,没有额外容器把任务和宿主机隔开。
真正起作用的是进程可以访问的资源。账户权限、工作目录、凭据和网络范围,都会改变一次错误构建命令的后果。原文建议使用 Codespace 或临时虚拟机并以普通权限运行;我会把它当作默认运行条件。若要试这个项目,我会先用一次性环境和可丢弃的仓库副本,不把日常开发机上的凭据顺手带进去。
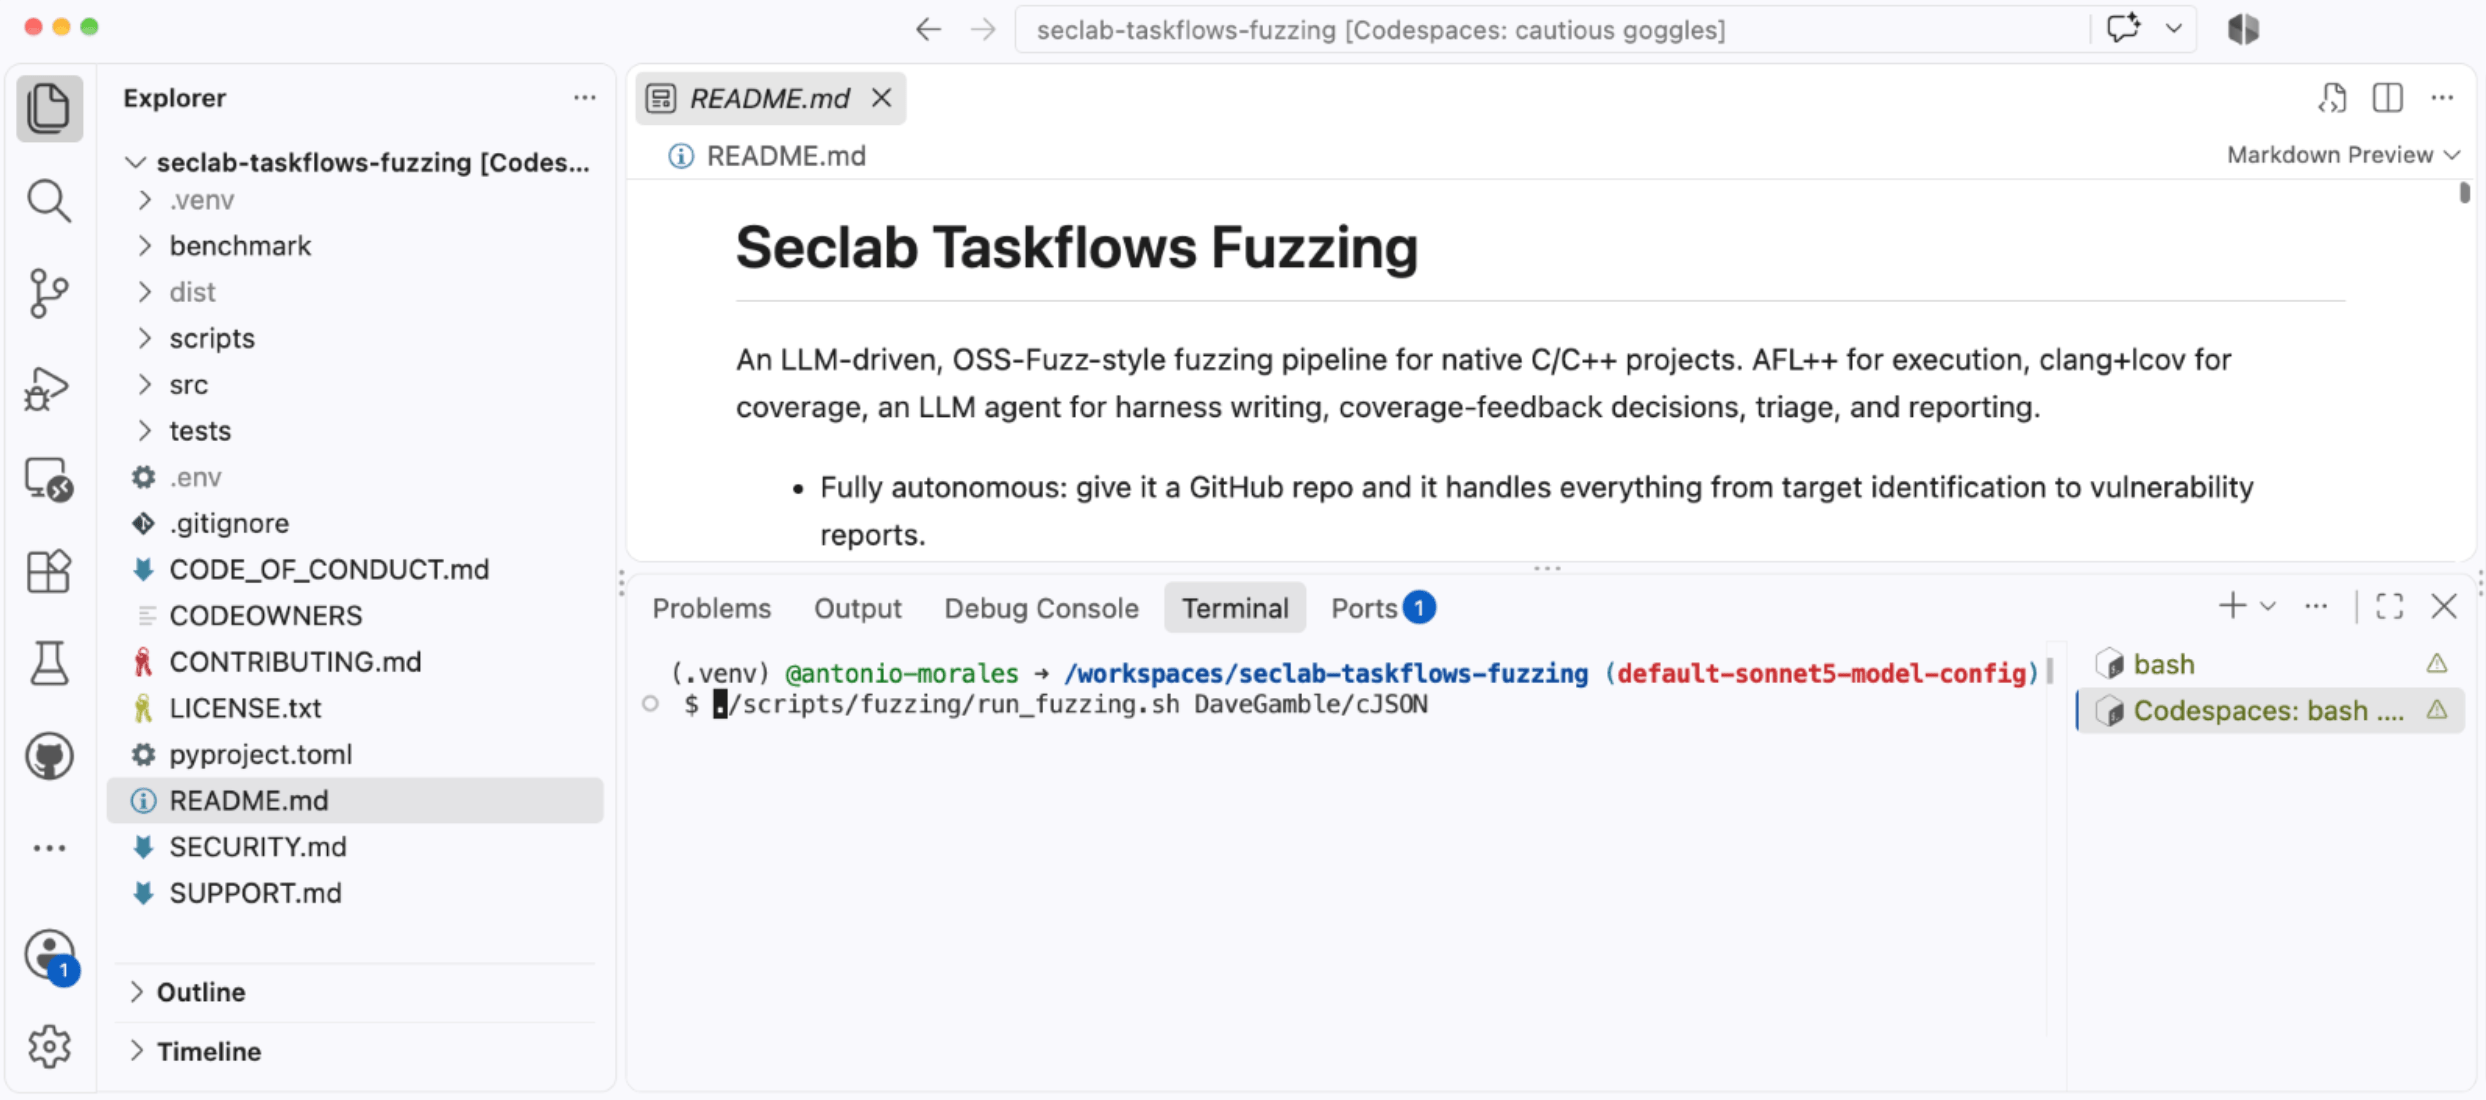
原文里的 Codespace 启动截图把上手步骤压得很短。它说明怎样进入项目,不会替你确认运行账户的权限;隔离还得看环境本身。
读完仪表盘,还得回到 crash 样本
Section titled “读完仪表盘,还得回到 crash 样本”作者还展示了覆盖率趋势和 crash 仪表盘。它们能帮助维护者看到哪些 harness 正在运行、覆盖率如何变化、出现了多少 crash。这种可见性有用:无人值守的程序如果只输出一个“完成”,很难判断它究竟做过什么。

仪表盘上的数字记录运行状态;是否发现漏洞,还得回到样本和调用路径。Taskflow 会缩减 crash 输入、用 AddressSanitizer 重放、合并重复项,再让模型区分漏洞、harness 错误、超时等情况。报告可以带上调用栈、根因解释和建议补丁。作者也专门提醒,模型会判断错,verdict 和补丁都要人工 review。
我会把这些报告当成调查的起点:先确认输入能否重放,再检查调用路径是否从公开 API 到达问题代码,最后由人判断影响和修复。覆盖率标出未触达的路径,crash 留下异常输入;漏洞与否仍得回到调用链。报告中的输入、调用栈和复现步骤,也对应我在《测试通过之后,Agent 还欠你一条证据链》里写过的要求:结论要留下别人能追问、能重放的依据。
把它交出去之前,先决定什么可以被牺牲
Section titled “把它交出去之前,先决定什么可以被牺牲”我愿意把这套系统当作研究助手来试,前提是给它一个可丢弃的执行环境。它能读覆盖率、选下一轮探索、整理 crash,替研究者处理反复劳动;漏洞是否成立仍由人判。
试用前,我会先问两件事:运行账户能访问哪些文件、凭据和网络?出现异常后,环境能不能直接销毁重建?选模型之前看清这两处,才知道一次自动化失手会伤到哪里。
我仍会把它当成有用的 fuzzing 助手。正式运行时,先让它碰不到需要保留的东西;发现 crash 后,保存能复现的输入和调用栈,再由人确认路径与影响。这样自动化可以持续探索,后续调查也有证据可用。