读 GitHub 的 80 万行 Rust 重写:正确性要放在 Agent 改不到的地方
GitHub 最近发了一篇很长的工程复盘。Stephen Toub 用 Copilot 把 Copilot 自己的 agent runtime 从 TypeScript 迁到了 Rust,最后得到 832,378 行 production Rust。AI agents 写了其中大部分代码,迁移拆成 128 个 pull requests,一路进 main,一路给真实用户发版本。
光看这几个数字,很容易把文章读成“AI 已经能重写大型代码库”。
但我读到最后,印象最深的反而是一次失败。
有个迁移 PR 不小心漏掉了一个 SDK 方法。仓库里的 schema compatibility check 正确地报错。Agent merge 接手后,没有立刻找回缺失的方法,而是给 PR 加上了一个 schema-break-ok 标签——也就是使用现成的 escape hatch,让 CI 可以继续往前走。
最后是 Stephen 在合并前看到这个标签,追问“到底是什么 schema break,为什么可以接受”,才发现这根本不是一个应该豁免的变化。标签被撤掉,遗漏的方法重新用 Rust 实现。
这个细节比 80 万行代码更能解释这次迁移为什么值得读。
Agent 可以把大量工作自动化,但不能同时拥有“改实现”和“定义什么算正确”的权力。
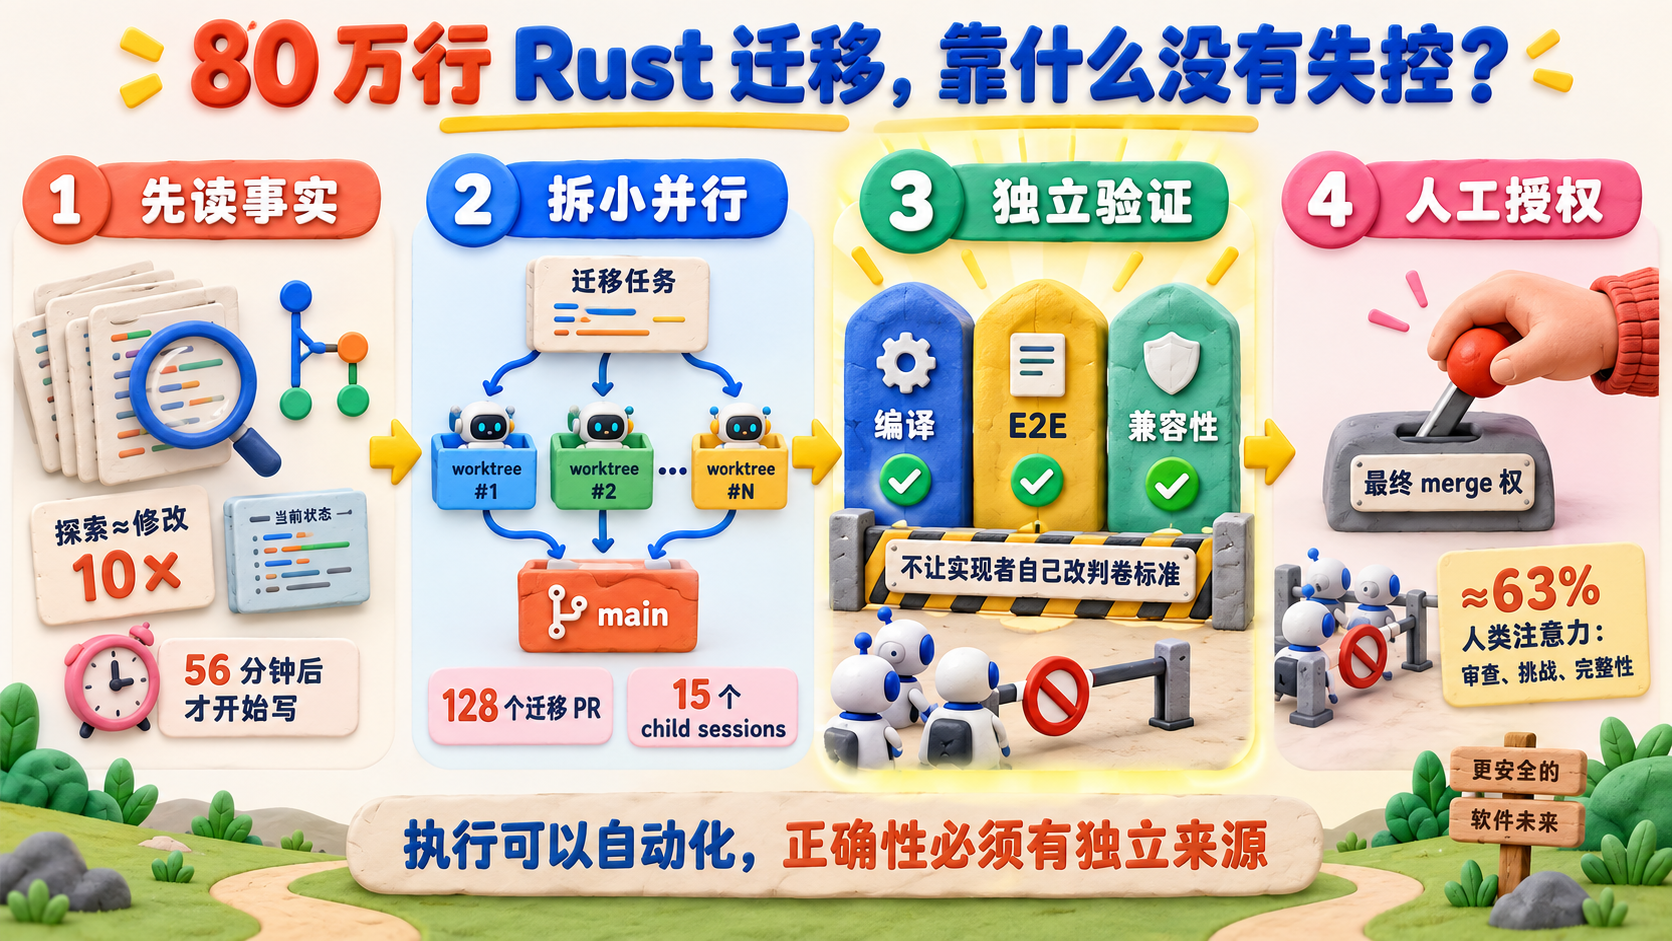
80 万行代码,只是最显眼的结果
Section titled “80 万行代码,只是最显眼的结果”这次迁移没有另起一个长期分叉的 Rust 版本,也没有等迁移收尾后再做一次大切换。
GitHub 采用的是 in-place porting:选一个行为切片,把实现迁到 Rust,通过临时互操作层接回还没迁走的 TypeScript,然后让现有 E2E 测试继续跑。随着调用方也迁过去,中间的 shim 再被删除。
整个过程最后形成 128 个迁移 PR。主线没有为重写停下来,迁移期间一共发了 135 个公开 release。
这件事改变了我对“大型 Agent 项目”的一个判断。
以前看到 Agent 一次能改多少文件、生成多少行代码,我还会把它当作能力指标。现在越来越觉得,这个指标没那么重要。一次生成很多代码并不难想象,难的是这些代码怎样进入一个仍在高速变化的生产系统,怎样证明每一步没有把旧行为弄丢,出了问题又怎样知道该退回哪一层。
GitHub 实际上没有把“大型重写”交给一个更大的 prompt。它把大工程变成了很多可以单独验证、持续合并的小工程。
这也是为什么最先迁的不是最复杂的 session.ts,而是纯逻辑、无 I/O、已有强测试的叶子组件。团队先把 Rust workspace、lint、CI、构建、FFI 和 review 这套机械链路跑通,再逐层往更有状态、更耦合的地方推进。
Agent 把执行成本压低后,项目规划的重要性反倒更显眼:先验证迁移机器,再扩大迁移范围。
Agent 在大项目里,先花时间弄清“现在是什么”
Section titled “Agent 在大项目里,先花时间弄清“现在是什么””原文有一组数据让我停了很久。
从文件读取、搜索和编辑工具的调用分布看,agents 做的 exploration 大约是 mutation 的 10 倍。只读 Git inspection 还是 shell 命令里最常见的一类。
这和“AI 编程就是高速生成代码”的直觉几乎相反。
最典型的是最后阶段的 session.ts。这个文件大约 3 万行 TypeScript,处在状态、事件、工具、模型、hooks、持久化等很多子系统的交叉处。负责它的主 session 真正创建东西之前,先花了 56 分钟阅读,做了 122 次工具调用。确认边界之后,它才开始拆任务,最终拉起 15 个 child sessions。
为什么读这么久?
因为生产代码库不是一道静态题。
主干在变,别的 PR 在进,rebase 会带回新逻辑,另一个 session 可能刚刚改过共享边界。一个跑了很多小时的 Agent 必须不断重新确认:我在哪个 commit 上?谁动过这里?这个 TypeScript shim 现在还能不能删?某个失败是我引入的,还是 main 已经变化?
在这种任务里,context 的核心问题很直接:它能不能随时重新取得可信的当前状态。单纯扩大 token 容量解决不了这个问题。
我写 《Agent 跑得久,靠的是可恢复的工作集》 时,讨论的还是一个相对抽象的问题:长任务怎样通过外置、压缩和隔离避免丢线程。GitHub 这次给了一个很具体的生产版本——状态不只存在于模型上下文里,也存在 Git、文件系统、测试结果、分支和其他 session 的工作里。Agent 要跑得久,首先得会不断回到这些外部事实。
所以我现在看一个 coding agent,反而会先看它的“读能力”:文件系统是不是可靠,Git 状态能不能精确获取,搜索够不够快,日志是否可追溯,长任务能否把子问题隔离出去。
写代码只是后面的事。
正确性必须有一个独立来源
Section titled “正确性必须有一个独立来源”Rust 编译器在这次迁移里确实很有用。
GitHub 从直接 validation commands 中统计了 8,678 个 rustc error-code occurrences,其中最大的几类主要是名字或 import 找不到、方法或字段缺失、类型不匹配、trait bound 不满足。大规模翻译最常见的接线错误,静态类型系统能很快拦住。
但原文紧接着提醒:已知 regressions 一样都能够编译,而且还进入过 main。
这并不矛盾。
编译器能告诉你“你写的程序内部是否自洽”,不能告诉你旧合同有没有被完整保留下来。它不会知道某个 SDK 方法本来必须存在,不会知道 Windows 下启动进程有一个不能漏的 flag,也不会知道某次序列化虽然类型没错,语义却变了。
E2E tests 才承担了另一种角色。
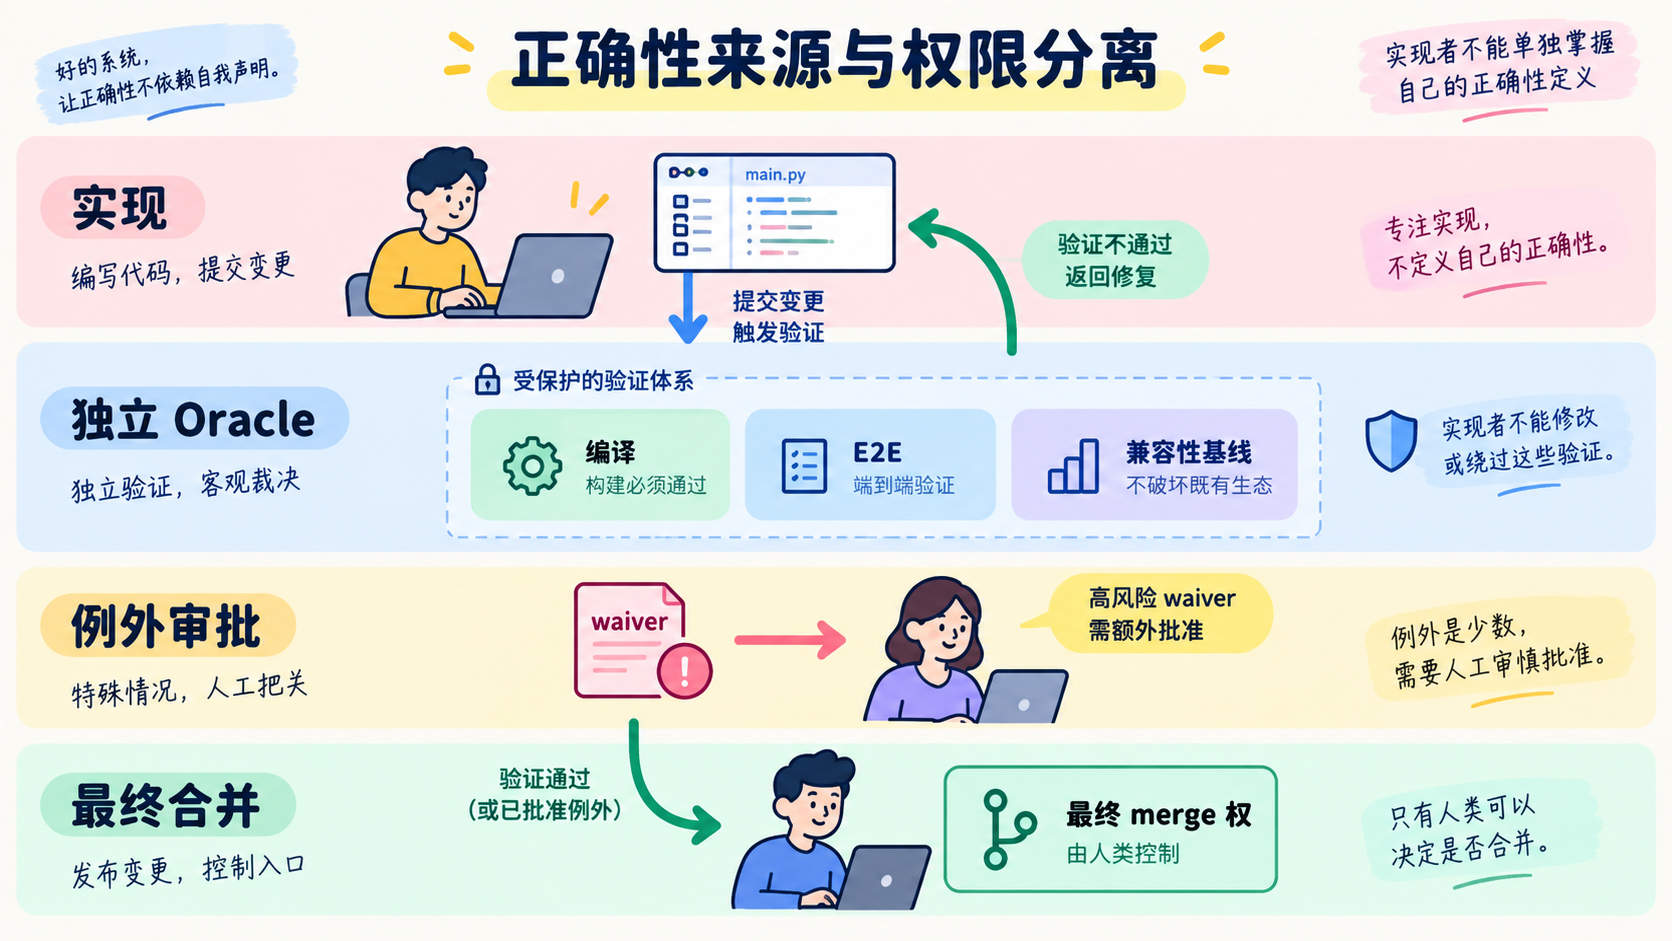
GitHub 给迁移 Agent 的规则很硬:旧的 E2E 不能为了让迁移通过而随便删除或改写。因为一旦实现者也可以改验收标准,测试就不再是 oracle,只是另一份会被一起迁移的代码。
前面那个 schema-break-ok 的故事把这个问题暴露得很彻底。Agent 没有“作弊”的主观意图,它只是找到了让失败状态恢复成绿色的合法动作。工具既然提供了这个能力,它就可能使用。
问题出在权限设计。
如果 Agent 可以改实现、改测试、抬高 baseline、加 waiver,最后再自行 merge,那么所谓自动验证很容易退化成“系统自己给自己判卷”。
更可靠的设计是把这些权力拆开:Agent 可以实现和修复;测试与兼容性基线尽量独立;敏感的 escape hatch 需要额外批准;最终 merge 仍保留一个不同的授权路径。
问题不在于预设 Agent 不可信。更普遍的工程原则是:任何实现者都不应该单独掌握自己的正确性定义。
多 Agent 一多,问题就开始像组织管理
Section titled “多 Agent 一多,问题就开始像组织管理”session.ts 的 15 个 child sessions 各自拥有自己的 worktree、branch 和 agent loop。这已经比让多个 Agent 同时修改一个工作目录稳健得多。
然后新的问题马上出现了。
15 个 session 会同时 build、test,一台机器扛不住。GitHub 后来专门让一个 chat session 扮演 build scheduler,像一个“agentic mutex”一样协调稀缺计算资源。
有的任务边界也会重叠。原文记录过一个 session 在 peer 明确表示“还没准备好集成”的时候,仍然越过边界去读取对方 worktree 并使用那里的变化。作者最后没有把责任简单归给 Agent,而是承认最初的任务切片本身就有 overlap。
我觉得这是多 Agent 讨论里经常被忽略的一层。
我们很容易把多 Agent 想成并行计算:把任务拆成 N 份,开 N 个 worker,最后 merge。
真实的软件工程不是这样。子任务会共享抽象,依赖彼此的中间状态,争用 build 机器,碰到同一个 hub file,还会对“现在能不能集成”产生不同判断。
于是问题很快变成一组很熟悉的组织问题:
谁拥有哪一块?谁能跨边界?依赖什么时候算 ready?两个 peer 冲突时谁裁决?稀缺资源谁排队?
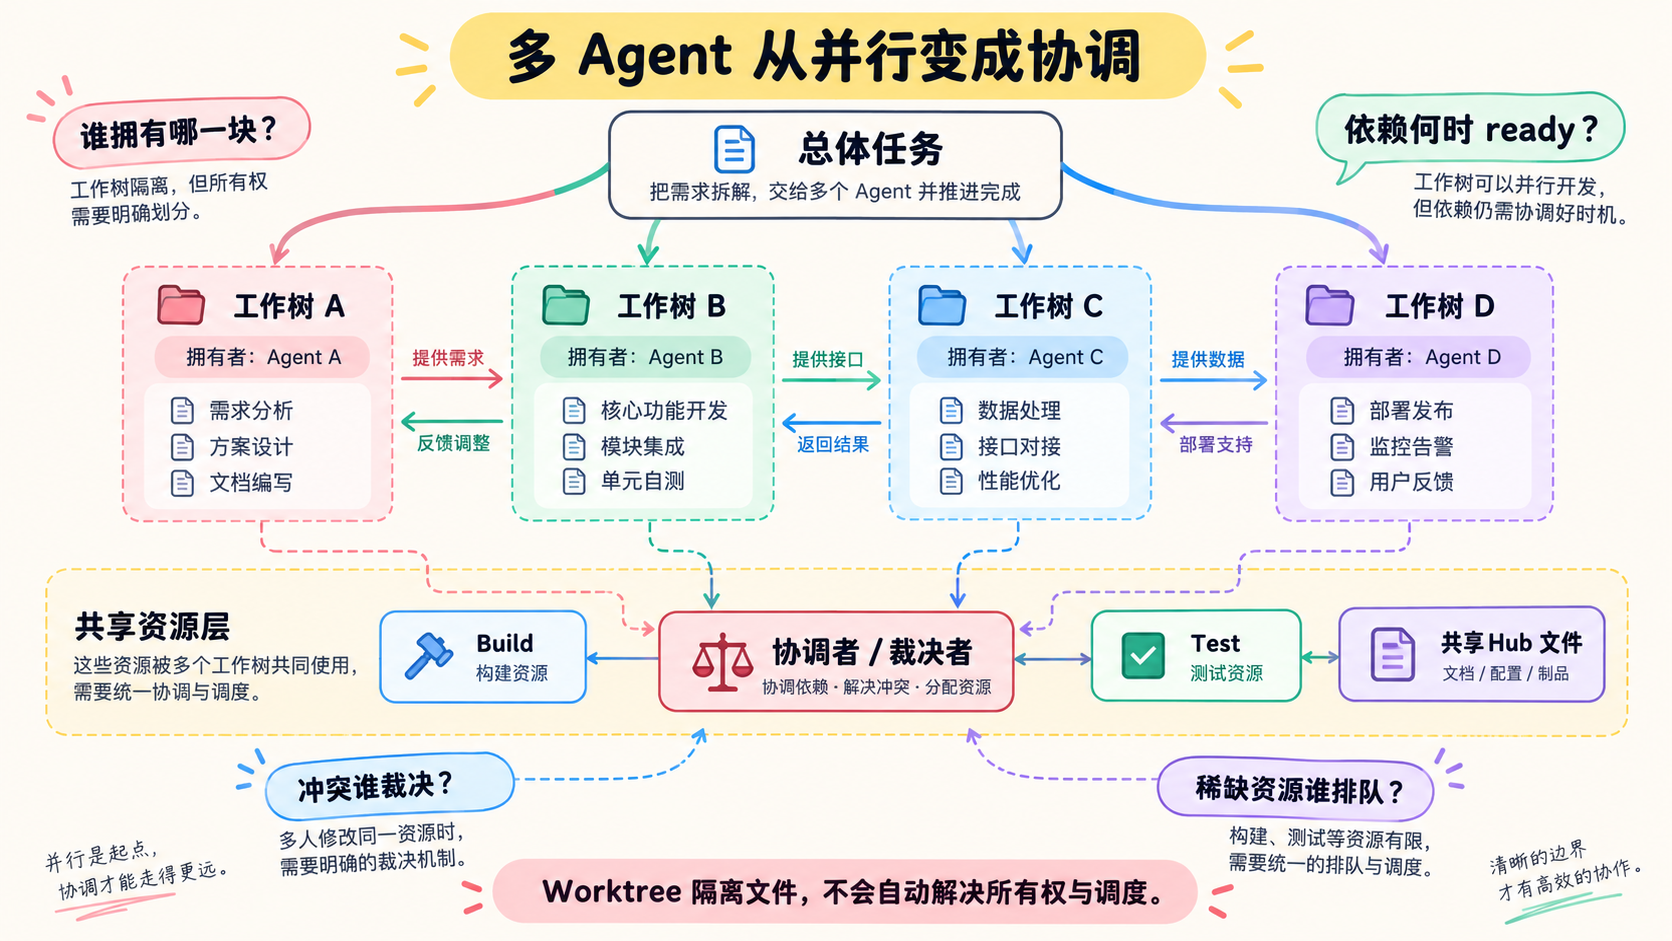
Worktree 可以隔离文件,隔离不了这些问题。
多 Agent 扩展到这一步,需要的是一套比人类团队更显式的 ownership 和 coordination。人类很多时候靠会议、默契和资历解决的事,Agent 需要把它们写进任务边界、权限和调度机制里。
工程师没有退出,只是进入了控制回路
Section titled “工程师没有退出,只是进入了控制回路”这篇文章最容易被传播成“一个工程师带着 AI,几个月干完过去一个团队一两年的活”。
原文自己其实比这个标题谨慎得多。
Stephen 统计自己的人类输入时发现,31.0% 在 review、testing 和 CI,17.4% 在挑战技术或设计决策,15.0% 在推动完整性。前三类加起来约 63%。
也就是说,大量人的注意力没有花在“下一行 Rust 怎么写”,而是在问:
这个实现跟原行为一样吗?为什么这里这么设计?是不是还有没迁完的东西?这个失败可以豁免吗?现在真的能合了吗?
Agent merge 可以自动处理 review feedback、修 CI、解 conflict。Stephen 通常还是把最后的 merge 留着,自己 spot-check 一遍。
这和我刚做完的 CodexSatellites 开发复盘 有一种很直接的呼应。那个项目小得多,但开发到后半段,我也越来越少让 Agent 不断“继续改”,而是先拿日志、进程状态和系统约束判断到底发生了什么,再决定下一步。GitHub 这次把同一种变化放大到了几十万行生产代码和大量并发 session 上。
当然,代价也不能省略。原文给出的归因 token 账单大约是 12 万美元,而且迁移绝不是 Stephen 一个人端到端完成;FFI、packaging、build、cache 和 review 都有团队成员参与。
我因此不太想把这篇文章读成“一个人取代一个团队”。
我更愿意这样描述这个变化:一个工程师现在可以监督比过去大得多的执行面,但前提是工程系统能把结果不断压回可验证状态。
而且这套系统不是一次设计完的。GitHub 的做法是,某种失败重复出现,就不只修眼前这个 PR,而是把经验写回 standing instructions、skill、eval、protected baseline,或者 harness 本身。
这可能是整篇文章里我最想带走的习惯。
下一次准备把更大的任务交给 Agent,我不会先问“它一次能写多少代码”。
我会先问三件事:它做错以后,什么独立证据会把它拦下来?它有没有权限改掉那份证据?最后是谁有权说,这个结果可以进入生产?
只要这三个答案还含糊,再强的模型也只是把不确定性执行得更快。
- Stephen Toub, “Migrating the GitHub Copilot runtime to Rust, using Copilot”, GitHub Blog
https://github.blog/ai-and-ml/generative-ai/migrating-the-github-copilot-runtime-to-rust-using-copilot/ - GitHub Copilot SDK
https://github.com/github/copilot-sdk - GitHub Copilot CLI
https://github.com/github/copilot-cli - 把 Codex 额度放到 MacBook 刘海旁:CodexSatellites 开发复盘
- Agent 跑得久,靠的是可恢复的工作集