检测器报出 p ≤ 0.01 时,我会先问:这是否足以确认文本来自 AI?p 值没有回答来源问题。vLLM 这篇水印文章值得细读,因为它顺着生成路径讲水印怎样留下信号,也讲检测器最后算出了什么。
读完原文,再对照 vLLM 当前文档,我会把判断限定在这里:水印命中说明文本符合某组带密钥的采样规律。这个分数可以支持复核;若要判断来源,还得检查序列行为、检测误差和密钥安全。

可复算的随机数,藏在 token 选择里
Section titled “可复算的随机数,藏在 token 选择里”语言模型在每一步都会给候选 token 一组概率。普通随机采样会按这组概率选出下一个 token。Gumbel-max 换了一个等价的计算方法:给每个候选项的 log 概率加上 Gumbel 噪声,再选择分数最高的那个。对随机密钥取期望时,每个位置选中 token 的概率仍与原分布相同。

采样示意图来自:vLLM 原文中的 Gumbel-max 图。图中还展示了重复抽样后频率接近模型给定的概率。
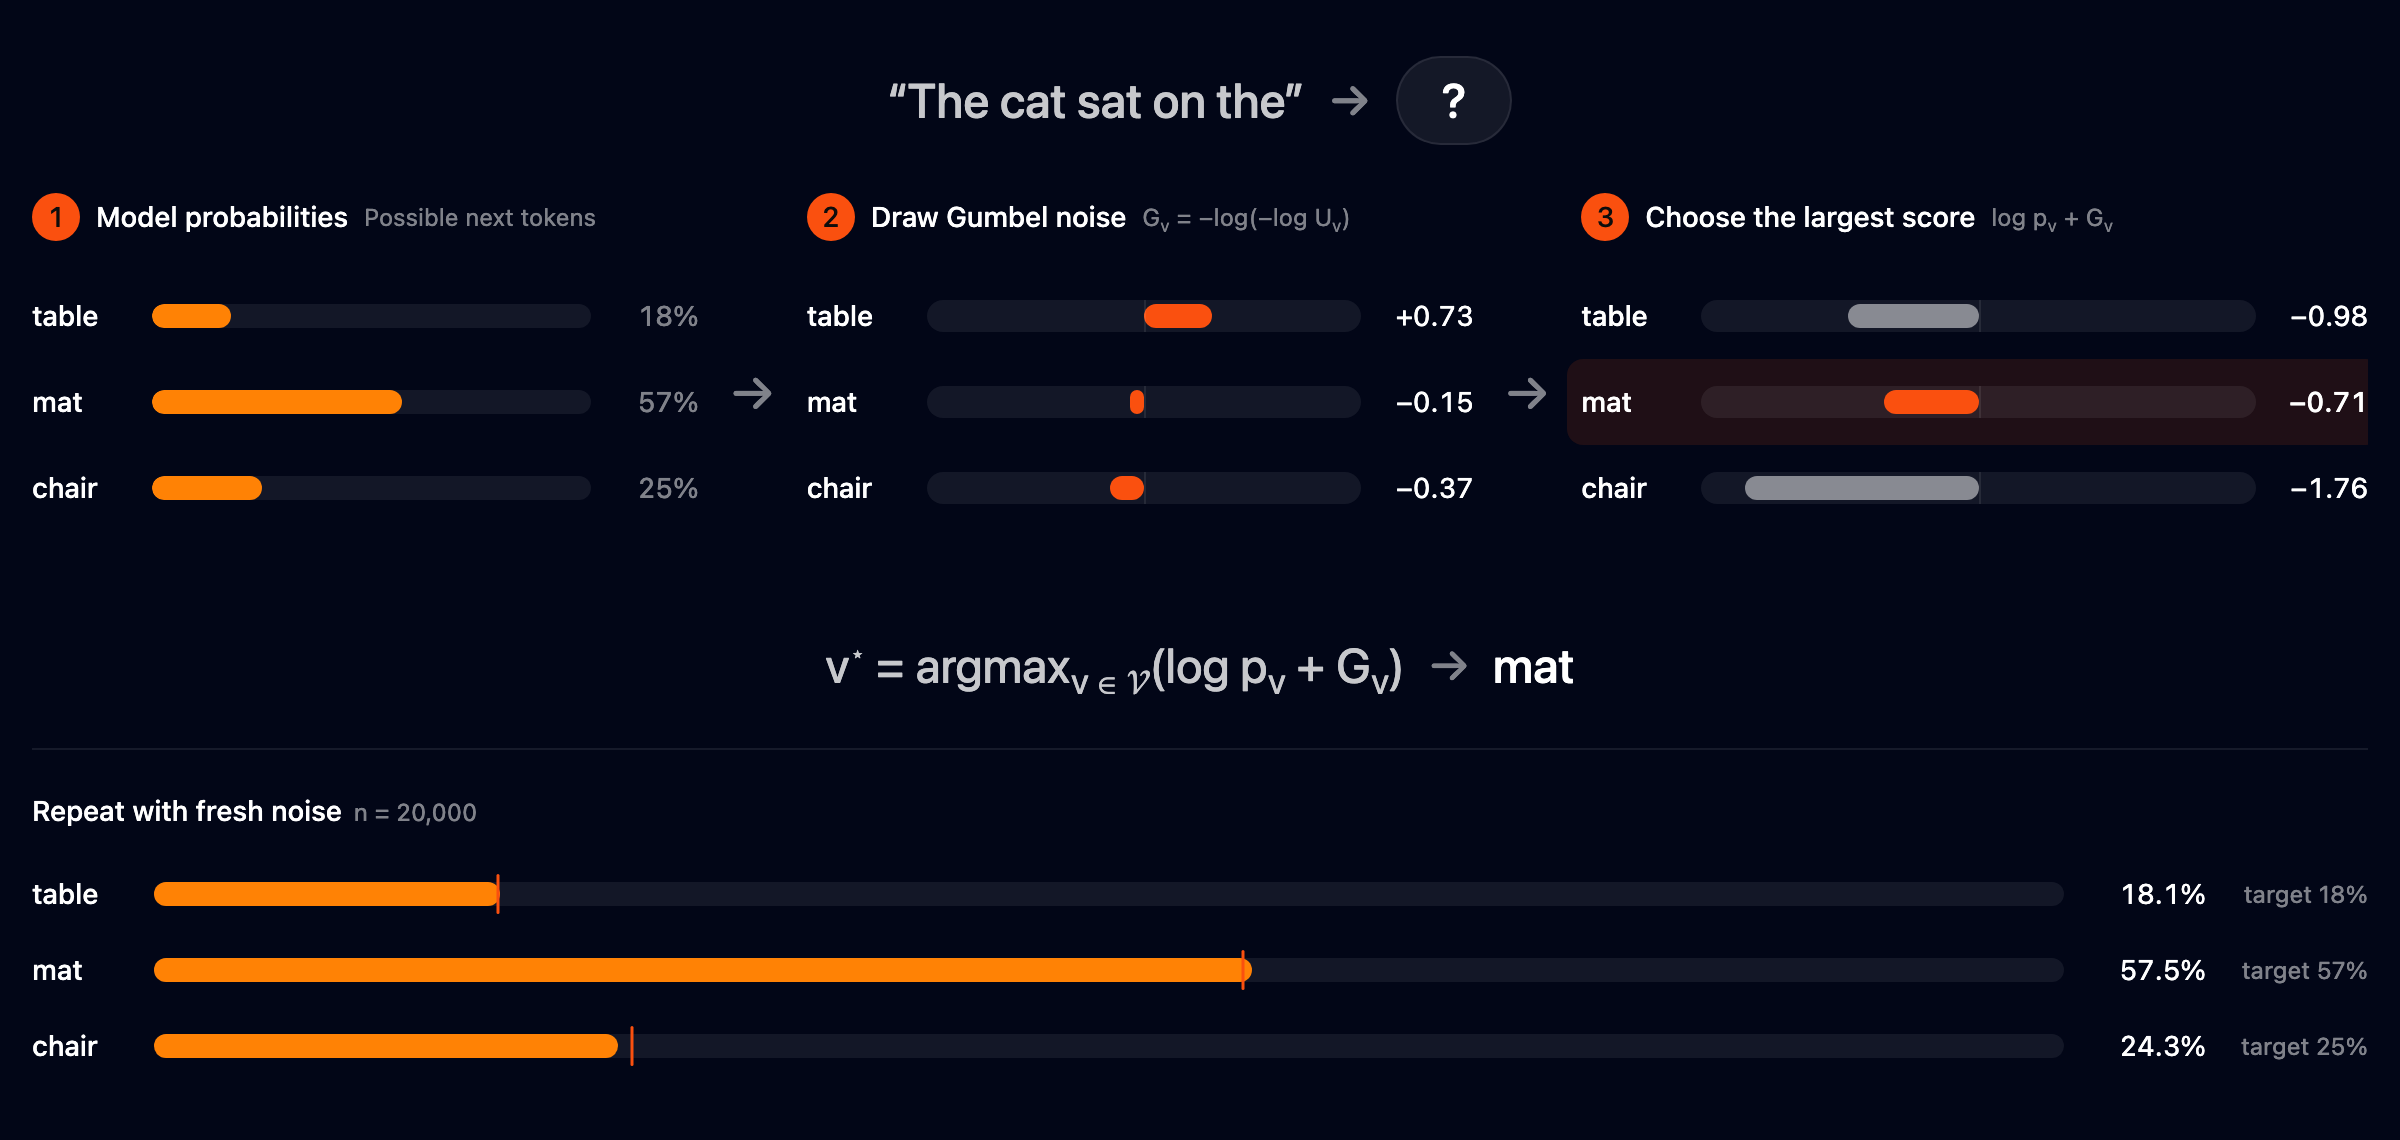
水印把这里的随机数换成由密钥、最近上下文和候选 token 算出的伪随机值。原文默认上下文取前 4 个 token。知道密钥与上下文,检测器就能按同一规则重算数值,检查文本中的 token 是否更常落在高分一侧。
检测不需要模型权重或 logits,只需要匹配 tokenizer 和水印密钥。这种信号来自生成时的 token 选择,并没有作为独立标签附在文本文件上。
单个 token 的分布保持,整段文本仍可能走偏
Section titled “单个 token 的分布保持,整段文本仍可能走偏”关键字眼是“每个位置”。单 token 的期望分布保持,不足以保证整段序列与普通采样完全相同。同一上下文再次出现时,密钥会重建同一组噪声,后续选择便有了相关性。如果下一步的 token 概率与先前相近,噪声可能再次推高同一个选项,输出随之重复或变长。

输出长度曲线来自:vLLM 原文。它比较了普通水印、双密钥和上下文去重。
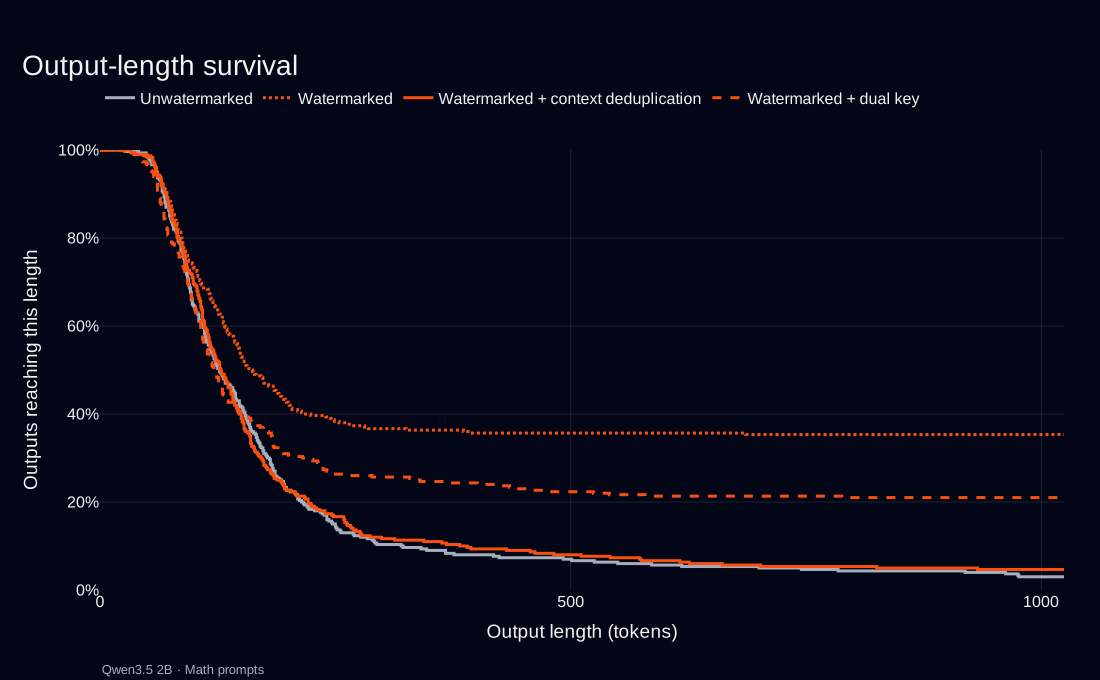
vLLM 用两种方法处理这类问题。双密钥分别给 draft token 和 target 的 residual、bonus token 加水印,让 speculative decoding 保持原有接纳率;上下文去重则跳过已经出现过的上下文。前者照顾推测采样,后者减少重复噪声造成的序列偏置。

如果想补 speculative decoding 的背景,可以接着读本站的《LLM 变快的秘密,是让大模型少做几次决定吗?》。在这篇水印实现里,draft 与 target 如何交接也会影响信号分布;双密钥让水印能进入这条采样路径,同时不改它的接纳率。
p 值衡量一次检验,不替文本认领作者
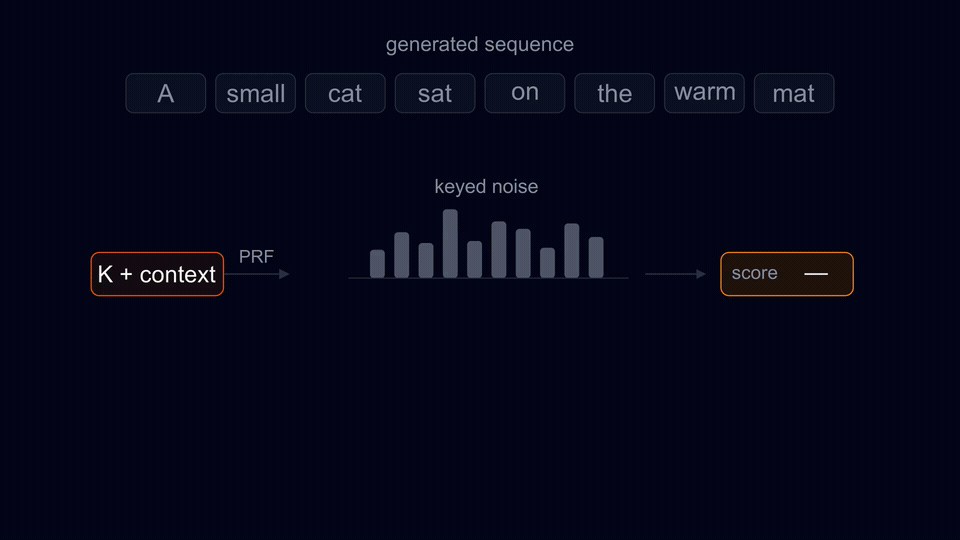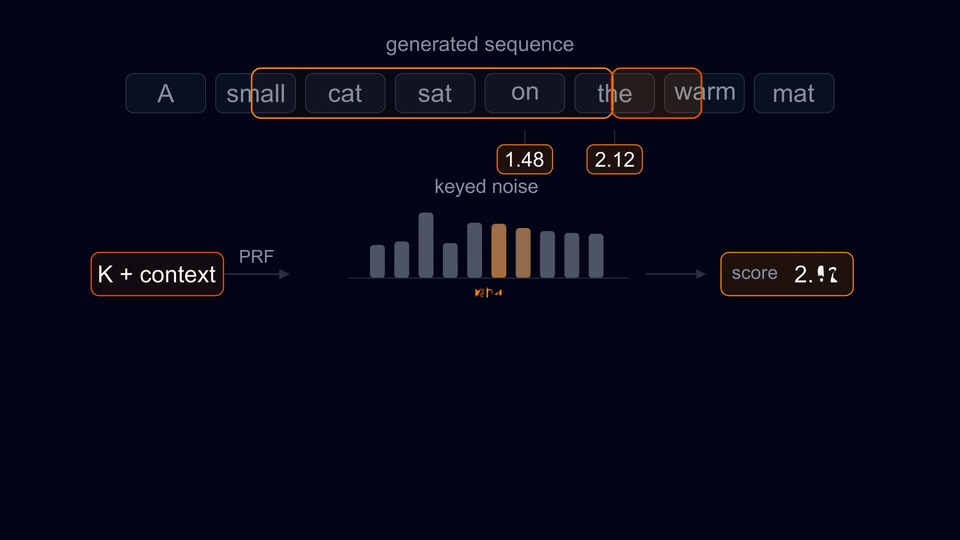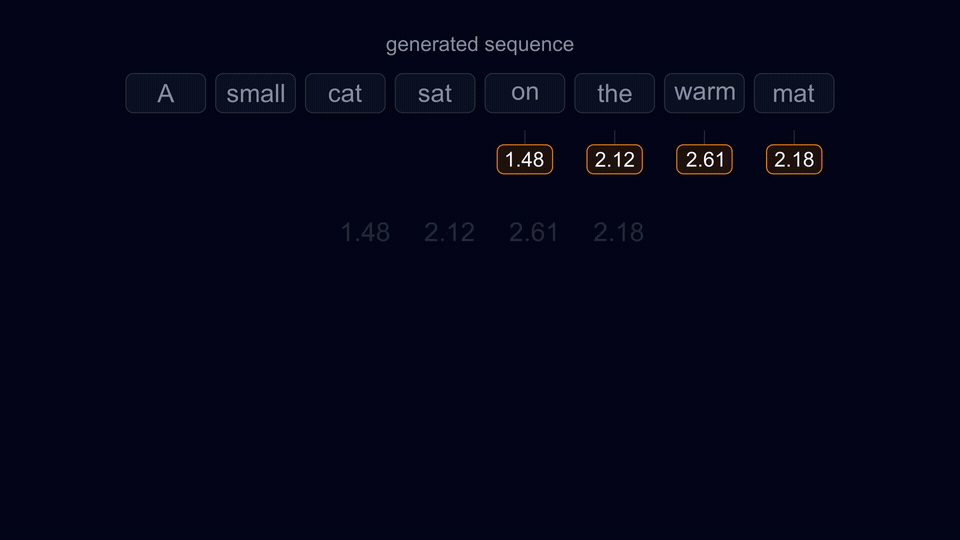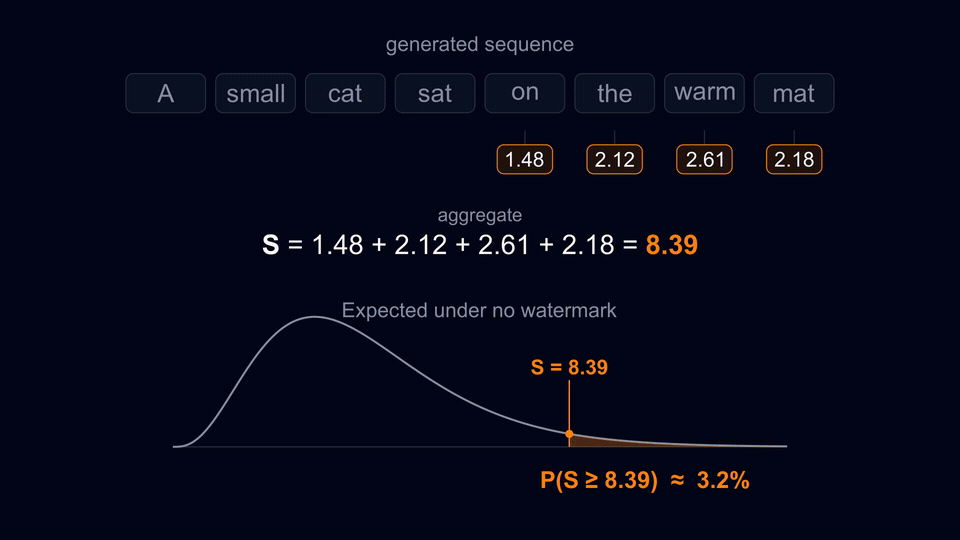
Section titled “p 值衡量一次检验,不替文本认领作者”检测器把文本还原成 token ID,再按密钥和上下文重算每个实际出现 token 的随机值。原文将它们变成 -log(1-U) 分数并求和。在无水印假设下,每项服从均值为 1 的指数分布;若计分项相互独立,总分服从 Gamma 分布,因而可以计算“无水印文本取得这么高分或更高”的概率。
这里的 p 值是相对于无水印假设的尾部概率,不是“AI 写作概率”。原文说,经过校准后,p ≤ 0.01 会把约 1% 的无水印序列判为阳性。若检测器还尝试多个密钥、tokenizer 或配置,偶然撞出高分的机会会增加,需要做多重检验校正。

检测动画来自:vLLM 原文,演示逐 token 重建噪声、累加分数并得到 p 值。
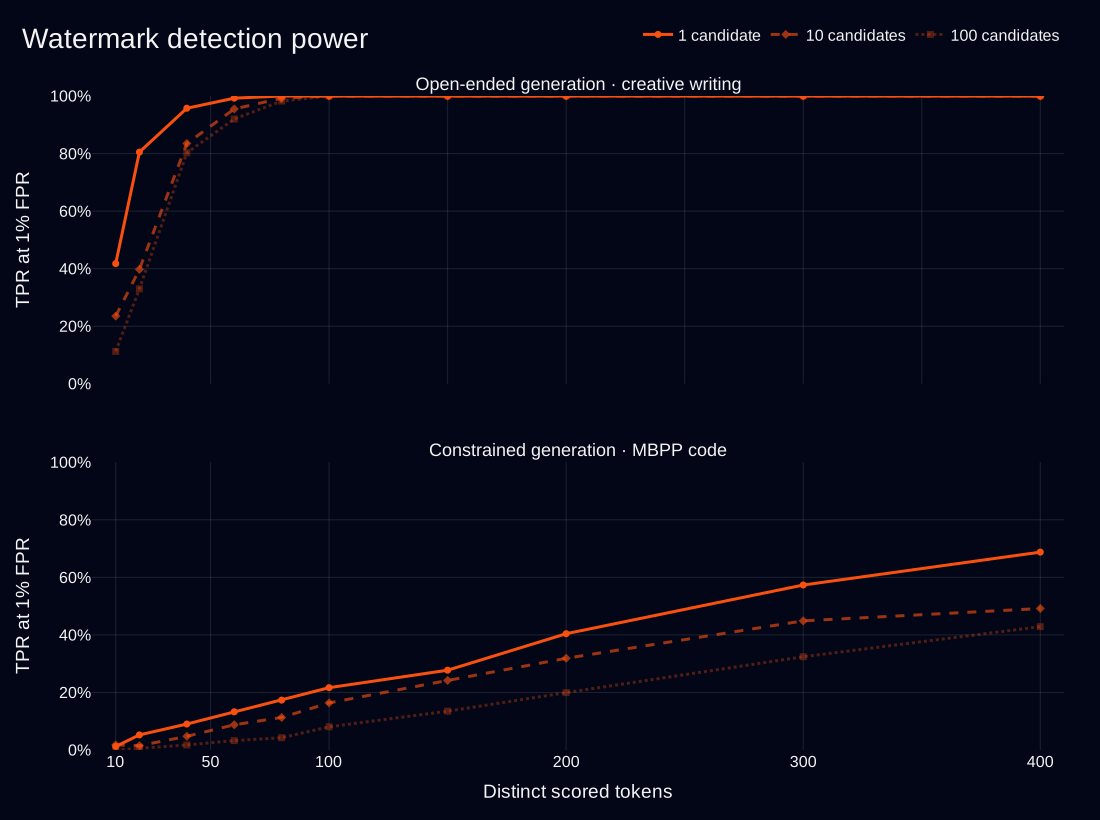
检测力也不是一个固定常数。原文图表中,创作文本在约 100 个 distinct scored tokens 时已接近满检出;MBPP 代码要到 400 个计分 token,单候选检验约为 69%,10 个候选约 49%,100 个候选约 43%。文本越短、下一个 token 越容易预测,可供水印留下的信号就越少。一个阈值不能把这些差异抹平。

检测力图来自:vLLM 原文。横轴是 distinct scored tokens;MBPP 曲线明显低于创作文本。
密钥安全和测量范围,决定它能被用来做什么
Section titled “密钥安全和测量范围,决定它能被用来做什么”对照当前的 vLLM 水印文档再看“secret key”,安全边界更清楚:默认 Philox 适合并行生成,但不是密码学 PRF,也不提供密钥恢复安全性或抗伪造保障。检测器需要匹配密钥、tokenizer 和算法配置;检测结果本身没有密码学认证。
重复上下文去重也有扫描范围。当前文档默认最多回看 8,192 个位置;窗口设短了,保护范围就随之缩小。若扫描完整请求,成本会随着序列增长。
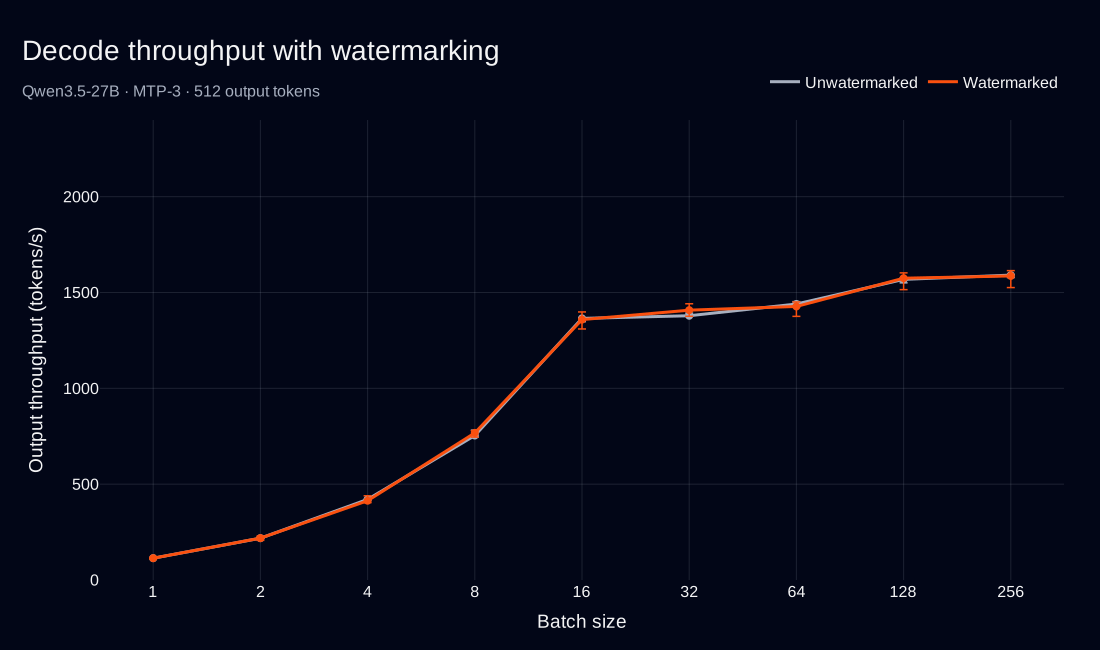
吞吐数字也得连同测试条件一起看。vLLM 原文在一张 H100 上运行 Qwen3.5-27B、MTP-3 和 512 个输出 token;不同 batch size 下,匹配后的平均变化约为 −1.1% 到 +2.0%。重复上下文去重在该模型上的端到端吞吐变化最多 0.19%。这些数据说明作者测了具体实现,不能替所有模型、硬件和请求分布背书。

解码吞吐图来自:vLLM 原文。横轴是 batch size,纵轴是输出吞吐。

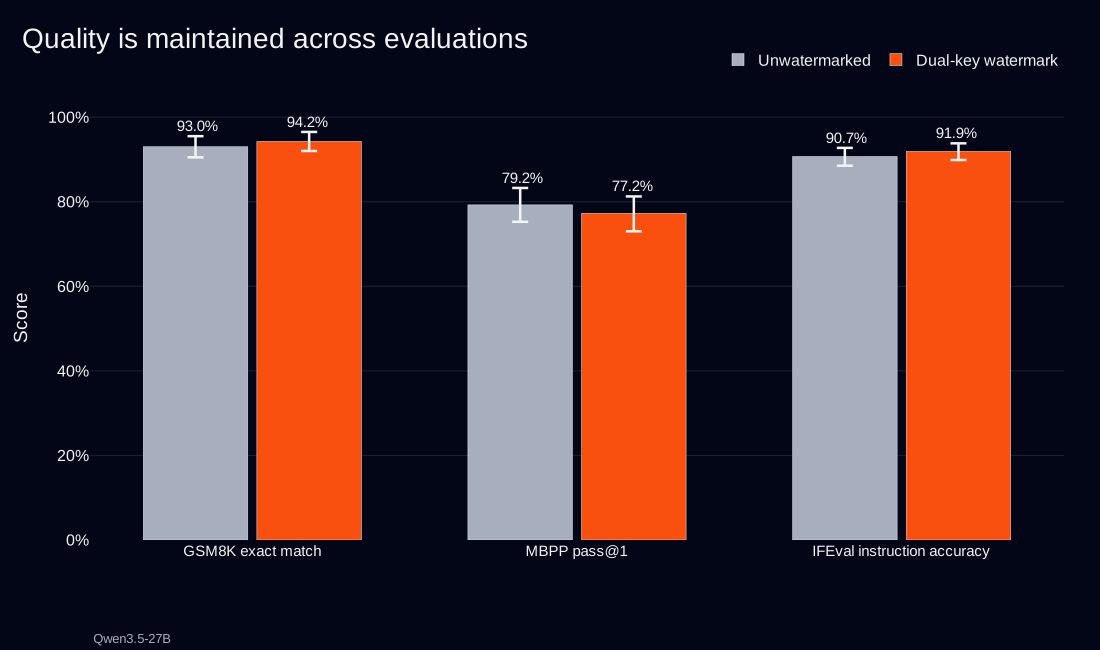
质量评测图来自:vLLM 原文。三个任务的分数方向不完全一致,误差棒有重叠,适合当作特定评测结果看。
我会把这项能力当作统计筛查工具。要从大量文本里挑出值得复核的样本,它可能有用。若命中结果会影响处罚、署名或合规追责,还得配上密钥管理、检测校准,以及独立的生成记录或签名证据。检测器给出的是文本与某套生成规律的统计吻合度,决策方却可能要求它回答作者是谁;这需要不同的证据。
- Watermarking in vLLM:原文、公式和图表
- vLLM 当前 Text watermarking 文档
- vLLM 水印 RFC #53916、初始实现 PR #54053、双密钥与 speculative decoding PR #56122
- context dedup 讨论 PR #56233、Model Runner v2 采样源码、HTTP 检测服务示例
- Dathathri 等:Scalable watermarking for identifying large language model outputs,Nature (2024),补充材料
- Kirchenbauer 等:A Watermark for Large Language Models,ICML (2023)
- Aaronson 与 Kirchner:Watermarking GPT outputs(2023)
- Sander 等:TextSeal: A Localized LLM Watermark for Provenance & Distillation Protection,arXiv (2026)
- 本站:LLM 变快的秘密,是让大模型少做几次决定吗?