别把 26% 当成 AI 修补能力的总分
我读完 Trail of Bits 这篇反驳 1Password 的文章,第一反应不是在 26% 和 86% 之间选一个。我更想知道:这两个数字到底在回答什么问题?
26% 是 1Password FLAWED 研究里的 clean-fix rate。86% 是 Trail of Bits 重新筛选一部分试验后,统计能阻断给定 exploit 的比例。它们都可能是真的,但不是同一道题的答案。把它们放在同一条排行榜上,反而会把真正的问题遮住。
我觉得这篇文章的价值就在这里:它把争论从“谁的数据更好看”拉回到 benchmark 的分母、工具条件、评分器和后续返工。读完之后,我对 AI 自动修补没有突然变得乐观或悲观,但我确实更不愿意接受一个脱离工作条件的百分比。

先把 26% 放回论文,而不是标题
Section titled “先把 26% 放回论文,而不是标题”1Password 的研究测的是一个很具体、也很苛刻的目标:给 6 个近期披露、影响较大、修复复杂的漏洞生成 patch。论文把结果分成 S1 到 S5 五种情况,S1 才算 clean fix:所有已知 exploit path 都被缓解,与漏洞无关的应用行为没有不当变化。
在 6,080 次 valid iterations 里,S1 的平均比例是 26.0%。这个数字不等于“模型只有四分之一的时间能让漏洞暂时失效”。它把完整路径、行为变化和新漏洞都纳入判断,所以比单纯跑通一个 reproducer 严格得多。
我希望更多研究都把目标写得这么清楚。问题在于,标题和传播过程中常常只剩下“26% clean fix”,读者很容易忘记这个结果来自 6 个专门挑出的复杂漏洞。论文自己也承认,这是困难样本,是某个时间点的 snapshot,绝大多数 verdict 还依赖模型做 validator。
所以我会把 1Password 的研究分开看:它确实暴露了窄路径修复、脆弱 guard 和新回归;但它的平均值不能自动变成“AI 修补日常漏洞的成功率”。这两个判断并不冲突。
Trail of Bits 反驳的重点,是 headline 把条件折叠了
Section titled “Trail of Bits 反驳的重点,是 headline 把条件折叠了”Trail of Bits 抓住的不是“26% 太低”,而是这个标题把不同的试验条件揉成了一个看起来很精确的数字。
- 样本只有 6 个,而且是因为修复复杂才被选中。不同漏洞的 clean-fix 结果从 3% 到 60% 不等,均值很依赖样本组合。
- 两类 prompt 明确要求 agent 采用错误的修复方向,占数据的 22%。这类试验可以用来研究错误指导的伤害,却不该和普通修复尝试混成一个日常成功率。
- 不允许 agent 构建或运行代码的模式占数据的 36%。能否测试 patch、能否根据测试结果继续修改,本来就是修复流程的一部分;把禁止测试的结果和可测试的结果平均起来,解释空间自然会变窄。
- GPT-5.5 用 medium effort,Opus 4.8 用 high effort,都是工具默认值。研究没有测试最高 effort,也没有告诉我们增加 effort 会带来什么变化。
Trail of Bits 随后做了一个很容易被误读的 reanalysis:在可以运行代码、没有被要求采用错误修复、也没有查到上游修复的试验里,3067 个 patch 有 2634 个阻断了给定 exploit,也就是 86%。
但原文紧接着加了一句限制:阻断给定 exploit,不代表完整修复。这句限定比 86% 本身重要得多。一个 patch 评测至少要过两道门:先看眼前的攻击样例是否失效,再看根因的其他路径、生命周期和未改变的行为是否仍然安全。
单凭“有人工抽查”也不能解决评分器的问题。论文记录的完整五类结果与人工审查一致率是 65.9%;只看原漏洞是否修复,一致率是 87.7%;看是否引入新 bug,一致率是 70.5%。两个模型对同一 patch 给出不同 outcome 的比例是 36.8%。这些数字不证明论文所有结果都错,却说明 validator 不能被当成透明的玻璃。
Linux Copy Fail 的例子更具体:研究者找到 248 个 patch 重复了上游修复里的 off-by-one,自动 grader 只捕获了其中 24 个。Chromium 的 case study 也显示,模型经常把第一处 pointer lifetime 处理好,却漏掉 callback 里需要的第二个引用。模型可能已经通过了看起来合理的局部检查,漏洞却只是换了一个位置。
我的第一个判断是:benchmark 的风险不只在于分数高低,更在于读者可能忘记这个分数是怎样被制造出来的。
我更愿意记住 freenginx 的 cleanup crash
Section titled “我更愿意记住 freenginx 的 cleanup crash”Trail of Bits 文章里真正让我停下来的是 freenginx 的案例,不是 86% 这个数字。
原始漏洞和 Perl 回调的生命周期有关:回调被保存下来,真正执行时却可能已经失效。Trail of Bits 的 patch 让回调在等待期间保持存活,但没有覆盖另一条路径;维护者后来提交的另一份修复覆盖了 3 条 vulnerable code paths,却在 request cleanup 阶段引入了同一个 crash。
两份 patch 的作者不同,走过的路径也不同,最后却撞上了同一个生命周期陷阱。请求先超时、对象开始清理、释放引用又触发了仍在使用 request 的代码,真正需要检查的东西已经超出了原始 PoC 的那一瞬间。

这个案例把“人类 patch”和“agent patch”的对立拆掉了一点。人类当然可能更容易提出正确的抽象,但维护者接受的实现也可能留下回归;agent 当然会沿着显式目标走窄,但只要验证器同样只看局部路径,人类流程也会被它骗过去。真正需要比较的不是身份标签,而是两边是否在同样的任务、反馈和审查条件下工作。
我之前写 ITBench-AA 时,印象最深的是:一旦评分函数要求找全根因而不是多报几个可疑对象,Agent 的“多调查一会儿”就不一定等于更好的答案。这个 patch benchmark 也是同一类问题:成功的定义一变,模型看起来的能力边界就会跟着移动。
人类 baseline 不是 AI 的奖状,而是测量纪律
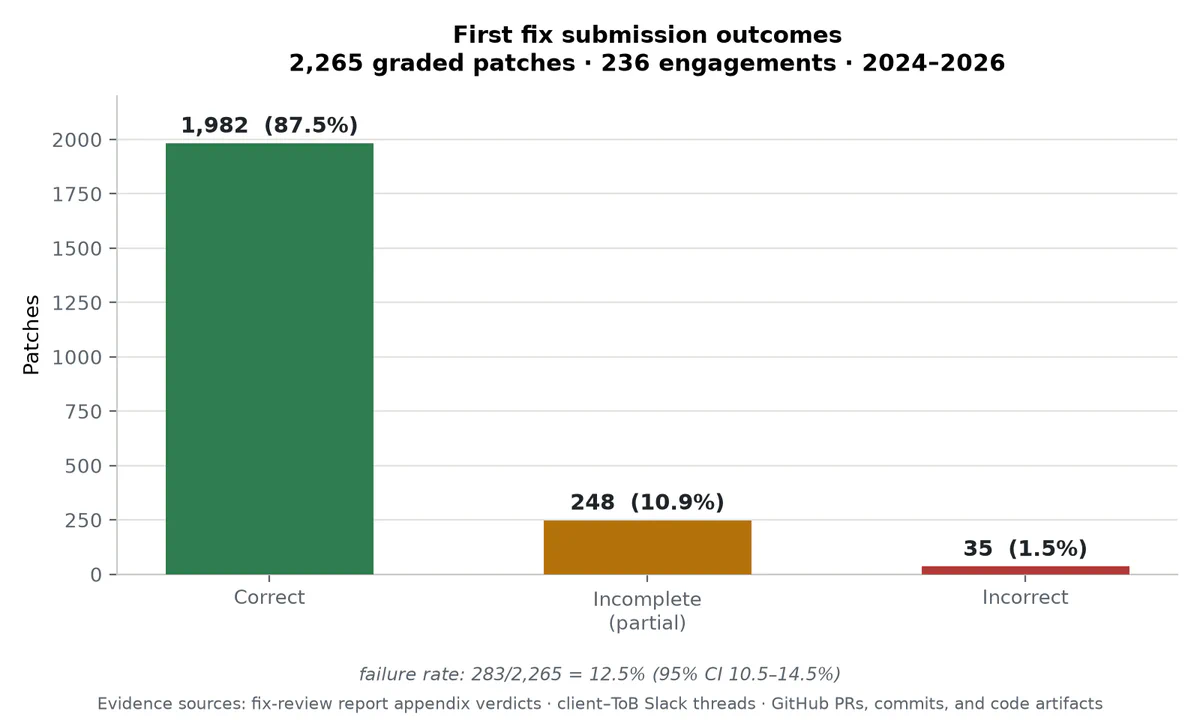
Section titled “人类 baseline 不是 AI 的奖状,而是测量纪律”Trail of Bits 用自己的 fix review 记录补了一个重要对照。他们检查了 2,265 个漏洞的首次修复,其中 283 个没有完全解决报告的问题,失败率为 12.5%,按 assessment 相关性调整后的 95% 置信区间是 10.5%–14.5%。原文很谨慎:这些开发者拿到了详细的安全报告,也知道 patch 会被复查;这仍然不是和 agent 同任务、同环境的对照实验。
这张图没有把人类“扳回一局”。它给出的信息更朴素:即使有人读过报告、知道之后会有专家 review,首次修复仍然会留下 incomplete 或 incorrect 的结果。AI benchmark 应该测“生成 patch 后还需要多少验证和返工”,不能把人工能力想象成零失败的金标准。
Patch the Planet 的后续记录把这个问题延长到了 merge 之后。Trail of Bits 统计了已合并或关闭的 186 个 PR,其中 126 个合并,合并率为 67.7%;在已合并的 PR 里,有 91 个、也就是 72.2%,没有观察到维护者对原始安全修复做安全相关修改。对约 33,500 个后续 commit 的追踪至少找到了 10 个功能 bug、4 个构建/测试/发布自动化 bug 和 1 个性能 bug,没有发现可利用的安全漏洞。
我不会把这些结果简化成“agent patch 很好”,也不会因为维护者合并了就说“所以没问题”。维护者合并是一个真实的工作流结果,却不是形式化的 correctness proof;后续 commit 也只会暴露一部分问题。它们至少把 patch 的观察窗口拉长了:代码提交时看起来正确,运行一段时间后仍可能需要修订。
这和我以前写的 《GPT-5.5 网络能力评估:第二个了,这才是最可怕的》 可以接起来看:安全能力的 headline 适合提醒我们趋势,不能替我们完成风险建模。这里的风险建模对象从攻击能力换成了修复链路,纪律还是同一条。
一个诚实 benchmark 至少要回答五个问题
Section titled “一个诚实 benchmark 至少要回答五个问题”Trail of Bits 最后的建议让我想起它们 2018 年那篇关于 fuzzing research 的 checklist。技术对象变了,评测纪律没有变。我把它压缩成五个问题:
- 样本代表什么?如果只选复杂漏洞,就把结果称为复杂漏洞压力测试;想谈一般能力,就要说明普通漏洞的抽样方法,或者把两种结果分开。
- Agent 实际拥有什么条件?Prompt 是否正确,能不能读代码历史,能不能构建和运行,能不能看到测试反馈,模型 effort 如何设置,这些都应该成为结果的一部分。
- “修好”到底是什么意思?给定 PoC 失效只是入口。完整定义还应覆盖所有可达路径、行为保持、新漏洞、错误路径和清理路径。
- 谁在打分,参考答案可靠吗?LLM validator 可以扩大处理规模,却不能因为输出结构漂亮就被当成 ground truth。它需要独立的专家抽查、结构检查,以及对参考修复自身的审查。
- 交付成本是多少?生成一个 patch 只是起点。人工 review、返工、重新测试、维护者修改和 merge 后回归,都是 agent 为结果贡献的真实成本。
以后再看到“模型能修多少 bug”的 headline,我会先看这五个问题。它们不要求每项研究都变成巨型实验,只要求研究者把想回答的问题和实际测量的对象对齐。困难样本可保留,但不要把压力测试包装成日常平均值;自动验证可以使用,但不要把“不知道”写成“安全”。
我的结论:继续用 Agent,但不要把 patch 交给分数
Section titled “我的结论:继续用 Agent,但不要把 patch 交给分数”读完这篇反驳,我仍然会让 Agent 参与漏洞修复,尤其是搜索相似路径、补测试、生成候选 patch 和整理 review 证据这些工作。但在高风险修复里,我不会把“测试通过”或“benchmark 分数高”当作交付条件。
更实际的流程应该是:先让检查在易受攻击的版本上确实失败,再让它在 patch 版本上通过;至少补一条由同一根因推导出的变体;检查与漏洞无关的既有行为;把新漏洞和生命周期边界单独拿出来验证;如果构建坏了或依赖缺失,就把结果标成 inconclusive,而不是把失败当成安全证据。Trail of Bits 发布的 post-patch-validation skill 正是在把这条纪律写成可执行流程,且原文明确说明它没有用于前面那批 Patch the Planet 工作。
对我来说,AI patching 的进步首先应该体现在验证回路上:路径查得更全,错误提示和回调生命周期被记录下来,merge 后的回归也有人跟进。只有这样,我们才知道 Agent 到底帮了多少忙。一个脱离这些条件的百分比,最多说明某次实验怎样结束,不能替我们宣布修复已经可靠。
- Trail of Bits:1Password’s AI patching benchmark is misleading
- 1Password:Off-by-1 Labs / FLAWED 研究说明
- 1Password:Frontier Models’ Vulnerability Patches are Often F.L.A.W.E.D.(PDF)
- FLAWED 代码与数据(固定 commit)
- Trail of Bits:How to Spot Good Fuzzing Research
- Trail of Bits:Patch the Planet
- Trail of Bits:post-patch-validation skill
- Trail of Bits:review-walkthrough skill
- Davi Ottenheimer:对 1Password 报告的独立评论