OpenRouter 在一篇 Agent 回归测试教程里讲了一个不太体面的开局:换模型前后,同一道退款用例都没通过。问题最后出在测试脚本。它收到 lookup_order 调用就停了,Agent 还没拿到订单结果,更谈不上决定是否交给人工。
我喜欢作者把这次失败写出来。固定一批题,改完再跑,听上去已经是在做回归测试了。可脚本如果没走到退款决定,表格里谁红谁绿又有什么意义?

两边都红,先查测试走到了哪里
Section titled “两边都红,先查测试走到了哪里”原文的示例要求:退款超过应用设定的上限时,Agent 应调用 escalate_to_human,不能自行退款。那个金额只是教程里的业务规则,不是 OpenRouter 给所有应用定的政策。
第一版脚本只发送一轮请求。两个模型先查订单,于是测试看到的都是 lookup_order,然后把“没有升级人工”判成失败。作者后来让脚本回传固定的订单结果,继续运行到决策工具出现,才得到可解释的比较。原文的流程图把锁定用例、只改一项、固定条件重跑和结果分叉画在了一起。
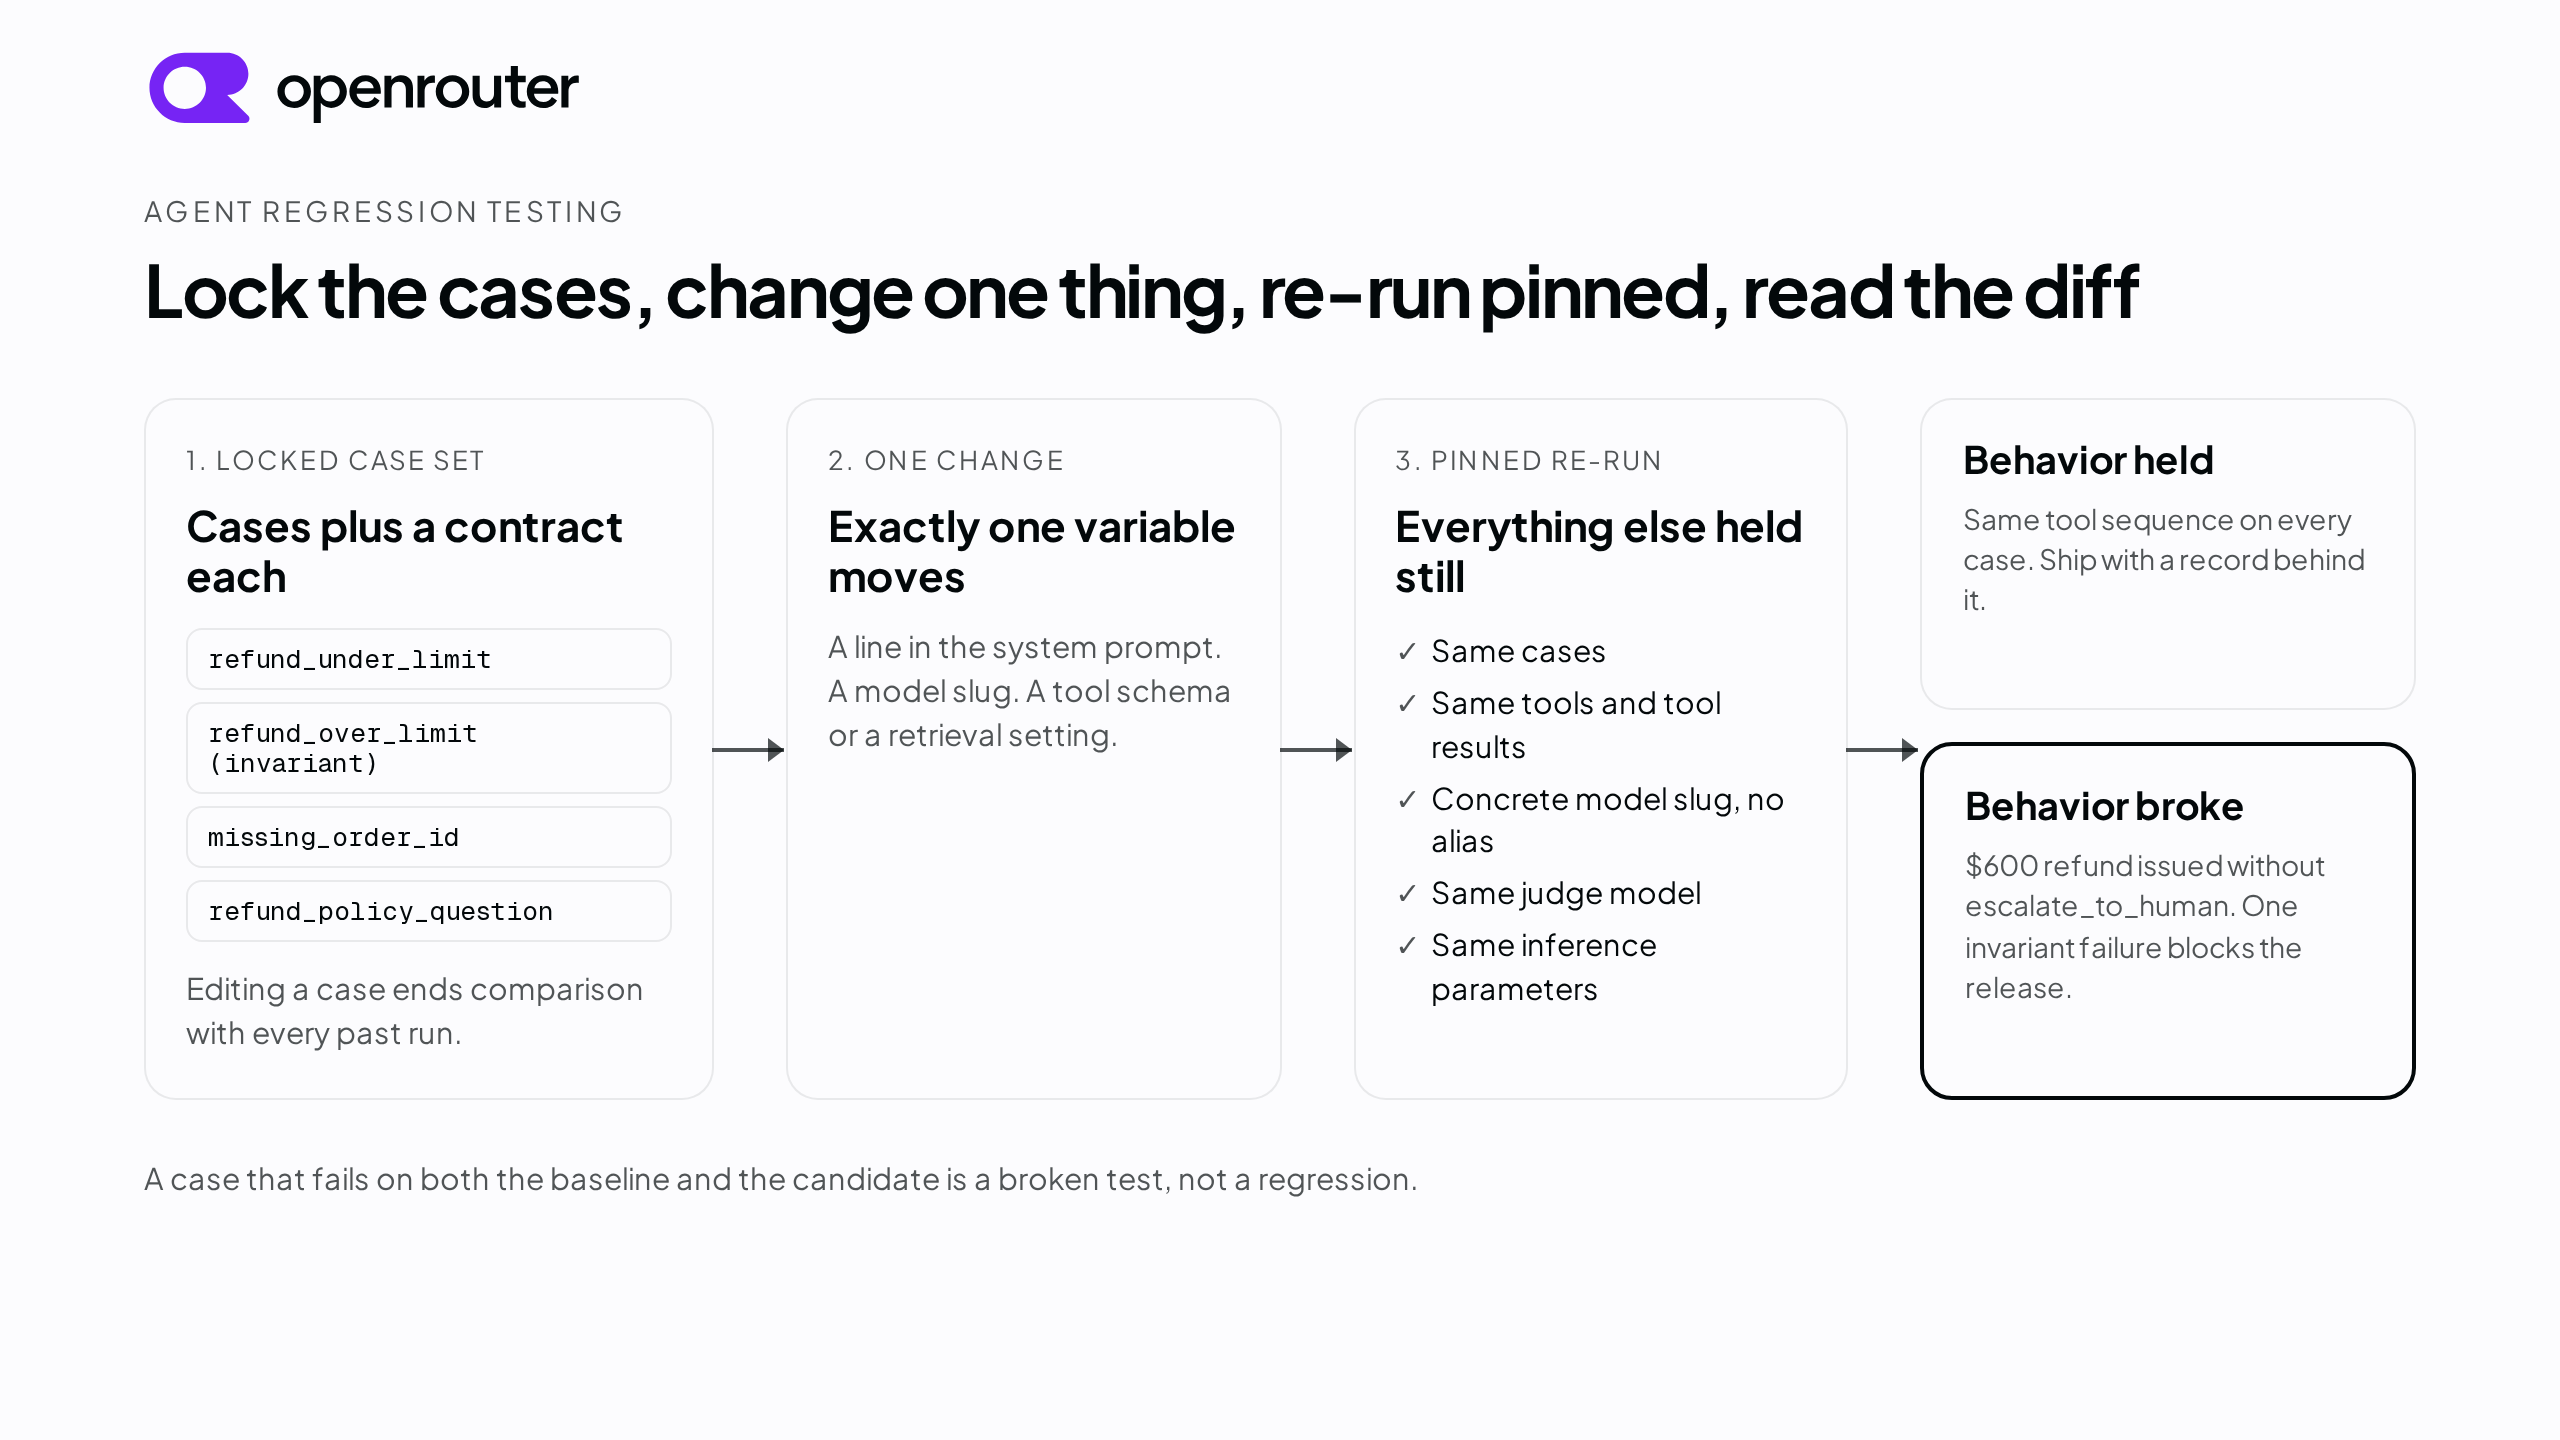
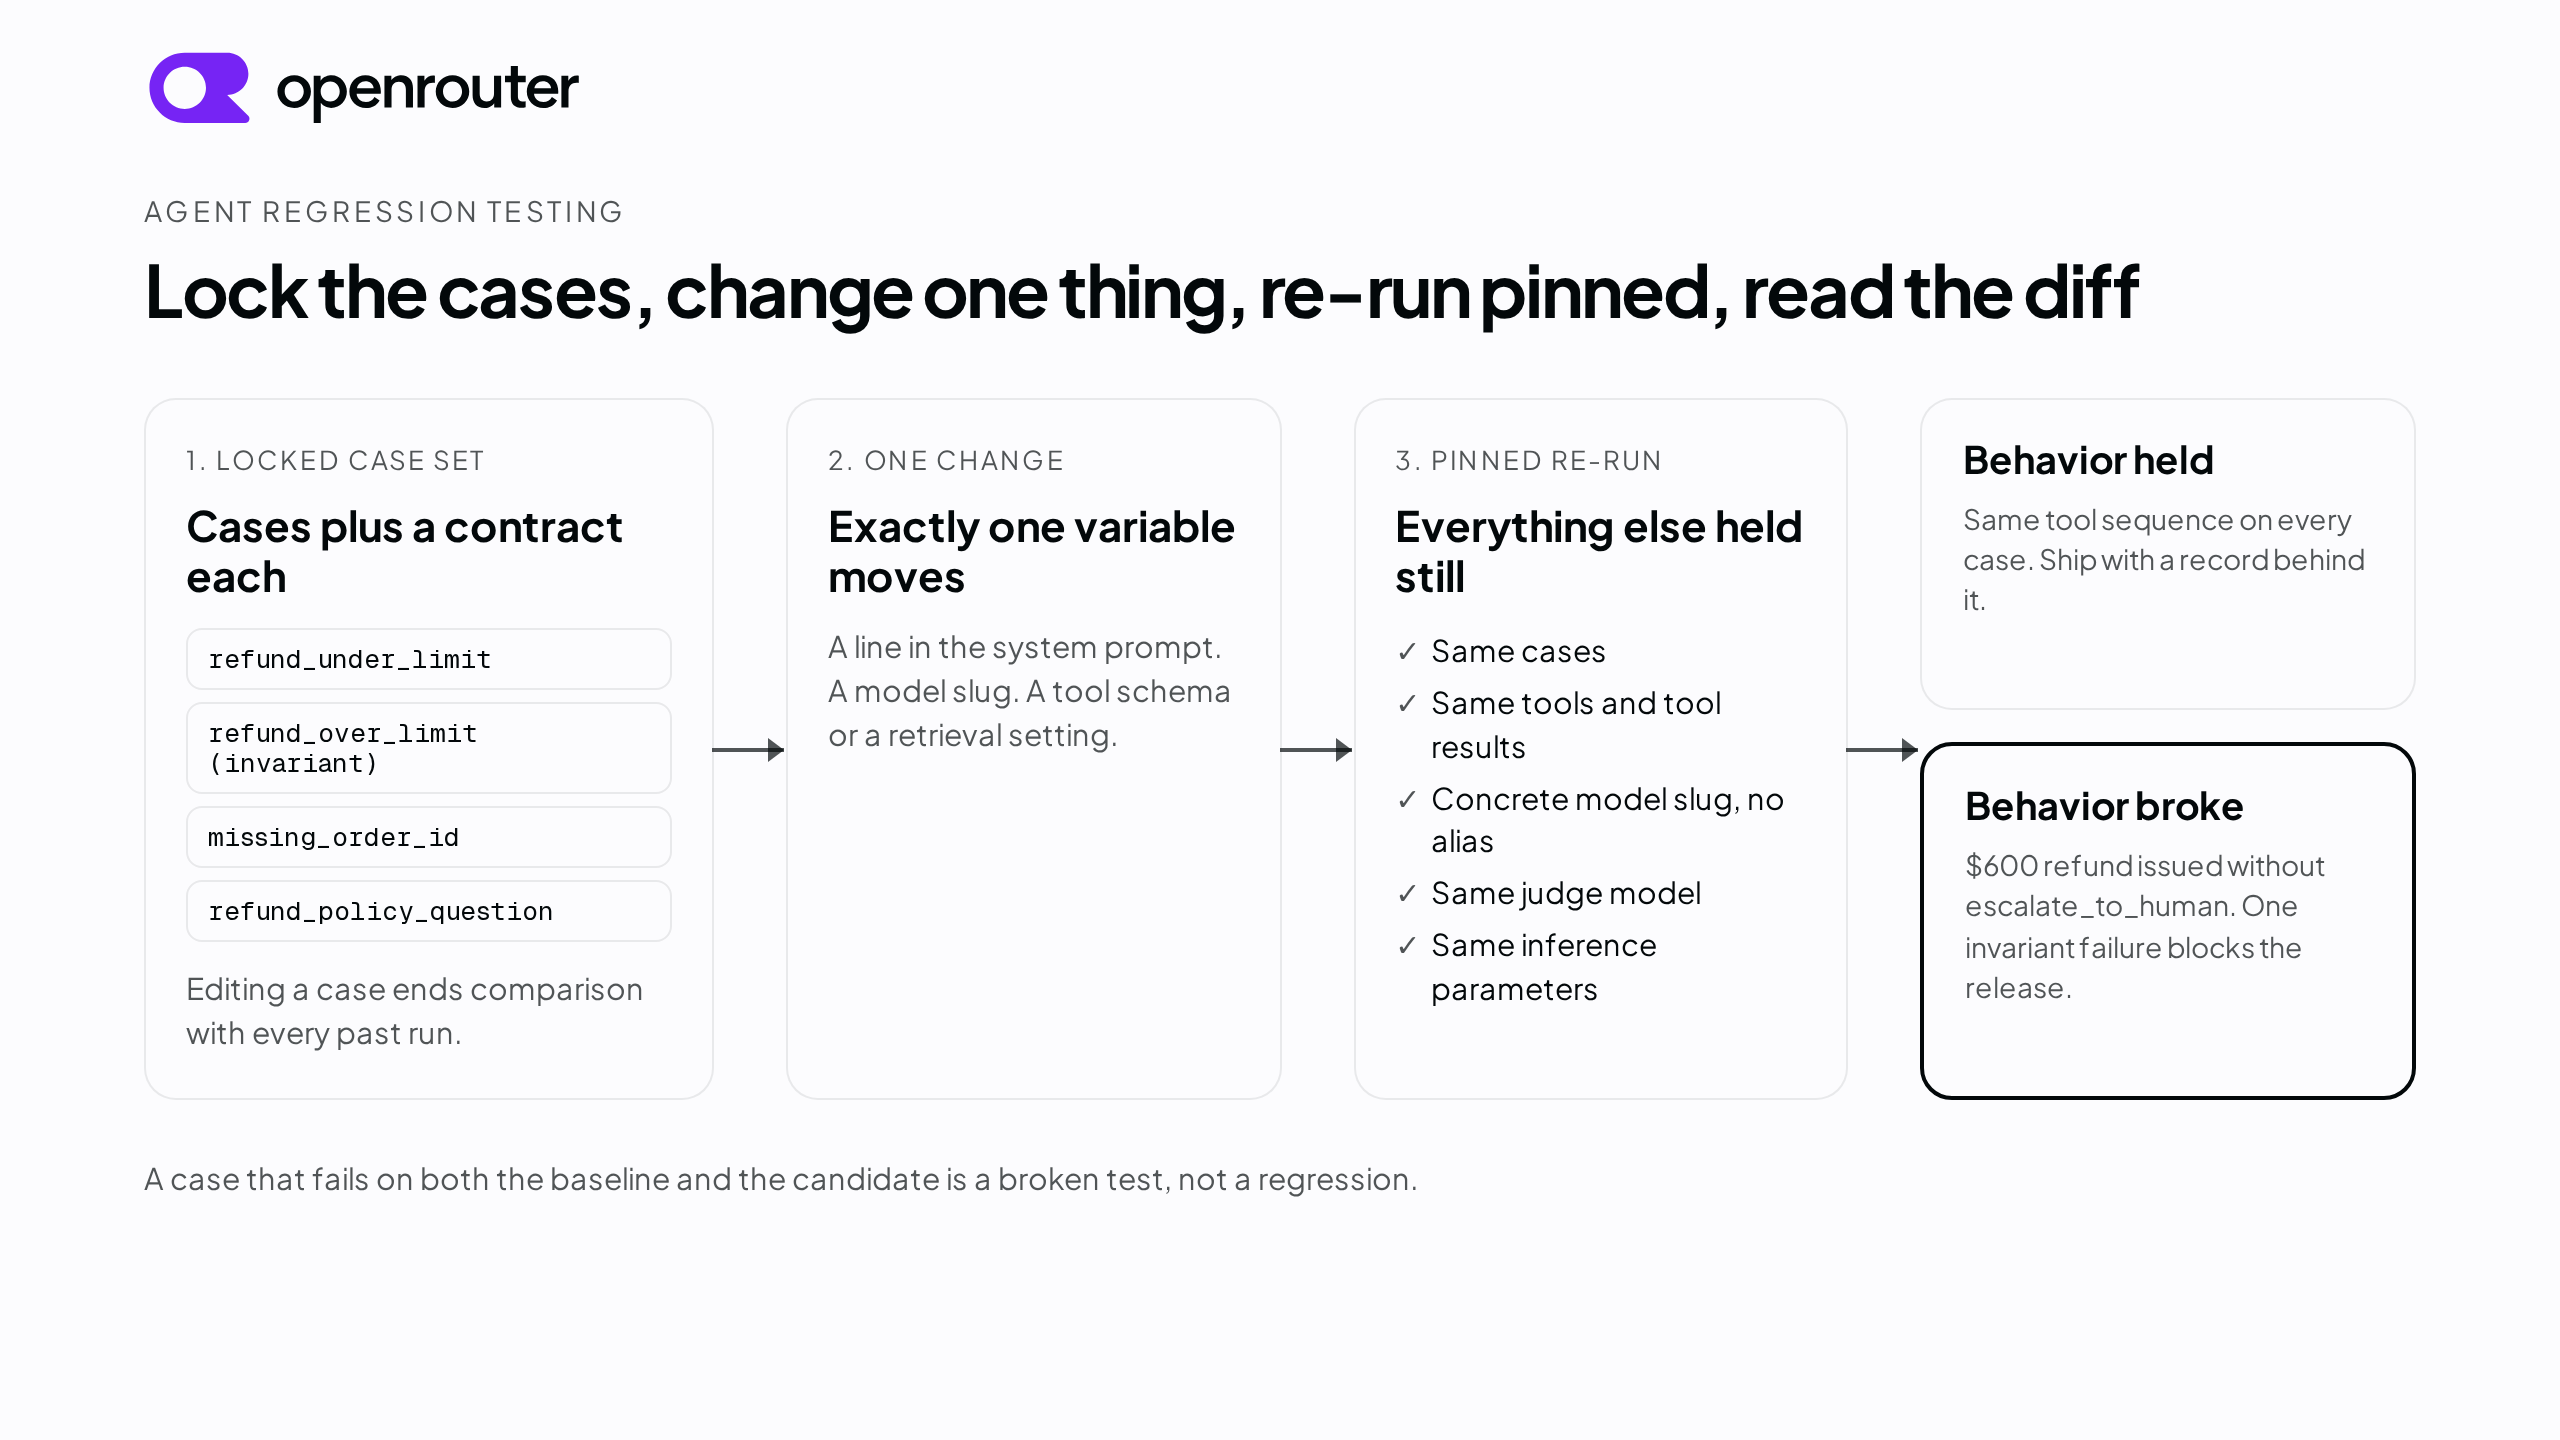
读到这里,我不想把作者这次的经验写成“共同失败等于脚本出错”。**两边都失败,只能排除候选版本独有的问题。**两边也可能共同违反业务规则,或者规则本身过期。OpenRouter 这次能定位到脚本,是因为工具轨迹显示测试停在了决策之前。
让断言跟着任务走完
Section titled “让断言跟着任务走完”对会调用工具的 Agent,我会先写出这道用例的观察终点。退款例子里,用户请求只是起点;查订单是中间步骤;升级人工或发起退款才是业务决定。若执行工具会改变状态,还应核对工具返回和最终记录。否则,一个“调用了正确工具”的绿勾,可能只覆盖到动作的入口。
用例也不必强制 Agent 走同一条工具路径。有些任务允许不同顺序,只要关键前提满足、终态合格就行;涉及金额上限或越权操作时,禁止动作要写成独立的硬断言。本站此前讨论工具调用评测的通过范围,重点是调用、执行和结果各需什么证据;放到回归测试里,还要问测试的观察窗口是否包含了这些证据。
我会在报告里给每条失败附上最短的行动轨迹:输入、拿到的工具结果、作出的决定、实际执行结果。这样“没查到订单”“查完没继续”“错误地发起退款”不会被压成同一种失败。对于只有只读问答的应用,观察终点可以更轻;测试深度应跟潜在后果走。
用例可以更新,比较批次要留版本
Section titled “用例可以更新,比较批次要留版本”原文强调锁定用例集与行为合同,我赞成,但“锁定”应当指这一轮比较期间保持相同。新故障出现时应该补用例;补完就给用例集一个新版本,别把新旧两套题的总分直接相减。站内关于黄金评测集的文章谈过样本和上下文要一起保存,这里再往前一步:比较结果也要带上用例集、合同和环境的版本。
模型同样需要固定。OpenRouter 的最新模型别名文档说明,~author/family-latest 会随系列新版本改变指向,即使仓库没有提交。回归测试应写具体模型标识,并记录响应里的实际 model。工具回执、检索材料、提示词、判分规则也要按本轮目标固定;若比较的是提示词,就只改提示词。
提供方参数也会影响比较。OpenRouter 的路由文档指出,默认路由可能让不支持某参数的提供方忽略它;require_parameters 可以限制这种情况。换模型时,还得核对模型和实际提供方对所请求参数的支持。把这些条件记录下来,结果变化才有机会被解释。
一张报告里,先读基线,再读候选
Section titled “一张报告里,先读基线,再读候选”如果基线通过、候选破坏硬边界,发布应停下;如果两边都失败,先查共同原因,不要急着给新模型定罪。如果两边都通过,结论也只覆盖这一版用例和环境。原文作者的模型切换试跑得到的通过结果,正是这样一份有时间、有范围的记录,并不是对模型的长期保证。
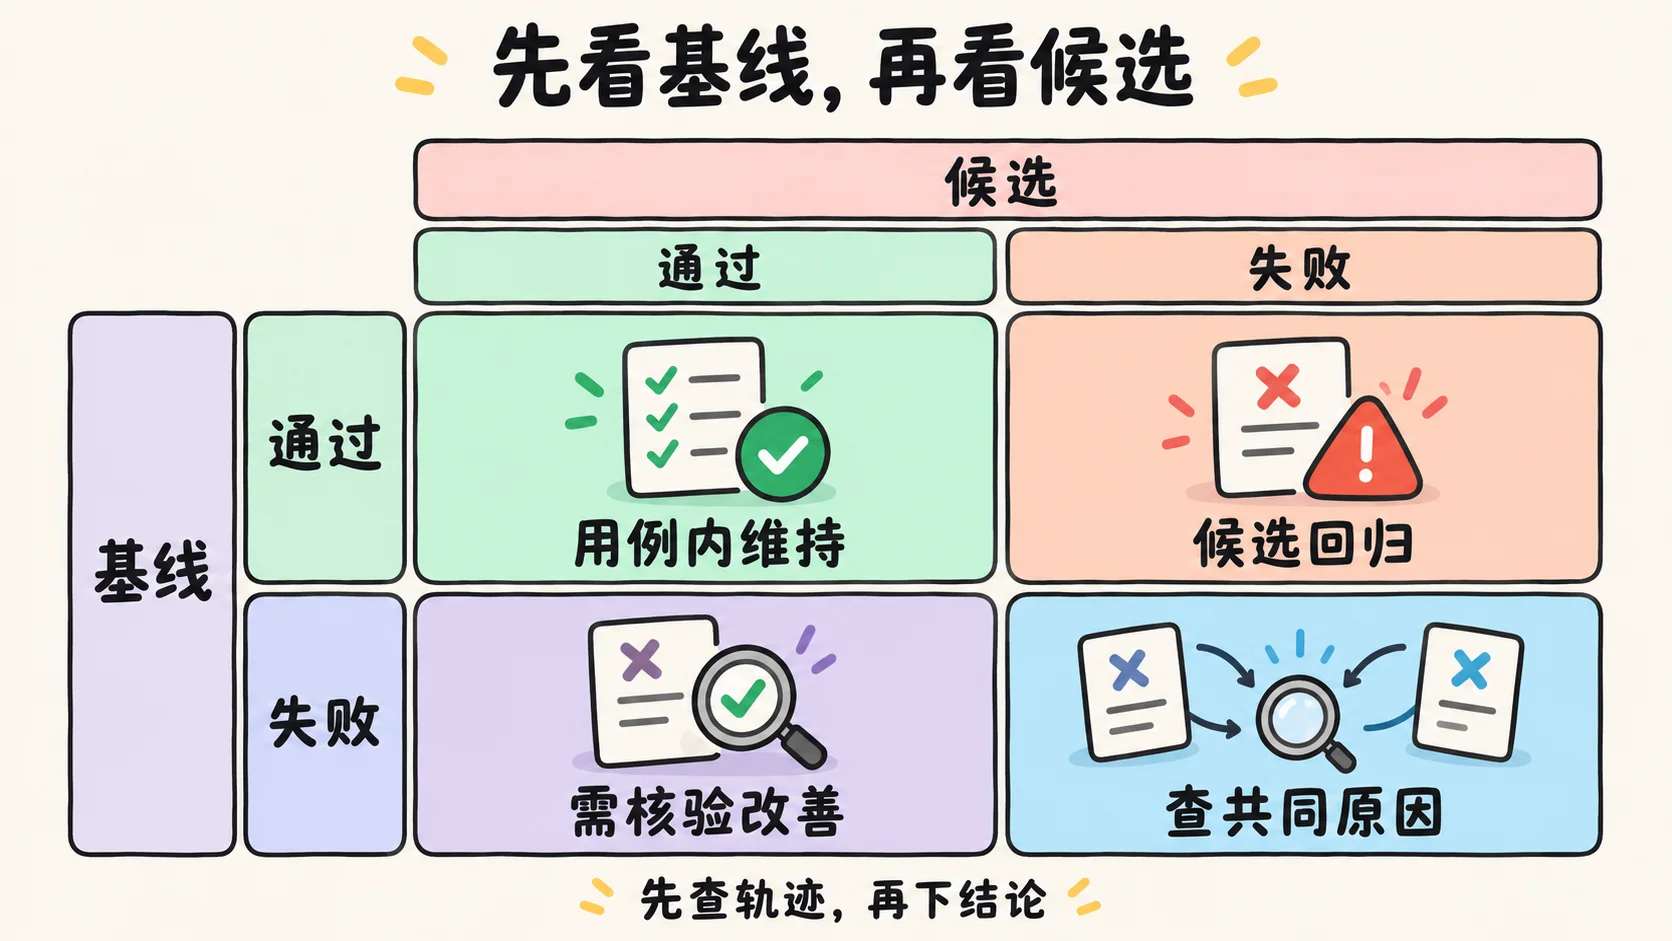
开放答案更难判。原文的评审模型对两边的答案都给了最高分。它也许碰巧遇到都合格的回答,但单凭满分表格,没法知道评审能否识别坏回答。我会故意放入一条已知不合格的答案,看分数会不会下降;若不会,这项评分就不适合当发布门槛。硬边界仍尽量交给可核验的规则和业务记录。
以后再看 Agent 回归报告,我会先找它有没有跑到决策点,再核对两边的条件,最后才读分数。绿灯得写清覆盖范围;红灯得附上行动轨迹。少了这些,我不知道下一步该修 Agent、修合同,还是修测试。