读 OpenRouter 工具调用评测指南:把“通过”读准确
我会先问评测证明了什么:参数格式、调用行为、业务结果和用户告知,需要各自的证据。一个“通过”,应当连着它的检查范围一起读。
读 OpenRouter 的工具调用评测指南,我开始留意测试报告里那个很容易被略过的词:通过。
它可能表示参数能被解析,也可能表示订单确实查对了。看到绿色结果时,如果不继续问检查了什么,就容易把接口层面的正确,读成对整个任务的保证。
我想沿着这篇指南,看看这种误读发生在哪里。下面的退款场景是为分析而设的例子;我没有运行文中的跨模型评测,也不会据此推荐哪个模型。

参数合法,离用对它还有多远
Section titled “参数合法,离用对它还有多远”原文把工具选择与参数正确性分开,又提醒读者:参数符合 JSON Schema,取值仍可能不对。样例脚本检查的是单轮响应里的调用,不是完整 Agent 执行。这些边界都写得明白。
顺着这个区分,我觉得测试失败的名字也应该写得具体。查订单时,把字符串误写成布尔值,是接口契约的问题;把甲的订单号传成乙的订单号,是信息对应的问题。后者即使格式再整齐,也需要回到用户请求和业务记录里核对。
再往前一步:假设用户只问“已发货是什么意思”,Agent 却去查了某个订单。返回的数据可能完全真实,调用也可能被服务接受,但它多做了一件用户没有要求的事。
Phoenix 的 Tool Selection 文档把“不需要工具却调用”列为错误。这使我更愿意把不调用也写成测试预期。测试集若只奖励行动,就没有认真检验 Agent 停下来的判断。
所以,报告里我希望看见的是“格式校验通过”“订单对应正确”“本场景无需调用”,而不是把这些结果揉成一个含义模糊的准确率。它们出错后,要修的东西也不一样。
沿着一次退款,把任务看完
Section titled “沿着一次退款,把任务看完”假设用户要求退掉指定订单,业务规则要求核实归属和退款资格。Agent 查对了订单,生成了合法退款参数,服务也接受了请求。
到这里,可以证明它提出了一次合适的调用。至于用户的钱是否退回,还要接着看执行结果。
把场景再变得麻烦一点:退款服务已经记账,但响应在返回途中超时。Agent 以为没有成功,又发起退款。如果后端没有防重复机制,就可能造成重复付款;如果后端正确拦住了重复请求,Agent 也仍需理解返回信息,不能把“重复操作被拒绝”解释成“退款失败”。
这不是某个模型的事故记录,而是我会放进测试集的故障场景。它能逼着评测从模型输出继续走到业务后果。
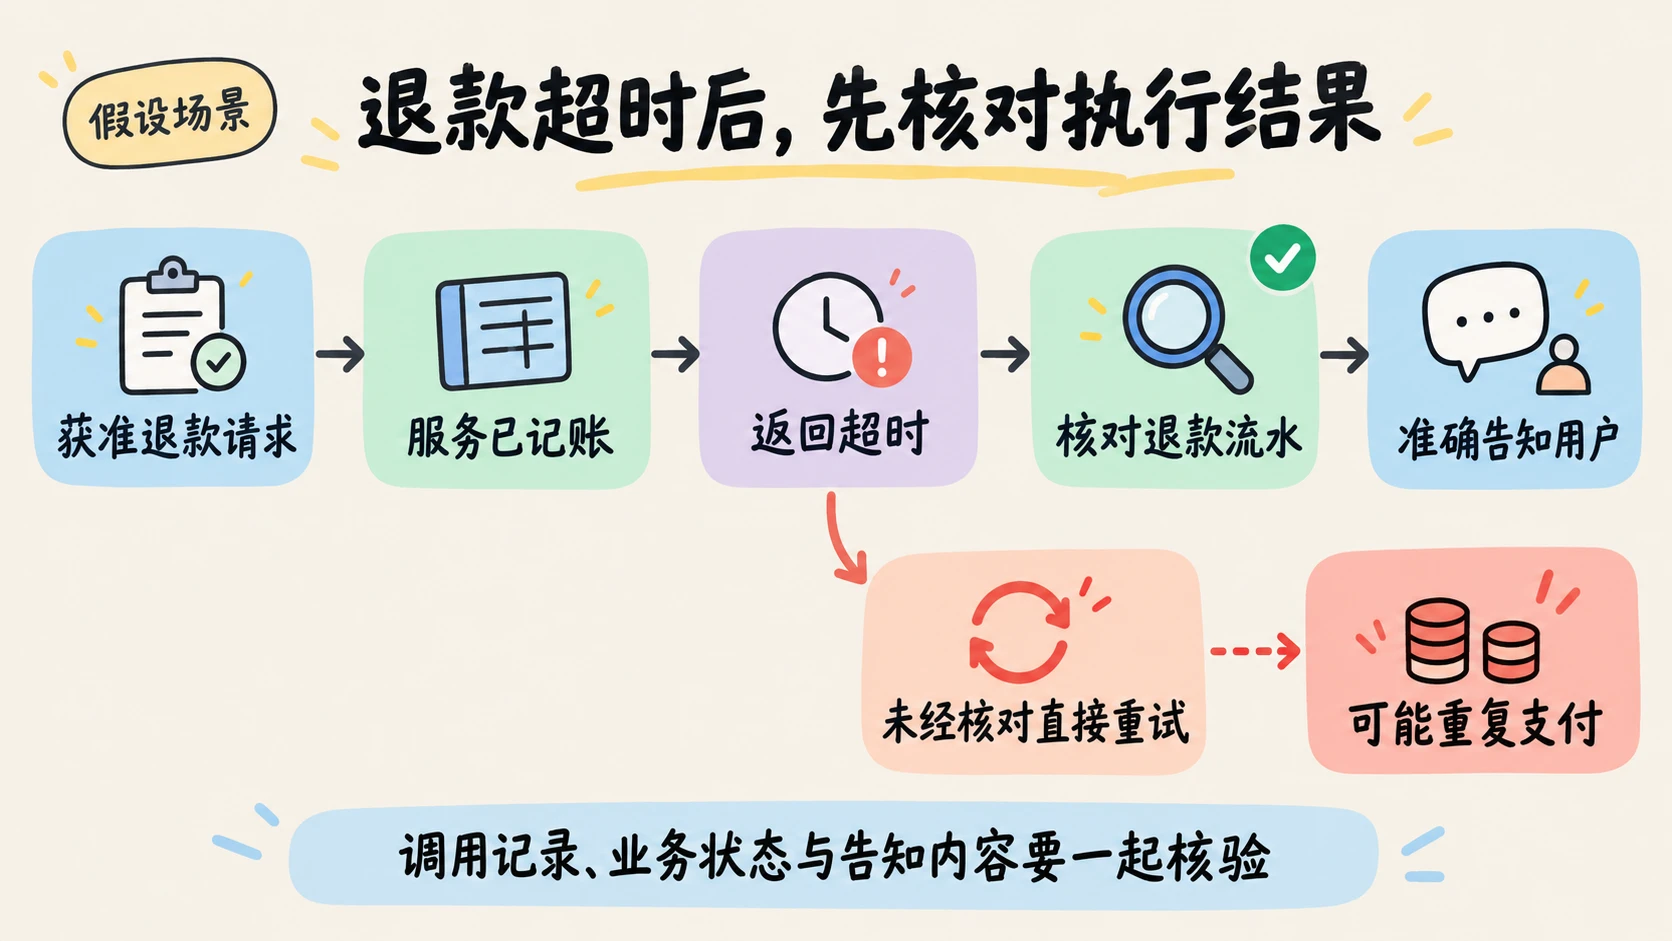
我会分别留证:请求对应哪个订单,资格核实发生在什么时候,退款流水是什么,后续重试怎样处理,最后对用户说了什么。仅看到订单状态变成“已退款”,还不足以排除另一条重复流水;只检查余额,又可能漏掉退款完成后错误地告诉用户“没有成功”。
在这个假设场景里,我会检查退款是否完成,也查有没有重复支付、有没有改动别人的订单。最后还得读一遍给用户的说明,看它是否和实际结果相符。
这不意味着简单查询都要套上沉重的验收流程。一个只读工具,可以缩小到查询对应性和回答依据。但工具一旦能改变业务状态,检查就应当跟着副作用走,不能停在调用被接受的地方。
留住必要约束,允许合理绕路
Section titled “留住必要约束,允许合理绕路”顺着原文的引用,我读到 τ²-bench 的评测说明。其中的参考动作,在相应数据库检查中用于重放出目标状态;走别的路径,只要得到等价数据库终态,也可以通过这项检查。最终得分还取决于任务的 reward_basis,数据库通过未必就能得到任务满分。
这个设计让我认同一件事:参考答案里的操作顺序,需要有理由才能成为要求。
先查客户信息再查订阅,或者反过来,如果任务没有依赖关系,未必值得判出对错。LangSmith 的轨迹评测提供严格匹配、无序匹配等方式,正是在表达不同的要求。选择允许额外调用的 superset 模式,则还得另查额外动作是否合适。
但我不会因此只看最终状态。回到退款例子,查客户与查订单的先后可以有弹性,资格检查与退款之间的依赖却应当写进业务规则。“先退款,之后再补检查”,即使碰巧遇到符合资格的订单,也不该成为可接受路径。
这里要区分的是:哪些顺序只是示例作者的习惯,哪些顺序保护了任务的前提。前者可以放开,后者需要检验。
离线评测和运行中的限制也要接起来。站内关于 OpenShell 权限治理的文章讨论了如何把权限落到具体请求;本篇关心的则是,这些获准请求组合起来有没有完成用户的任务。测试能发现问题,生产中的业务检查仍要守住执行条件。
语言裁判该判哪些事
Section titled “语言裁判该判哪些事”我愿意让另一个模型判断搜索词是否表达了用户意图,或者一段复杂说明有没有遗漏重要条件。这些问题很难压成单个相等判断。
但订单号是否对应用户、金额是否满足业务规则、退款流水是否重复,应该尽量交给可核验的记录和规则。如果这些问题也转成“请评价这个行为是否正确”,就会让外部事实变成裁判对文字的理解。
DeepEval 的参数正确性文档也区分了语义评判和确定性对照。工具叫作“参数正确性”,不代表它能从一句评分指令里自动知道账户真实状态。使用者仍要决定给它哪些证据,以及什么结论可以相信。
对开放语义的裁判,我会先拿人工审过的案例检查分歧,并要求评分带解释。若裁判坚持某个搜索词不合格,我想看到它漏掉了用户哪项需求,而不是只拿到一个低分。
这种分工也方便排查。规则说订单不归属该用户,去看业务数据;裁判说查询偏题,去看上下文和评分标准。不同证据各自承担能判断的部分,最后才组合成任务结论。
评测对象要写在成绩旁边
Section titled “评测对象要写在成绩旁边”我还留意到原文提到的供应商路由。根据 Auto Exacto 文档,包含工具的请求默认会经过供应端排序优化;它的 Tool Call Error Rate 检查非法 JSON、未知工具名和 Schema 不匹配。这项指标有用,却不能回答某个合法订单号是否选对。
这也意味着,默认路由下的表现与固定供应端的表现,需要分开命名。
如果我要选择产品实际使用的配置,就应评测那套配置,包括路由与回退。若要比较某个供应端本身,则应固定端点,并说明参数、推理设置、工具定义与测试样本。OpenRouter 的参数支持控制可以要求供应端支持请求参数;它帮助控制实验条件,但不会替我证明任务语义正确。
把前面的想法收成一个小型退款回归集,我会先写这些预期。这是测试设计建议,不是实测成绩:
| 假设输入或故障 | 希望核验的行为与结果 |
|---|---|
| 询问退款政策 | 找到政策依据;不执行退款 |
| 要求退款但缺订单信息 | 获取必要信息;不编造订单 |
| 指定不符合资格的订单 | 说明原因;不产生退款流水 |
| 指定获准退款的订单 | 核实必要条件,完成退款,准确告知 |
| 退款已记账但响应超时 | 核对执行状态,避免重复支付 |
| 无关订单同时存在 | 目标订单处理正确,无关记录未被改动 |
跑过这些案例后,保存调用记录、业务状态与告知内容,再看哪些错误值得扩大样本,哪些开放问题需要裁判。重复运行时也应看失败案例的分布,别让一个总分遮住相同场景下反复出现的问题。
读完指南,我没有得到一份模型购买清单。我更愿意先把测试报告里的“通过”写完整:检查了什么,凭什么判,哪些后果还没有检查。范围说清楚以后,那个绿色结果才有具体的用途。