Agent 扩容会把 Git 写入路径推到台前
Agent 并发把 push、ref 协调、CI 读扇出和仓库维护挤进同一条路径;GitHub 的拆分方向值得期待,关键仍是守住状态发布与恢复边界。
我读 GitHub 这篇基础设施说明时,在那张按仓库分位数排列的图上停了会儿。2026 年 8 月,Requests (all) 从 P50 的 25 增到 P99.99 的 570,771,再到 P100 的 1,001,000,000;纵轴每一格扩大 10 倍。P100 比 P99.99 高约 1,754 倍。
最大仓库当然不能代表普通项目。它更像一盏警示灯:当一组 Agent、CI 和代码扫描都围着同一个仓库工作,平均值不再足以描述基础设施要接住的压力。GitHub 这次要处理的,也不只是“更多 clone”。

Git 的负载,远没有平均地落在每个仓库上
Section titled “Git 的负载,远没有平均地落在每个仓库上”P100 这个点很极端。它和前面分位点之间的落差,才是扩容讨论必须面对的地方。多数仓库仍然很轻,极少数仓库的 push、fetch 和 clone 却可能同时涌入。GitHub 的扩容方案得接住这条长尾,也得避免最忙的仓库拖慢整个平台。
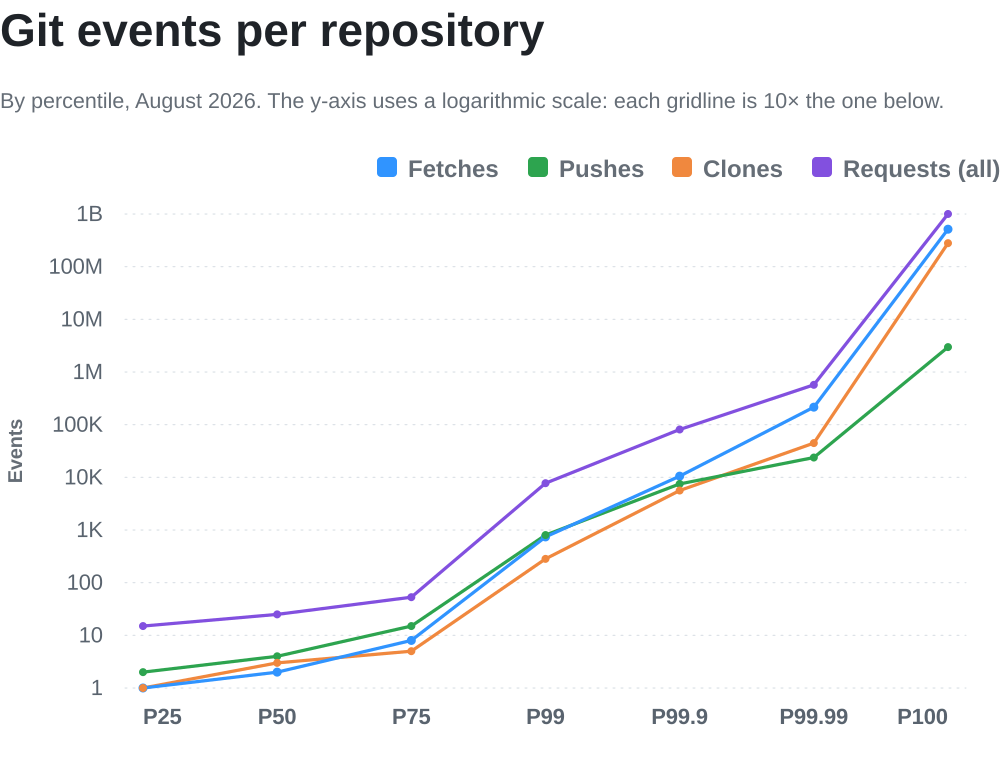
并发 Agent 会让这种长尾更难处理。一个 Agent 在工作循环中频繁提交或 checkpoint;许多 Agent 各自在分支上工作后,合并又会汇聚到需要接住每次更新的共享 ref。每次 push 还会带来 CI、扫描任务和其他消费者的读取。写入增长、读取扇出与后台维护开始互相挤占。
我之前从使用成本角度写过《Agent 规模化后,最贵的不是模型》。那篇讨论模型周围的请求、工具和上下文;这篇把同一个“规模化”问题推到版本控制这一层:每次改动如何耐久地写入,又怎样及时让其他工作流看到。
完整副本同时做两件事,读扩容就会碰到写入
Section titled “完整副本同时做两件事,读扩容就会碰到写入”GitHub 对现状的描述很直接:仓库的完整副本放在多台文件服务器上,默认五份;ref 更新通过三阶段提交和 quorum 保持一致。副本既提供持久性,也分担读取。读流量上来时加副本,读请求有了更多落点,但每次 push 也要经过更多副本。以读扩容换写入开销,对普通仓库可能合适;对写入密集的仓库,扩容本身会更靠近瓶颈。
所以“多加缓存”只能解决一部分问题。Agent 不只是在拉取同一份代码,也在同时推进项目状态。最忙的 ref 更新仍由完整副本共同承担时,读和写还是会争抢同一套资源。

把持久层和请求服务拆开
Section titled “把持久层和请求服务拆开”GitHub 提出的方向,是让 Azure Blob Storage 保存权威仓库数据,再由可扩缩、带缓存的 compute workers 响应 Git 请求。故障时,替换 worker 可以从持久层逐步填充缓存;compaction 和垃圾回收也交给后台 worker,尽量离开在线请求路径。
Git 的热请求仍然需要低延迟。GitHub 早期的 DGit 说明强调 Git 对访问延迟敏感,所以当时把仓库放在本地 SSD 上;Spokes 的后续文章记录了副本间的同步与 quorum。今天的方案仍由 compute workers 缓存并服务请求,权威数据才移到独立的耐久层。每个 serving worker 不必再同时充当耐久副本。
写路径也要重新划定协调范围。作者认为,ref 更新需要达成一致;底层对象写入、连通性验证和 secret scanning 可以与其他写入并行。这有机会缩短 push 等待协调的路径。文章没有说明客户端何时收到确认,也没交代确认时哪些对象已经达到什么耐久条件。这里的细节决定了提速后能否保留用户依赖的一致性。
吞吐变快之后,仍要看可靠性和治理
Section titled “吞吐变快之后,仍要看可靠性和治理”GitHub 称内部 benchmark 的写吞吐最高提升 35 倍,读取能力可以独立扩展。这个数字让我想继续看测试负载、对照基线、尾延迟、故障恢复和部署覆盖。文章没有展开这些信息,所以我把 35 倍当作架构方向的初步信号,不能当成所有仓库都已获得的性能承诺。
接下来我会看几个实际边界:push 返回成功后,其他 worker 和 CI 能否看到同一份 ref 与完整对象?缓存失效或 worker 故障时,回补会不会压住高负载仓库?后台压缩和清理怎样避开在线请求?分支保护、必需审查和审计日志是否仍按原来的规则工作?

这也和我之前讨论的合并前 LLM 评测门禁接得上:更快地写入和运行任务很有价值,但提速不能把未经审查的代码更快地送进主干。GitHub 在原文中把工作流、可靠性和人对代码的控制列为设计原则;后续架构能否兑现它们,比单个 benchmark 峰值更值得检查。
我期待后续文章把这些行为边界说清楚,尤其是写入何时确认、worker 故障后怎样恢复,以及权限和审查规则如何接入新的存储路径。到了那时,读者才有足够信息判断这套设计能否在高并发下同时守住数据和治理。