模型返回了向量,检索评测才刚开始
OpenRouter 对 19 个 embedding 模型做了 28 项 API 检查,并说明这些请求没有测量检索质量。模型清单可以缩小候选范围,最终决定仍要用带标注的真实查询。
Embedding API 返回了向量,集成测试就可以通过。检索系统还有一道问题没测:用户提问时,答案所在的段落能不能排进结果?
我读完 OpenRouter 这份《Best Embedding Models in 2026》,印象最深的是作者把测试范围交代得很具体。模型表可以缩小选择范围,接口检查能排除接入问题;应用里的检索效果还得另测。

OpenRouter 这轮测试覆盖了什么
Section titled “OpenRouter 这轮测试覆盖了什么”OpenRouter 对 19 个模型做了 28 项检查,覆盖批量输入、可配置维度、图像和图文输入,以及错误处理。这些请求给出的证据落在 API 兼容性上,检索质量尚未评估。响应时间也没有纳入比较:每个模型只收到一次小请求,服务条件并不相同。
API 返回合法向量,只说明模型接入路径基本可用;目标文档能否排到前面,还需要另一项实验。模型卡上的多语种得分、提供方公布的 benchmark 和价格表,都不足以单独证明它适合某个团队的查询分布。
我会用这份文章做候选初筛。它按输入类型和部署约束指出哪些模型值得先测;最终判断则留给应用查询上的检索结果。
先用任务约束缩短名单
Section titled “先用任务约束缩短名单”选候选时,先看要检索什么。代码库、纯文本知识库和图像资料对模型的要求不同;用户会不会跨语言提问、文档有没有超过端点长度限制、是否需要公开权重自托管,也都会改变名单。价格和 provider 的数据政策同样要考虑。OpenRouter 文档说明,训练与留存条件因 provider 而异,账号对免费和付费模型有分开的训练路由设置。
原文的流程图把这些问题排成了从输入类型到主要约束的筛选过程。它适合决定哪些候选进入测试。流程图复用自 OpenRouter 原文;其中价格、目录和端点信息都需要在部署前重新核对。

OpenRouter 将 Qwen3 Embedding 8B 列为公开权重的多语种候选,将 Voyage Code 4 列为代码检索候选。Qwen 的模型卡称支持 100 多种语言;这是模型提供方的能力说明,仍应在目标语言的查询集上验证。免费路线也需要同时检查数据策略和路由可用性。
让候选在同一套检索题上竞争
Section titled “让候选在同一套检索题上竞争”候选缩小以后,再比较检索质量。OpenRouter 建议固定同一批语料、查询、相关性标签、分块方式和检索指标。每次只改变待比较的模型配置,结果差异才有解释空间。文章建议至少比较两个候选,并在重建大索引之前先跑小规模、有标签的评测。

指标要贴近产品动作。英文 RAG 可以检查应用实际送给生成模型的 top-k 片段是否包含答案;当多个片段相关程度不同时,再看 nDCG。多语种检索要分语言报告结果,避免整体平均掩盖单一语言的失败。代码检索可以把开发者问题或 issue 描述映射到应该命中的文件和代码块。CoIR 这类代码检索 benchmark 可作外部参照,最终验收仍要用自己仓库里的问题和文件标签。
测试结果会把“模型够不够好”拆成更具体的问题:它有没有召回需要的证据?错误集中在某种语言、某类代码问题,还是某种文档长度?团队需要能解释失败样本的结果。
模型配置会留在索引里
Section titled “模型配置会留在索引里”检索评测还要把向量配置一起带上。不同模型家族的向量通常不在同一个坐标空间;文档用一个模型建立索引、查询却改用另一个模型,向量之间的距离就失去原本的含义。输出维度会影响索引存储;OpenAI和 Voyage都把维度作为可配置项。Voyage 还允许用 input_type 区分 query 与 document,输入格式会影响检索时的编码方式。
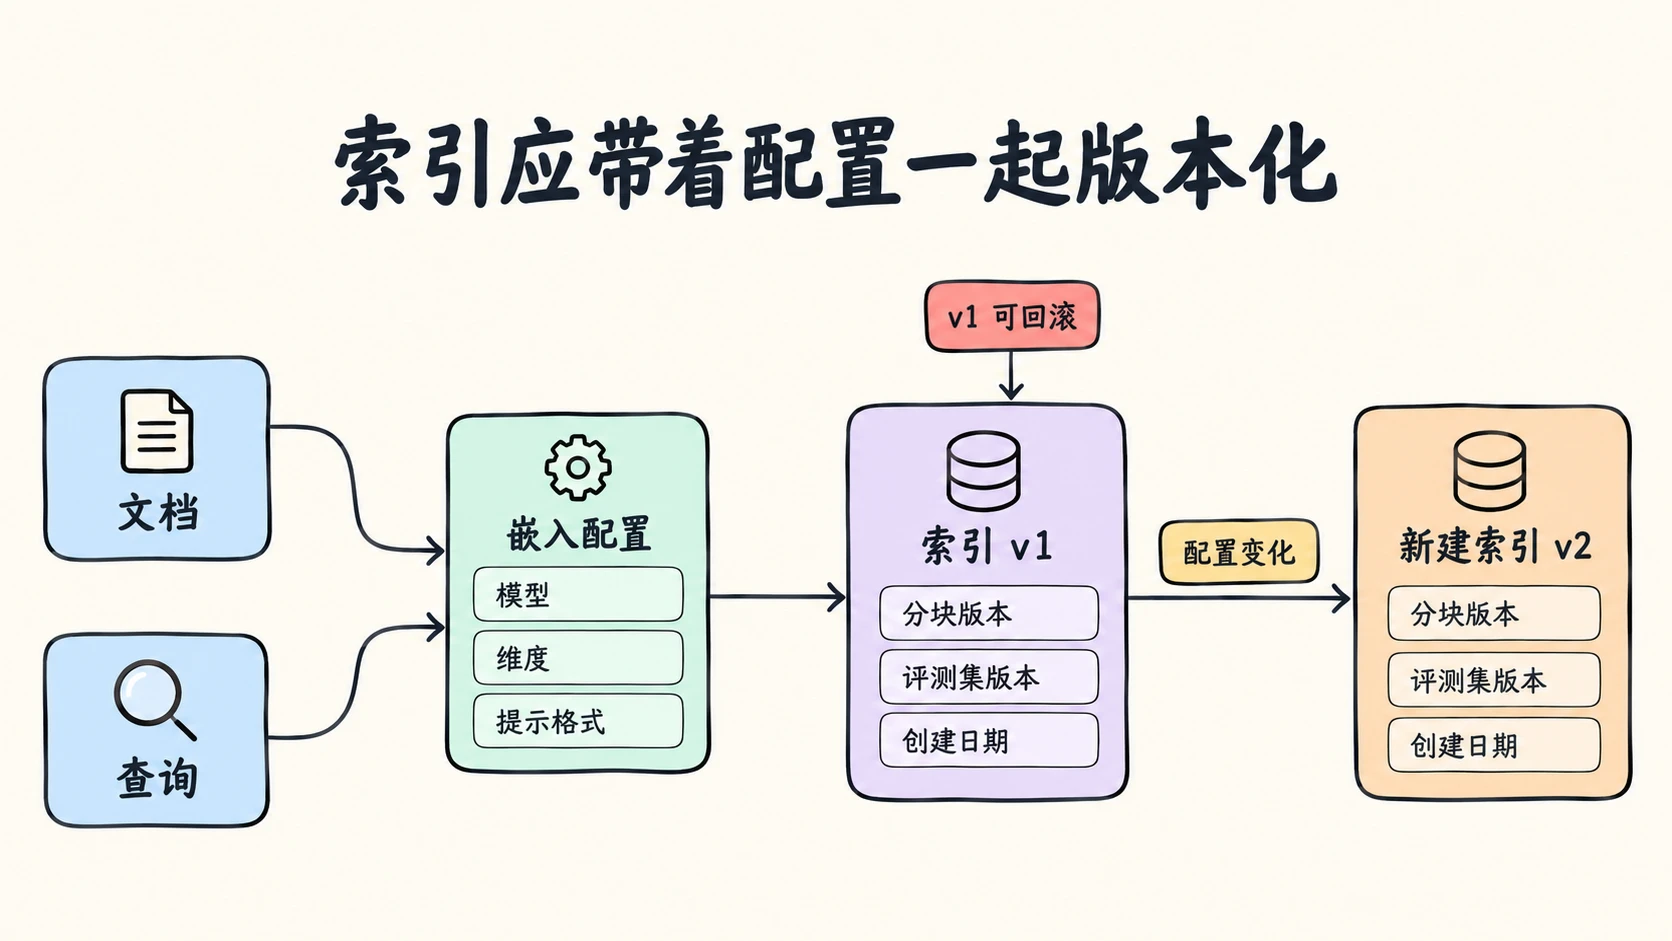
Voyage 官方文档给了一个值得注意的例外:Voyage 4 系列不同 tier 的向量彼此兼容。但“兼容”只说明能够继续比较,不代表换 tier 后相关片段的排序完全不变。若服务质量是验收目标,仍应在样本集上确认结果。
OpenRouter 建议把模型 slug、维度、提示格式和创建日期记录到索引元数据里。我还会记录 chunking 版本和评测集版本,方便之后判断召回变化来自模型、分块还是问题集。模型选择也会影响索引如何版本化、并行构建和回滚。
Embedding 只是检索方案的一种选择
Section titled “Embedding 只是检索方案的一种选择”如果要比较的不只是 dense embedding,候选集合也要跟着扩展。BGE-M3 的模型卡说明它支持 dense、sparse 和 multi-vector 检索,并建议先做 hybrid retrieval,再 rerank。这个方案是否适合当前语料仍要验证;embedding 模型的离线比较只覆盖检索链路的一部分。
做模型对比时,应先固定检索架构。比较 BM25、hybrid 或 reranker 的收益时,再把它们放进单独一轮实验。这样分数变化更容易归因。关于多向量表示如何保留细粒度匹配、又会怎样增加索引成本,我在《向量不必急着被压成一个》里作过展开,可以作为架构层的延伸阅读。
实际起步时,我会先整理一组带相关性标签的真实查询,让至少两个候选模型跑过同一套检索条件。达到质量门槛后,再核算索引体积、调用成本和迁移方案。向量返回成功只是接入结果,是否进入生产索引,要看检索测试。