给评测报告加一条“失败则禁止合并”的规则,改动很小,后果却很具体:以后有人改提示词,能不能交付,要听这份报告的。
读 OpenRouter 的这篇 CI 评测教程,我认同它的方向。把固定用例、判分脚本和必需检查接起来,提示词的行为变化就有机会在合并前被发现。可我读完更在意的是另一件事:我们准备把多大的否决权,交给怎样的一次测量?
我愿意用评测挡住坏改动,也希望报告说得清:这次红灯,究竟凭什么挡人。

先确认绿灯背后跑过什么
Section titled “先确认绿灯背后跑过什么”原文安排了两个 job:changes 判断改动是否涉及 Agent,eval-gate 根据结果决定是否运行评测。它特意把路径过滤放在 job 层。GitHub 对因条件而跳过的 job 报告成功;如果整个 workflow 因路径过滤没启动,相关必需检查则可能一直 Pending,挡住无关改动。
这处细节很实用,也让“通过”多了一种含义:没有执行,但允许合并。

原文流程图来自 OpenRouter。注意图的下半部:“Job skipped”的箭头画向了“Merge blocked”,与框内说明及正文相矛盾。应按文字规则理解:合法跳过可以满足该项必需检查;不能照着这根箭头实现。
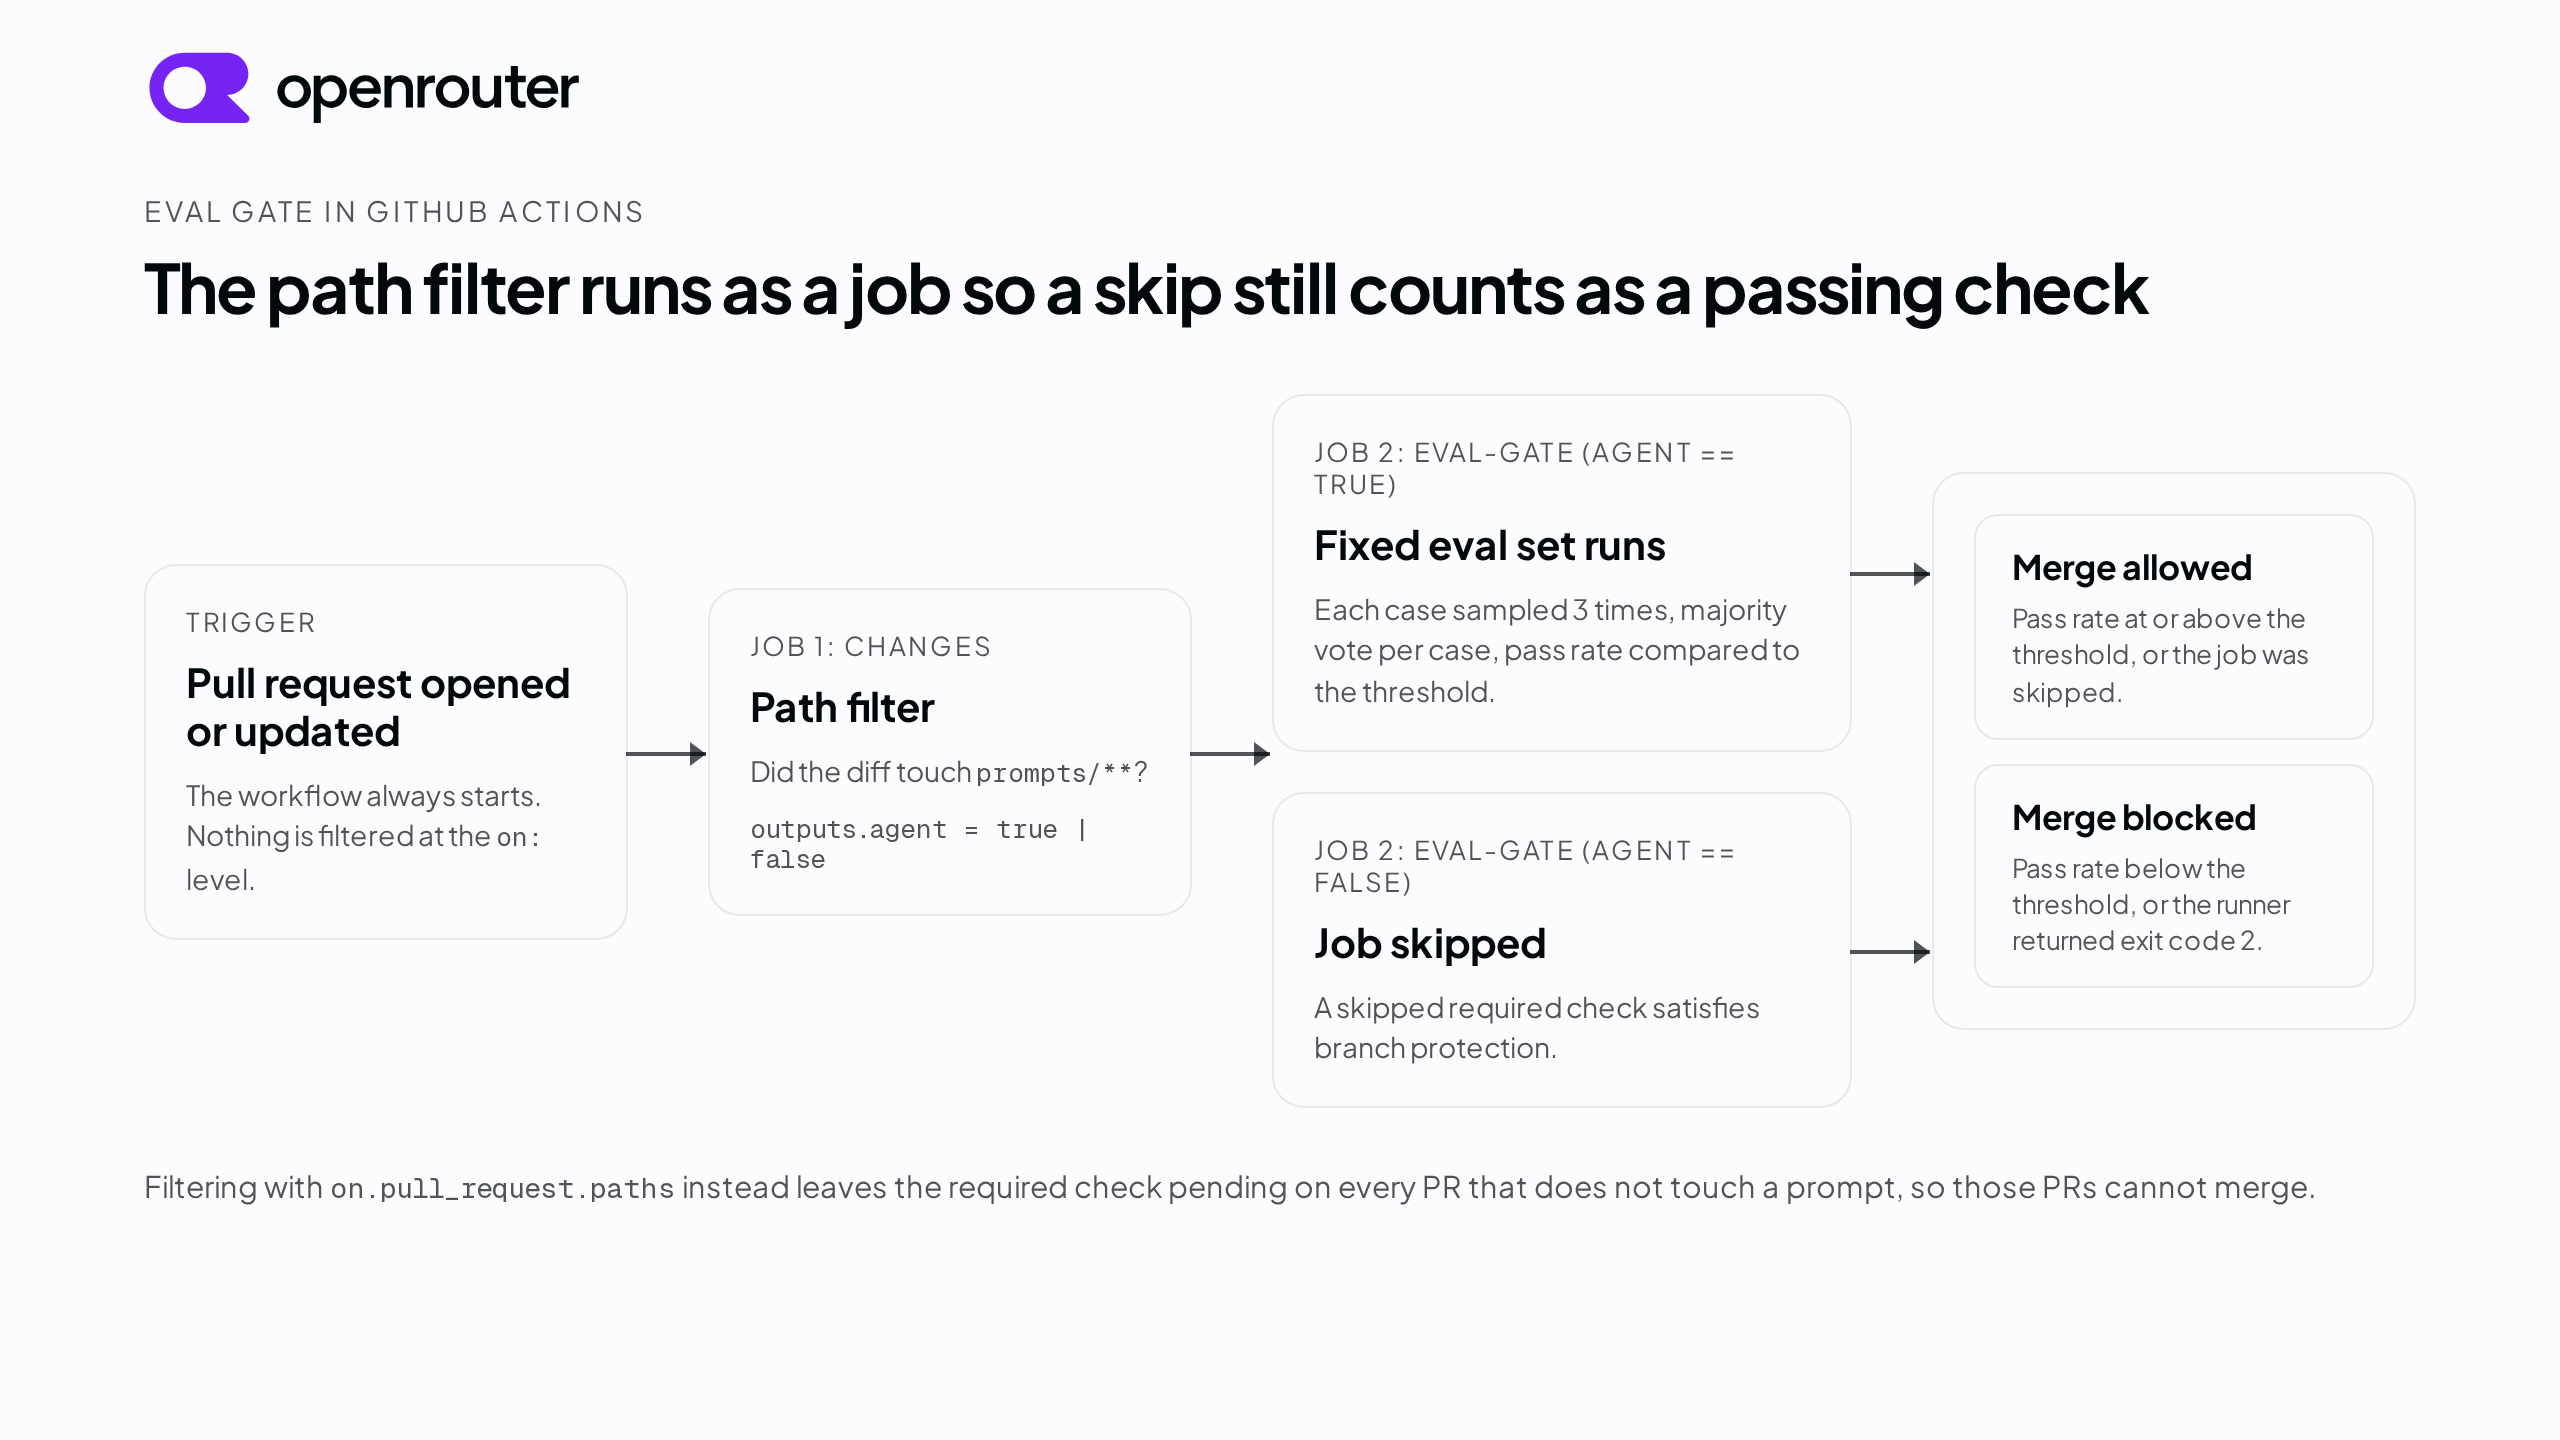
于是,我看一张绿色的 PR 页面时,会想知道它属于哪种情况:用例跑过且通过,还是过滤器判断无需运行。过滤规则若漏了工具 schema、评分脚本,甚至 workflow 自身,绿灯可能只是在确认一个错误的“无关”判断。
原文给出的补救是把 changes 和 eval-gate 都设为必需检查。否则,前者报错导致后者被跳过,也可能只留下一个满足合并条件的跳过状态。不过,这仍抓不到写错路径的过滤器。我会在接入时故意改一处提示词,再改一处评分脚本,亲眼确认评测被触发;再提交无关文档,确认跳过有明确理由。
这类检查不需要模型替我们判断。先把“该测的确实测了”做实,分数才值得看。
噪声下限不等于业务底线
Section titled “噪声下限不等于业务底线”教程用三道客服用例演示,阈值写成 0.9。这看起来像允许少量失败,但三道题的通过率只有零、约三分之一、约三分之二和全过。因此在这个例子里,0.9 就要求全过。
原文建议在不变的主分支上重复运行六次,用观察到的最低通过率来帮助设阈值。我赞成先测波动,反对随手填一个显得严格的数字。但有限次运行的最低值,只是这批观察的最低值;它不能保证下一次不会更低,更不能替业务决定可以错到什么程度。
假如一条退款规则确实不能违反,却在基线上偶尔失败,把阈值降到容纳它,只是让现状更容易过门。风险没有消失。
我的选择会是分开处理:普通回答质量可以看聚合表现和波动,越权退款、错误承诺这类不接受的行为,则单列断言与处置规则。先决定业务能容忍什么,再判断当前评测能否可靠地识别它。两者冲突时,可能需要修产品、修断言,或者暂缓把这项测量变成自动门禁。
原文还对每道题采样三次,取多数判定。它能帮助处理部分偶发波动,但也可能把一次重要失败藏在最终的 PASS 里。若担心的是生产中一次错误操作的代价,就应保留逐次结果,看到失败发生在什么动作上。多数通过回答的是一套聚合规则下是否通过,不能直接解释为单次使用足够可靠。

本站此前讨论黄金评测集时,区分过常见请求与高代价失败。接入 CI 后,这个区分还得落实成合并规则,不能只留在分析报告里。
主分支也红,仍然需要查原因
Section titled “主分支也红,仍然需要查原因”原文有一句判断,我不会直接采用:候选分支失败时再跑主分支,如果主分支也失败,就把失败视为噪声。
这个对照有价值,但结论走得太远。两边共同失败,还可能因为提供方故障、共享测试条件变了、断言写错了,或者主分支本来就有产品缺陷。候选改动是否引入额外问题,也要继续对照具体失败,不能只比最终总分。
之前那篇 Agent 回归测试文章提供过一个很具体的例子:测试收到查订单的工具调用就停下,还没走到业务决定。追到执行轨迹,才知道两边为什么一起失败。这给我的提醒是,共同失败是排查入口,原因要靠后续证据确认。
OpenRouter 这篇教程在错误分类上倒做得很好:质量未过阈值用退出码 1,评测没能完成用退出码 2。它们都可以让 CI 停下来,但处理动作应该不同。提供方超时,应恢复运行条件;Agent 违反业务规则,应查候选行为;评分误伤,应带着合理答案修断言。不能把红灯统称为“模型退步”。
它还固定提供方并禁止回退,提醒读者核对 temperature、seed 的支持情况。这些设置有助于减少比较条件的变化,却没有消除看原始回答和工具记录的必要。
对会行动的 Agent,我还想知道它实际做了什么。原文扩展到 Ori Eval 后,加入了工具调用与禁止调用的断言;这是更接近业务后果的观察。若再请模型当裁判,还得拿人工判断校准它,看看它能否识别我们关心的坏结果。
规则变松,也是一项产品改动
Section titled “规则变松,也是一项产品改动”还有一种很安静的过门方法:提示词改坏了,顺手把没通过的用例删掉,或者把阈值降下来。
测试和代码放在同一个仓库,方便一起审查,也允许一起被修改。原文因此要求给提示词与评测集配置 CODEOWNERS,并开启要求代码所有者审核的分支保护。只写文件并不能阻止合并。
我会要求这类 PR 讲清楚:是业务政策变了,还是旧断言误判了合理答案?如果只是模型暂时做不到,就应该如实写明风险与接受理由。修复错误测试当然合理,但它需要自己的证据,不能只用“这样就绿了”解释。
同样要讲清适用范围的是 fork PR。GitHub 默认不会把仓库密钥传给来自 fork 的工作流,原文建议在推送主分支后补跑评测。这能增加发现问题的机会,却已经发生在合并之后。需要合并前阻断的团队,仍得另行设计受信任的评测流程,不能把事后检查算成门禁已经覆盖。
如果要接入这道门禁,我会先挑真正关心的失败,核对断言能抓住它,再确认触发、跳过和错误分类都可解释,最后才让分数决定合并。对还没校准好的开放式评分,可以先留作评审证据;明确而稳定的业务约束,则更适合先承担阻断职责。
我希望以后点开失败报告,能看到本次改动、用例版本、原始结果和失败原因。它们足够清楚时,我才知道该改提示词、改测试,还是恢复服务。把这份判断交给自动化之前,先让报告能够接受人的追问。