OpenRouter 写了一篇从生产流量制作黄金评测集的教程。读到它给出的最小评测程序时,我停在了这行代码:messages: [{ role: "user", content: example.input }]。
这行代码很适合讲明白跨模型调用:换一个模型,把同一批问题再发一遍。但如果产品的答案还取决于检索结果、工具返回、系统提示词或者上一轮对话,只重发用户问题,测到的到底是哪一个系统?
教程用极简代码讲清了调用方式,也让我看到一个容易漏掉的问题:样本里存的是一次提问,还是一次可以解释的任务?

我赞成从生产流量开始
Section titled “我赞成从生产流量开始”原文的流程很扎实:抽取生产请求,去重并按意图整理,给样本写期望输出或判分规则,先跑现有系统检查规则,最后把数据、规则和基线放进版本管理与 CI。OpenRouter 的原始流程图把这条路画得很清楚。
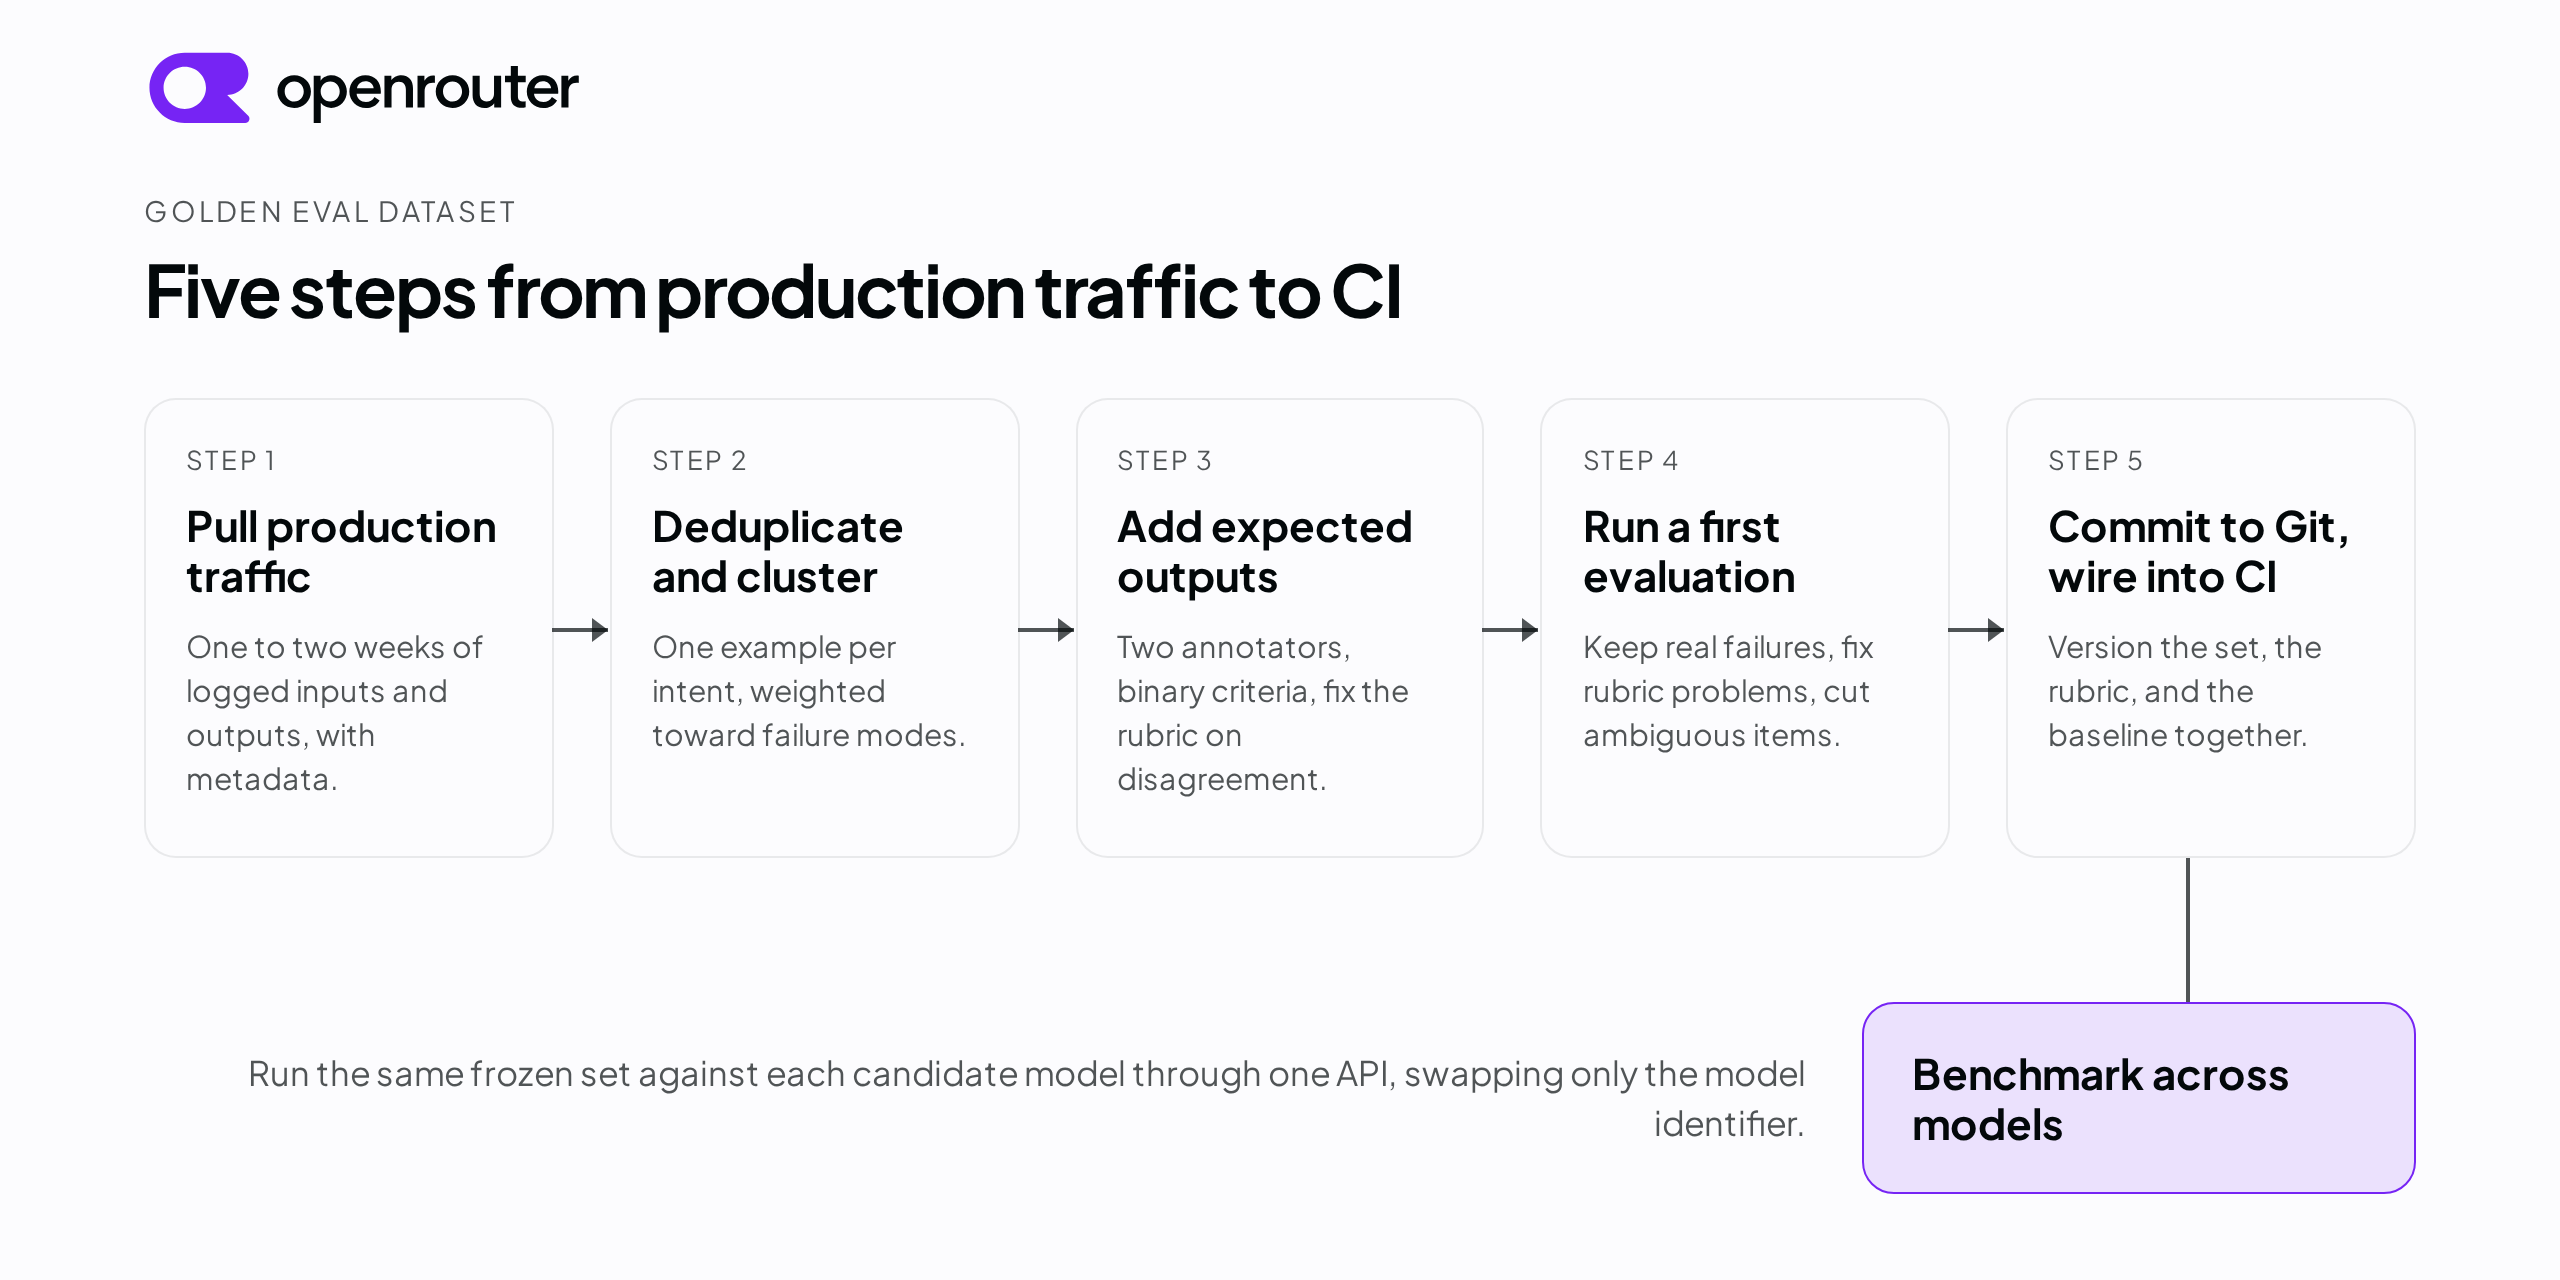

真实请求保留了用户自己的说法:半截报错、混用的语言、已经改名的功能。设计测试的人往往想不到这些。把线上失败收进评测集,是让系统记住自己已经付过代价的错误。
不过,“来自生产”还不等于“可以当标准答案”。原文要求先清理个人信息,再由懂业务的人核对期望行为;首轮评测发现合理回答被误判时,要修规则,实在无法判定的样本应退出集合。Langfuse 的指南也把审核看成黄金集之所以可信的条件。单纯把日志倒进 JSONL,只会得到一堆带时间戳的旧问题。
重放一次任务,需要留下哪些东西
Section titled “重放一次任务,需要留下哪些东西”对一个只接收单轮文字、没有外部依赖的功能,输入、参考答案和判分规则也许已经够用。系统一旦会检索或调用工具,事情就变了。
假设客服助手答错了退款政策。复测时,知识库文档已经更新。如果只保存用户的原话,新模型答对了,可能是模型进步,也可能只是查到了新政策;答错了,也可能是旧标准答案过期。此时我想一起保存的,是当次检索到的材料或可固定的知识版本、提示词与策略版本、工具返回,以及希望它最终完成什么。对需要行动的 Agent,还得写清允许的路径和必须守住的终态。
记录多少,取决于哪些因素真的会改变判定。先问“没有它,我还能解释这次分数吗”,再决定是否保存。本站此前谈 Agent 的生产学习回路 时提到 trace 与失败入库;这篇 OpenRouter 教程给出了下一步:把可复现的失败变成会在改动时重新触发的检查。
平均分之外,我想看另一张账
Section titled “平均分之外,我想看另一张账”原文建议按真实流量分布抽样,又提醒对罕见但代价高的失败增加权重。我认同两边,也因此不想把它们挤进一个“总通过率”。

如果退款查询占了大多数,流量加权的分数能告诉我普通用户最常碰到的体验有没有退步。但一次错误的账户恢复、一次越权操作,可能在样本里很少,平均分却足以把它淹掉。我会保留一组反映真实频率的样本,同时单列高代价失败、产品新功能与已知事故的切片,分别看通过情况。两份结果回答不同的问题:影响了多少常见请求,以及有没有碰坏不能碰的边界。
这里也要防止反方向的错。把所有稀有案例都大幅加权,不能再把所得均分称作“真实用户体验”。切片、权重和门槛应当写在报告上。站内讨论工具调用评测的“通过”意味着什么时,也碰到同一个难题:一个总分经常藏住具体失败的位置。复盘需要看到失败落在哪类任务、哪项规则上。
评审规则也要接受评审
Section titled “评审规则也要接受评审”原文建议把判分条件拆成可逐项检查的标准,并让标注者独立审阅一部分样本。这一步很重要:两个人意见不同时,先查定义是否含糊,而不是急着把某个人当作“错误标签”。
LLM 可以帮忙执行清楚的规则,却不该因为输出了一个整齐的 MET 就自动取得裁判资格。一项关于 LLM 评审可靠性的研究在自己的实验设置中观察到,改变随机种子会让评审间一致性明显波动。这个结果不等于每个 LLM 评审都不可靠;它足以提醒我,发布门槛若依赖模型判分,就得拿人工判过的样本校准,并回看临界案例。
跨模型比较还要固定比较条件。同一批题、同一套规则与版本是一部分;提供方和所支持的参数也会影响调用。OpenRouter 的路由文档说明了如何限制提供方回退,Models API 文档列出模型的上下文长度与支持参数。换模型标识能省掉接入工作,却不会自动抹平这些差异。
读完这篇教程,我更愿意把黄金评测集看成一份持续更新的“判定记录”:它保存真实请求,也保存当时为什么这样判、在哪些条件下这样判。这样下一次报告变红时,团队才有机会分清:是产品退步了,规则写错了,还是测试所依赖的世界已经变了。