Agent 跑得久,靠的是可恢复的工作集

读完 MarkTechPost 的这篇文章,我先想到一个很具体的场景:任务还没结束,模型已经开始重新解释任务。一个任务如果要跑很久,它到底靠什么知道自己还在做同一件事?
Agent 每走一步,都会留下工具调用、文件内容、报错、搜索结果和新的判断。把这些东西一起留在对话里,看起来像是在保存记忆,实际更像把整个工作台搬进了模型的视野。桌子越大,东西越多,真正要找的那张纸未必越容易找到。
我的读后判断是:长时程 Agent 需要一份可维护、可回读、可验收的工作集。上下文窗口只是工作区;外置文件、摘要、todo、子 Agent 和长期记忆,分别负责把工作区维持在可工作的状态。
窗口变大,不等于工作记忆可靠
Section titled “窗口变大,不等于工作记忆可靠”这篇文章先用 Chroma 的 Context Rot 研究垫了一下地基。Chroma 对 18 个 LLM 的实验观察到,输入长度增长时,模型表现会越来越不稳定。原始报告还特意提醒,常见的 Needle in a Haystack 测试主要测的是检索一个明确的词句,并不能代表真实任务中“在干扰信息里理解、判断、继续行动”的能力。
这一区分不能跳过。上下文窗口回答的是“最多能装多少”,却没有回答“装进去之后,哪些信息还能稳定参与决策”。长任务里的上下文不是一堆静态文档,而是不断变化的工作现场:用户目标、工具结果、失败尝试、当前文件和下一步动作互相叠加。模型既要从中找相关内容,又要在找出来之后完成推理。输入变长,等于把这两个任务绑在了一起。
Anthropic 在关于 context engineering 的文章里把上下文描述成一种需要持续维护的注意力预算,我觉得这个说法比“超长上下文”更接近 Agent 的实际处境。你每放进一段材料,不只是增加了一点知识,也增加了模型需要分辨的竞争者。
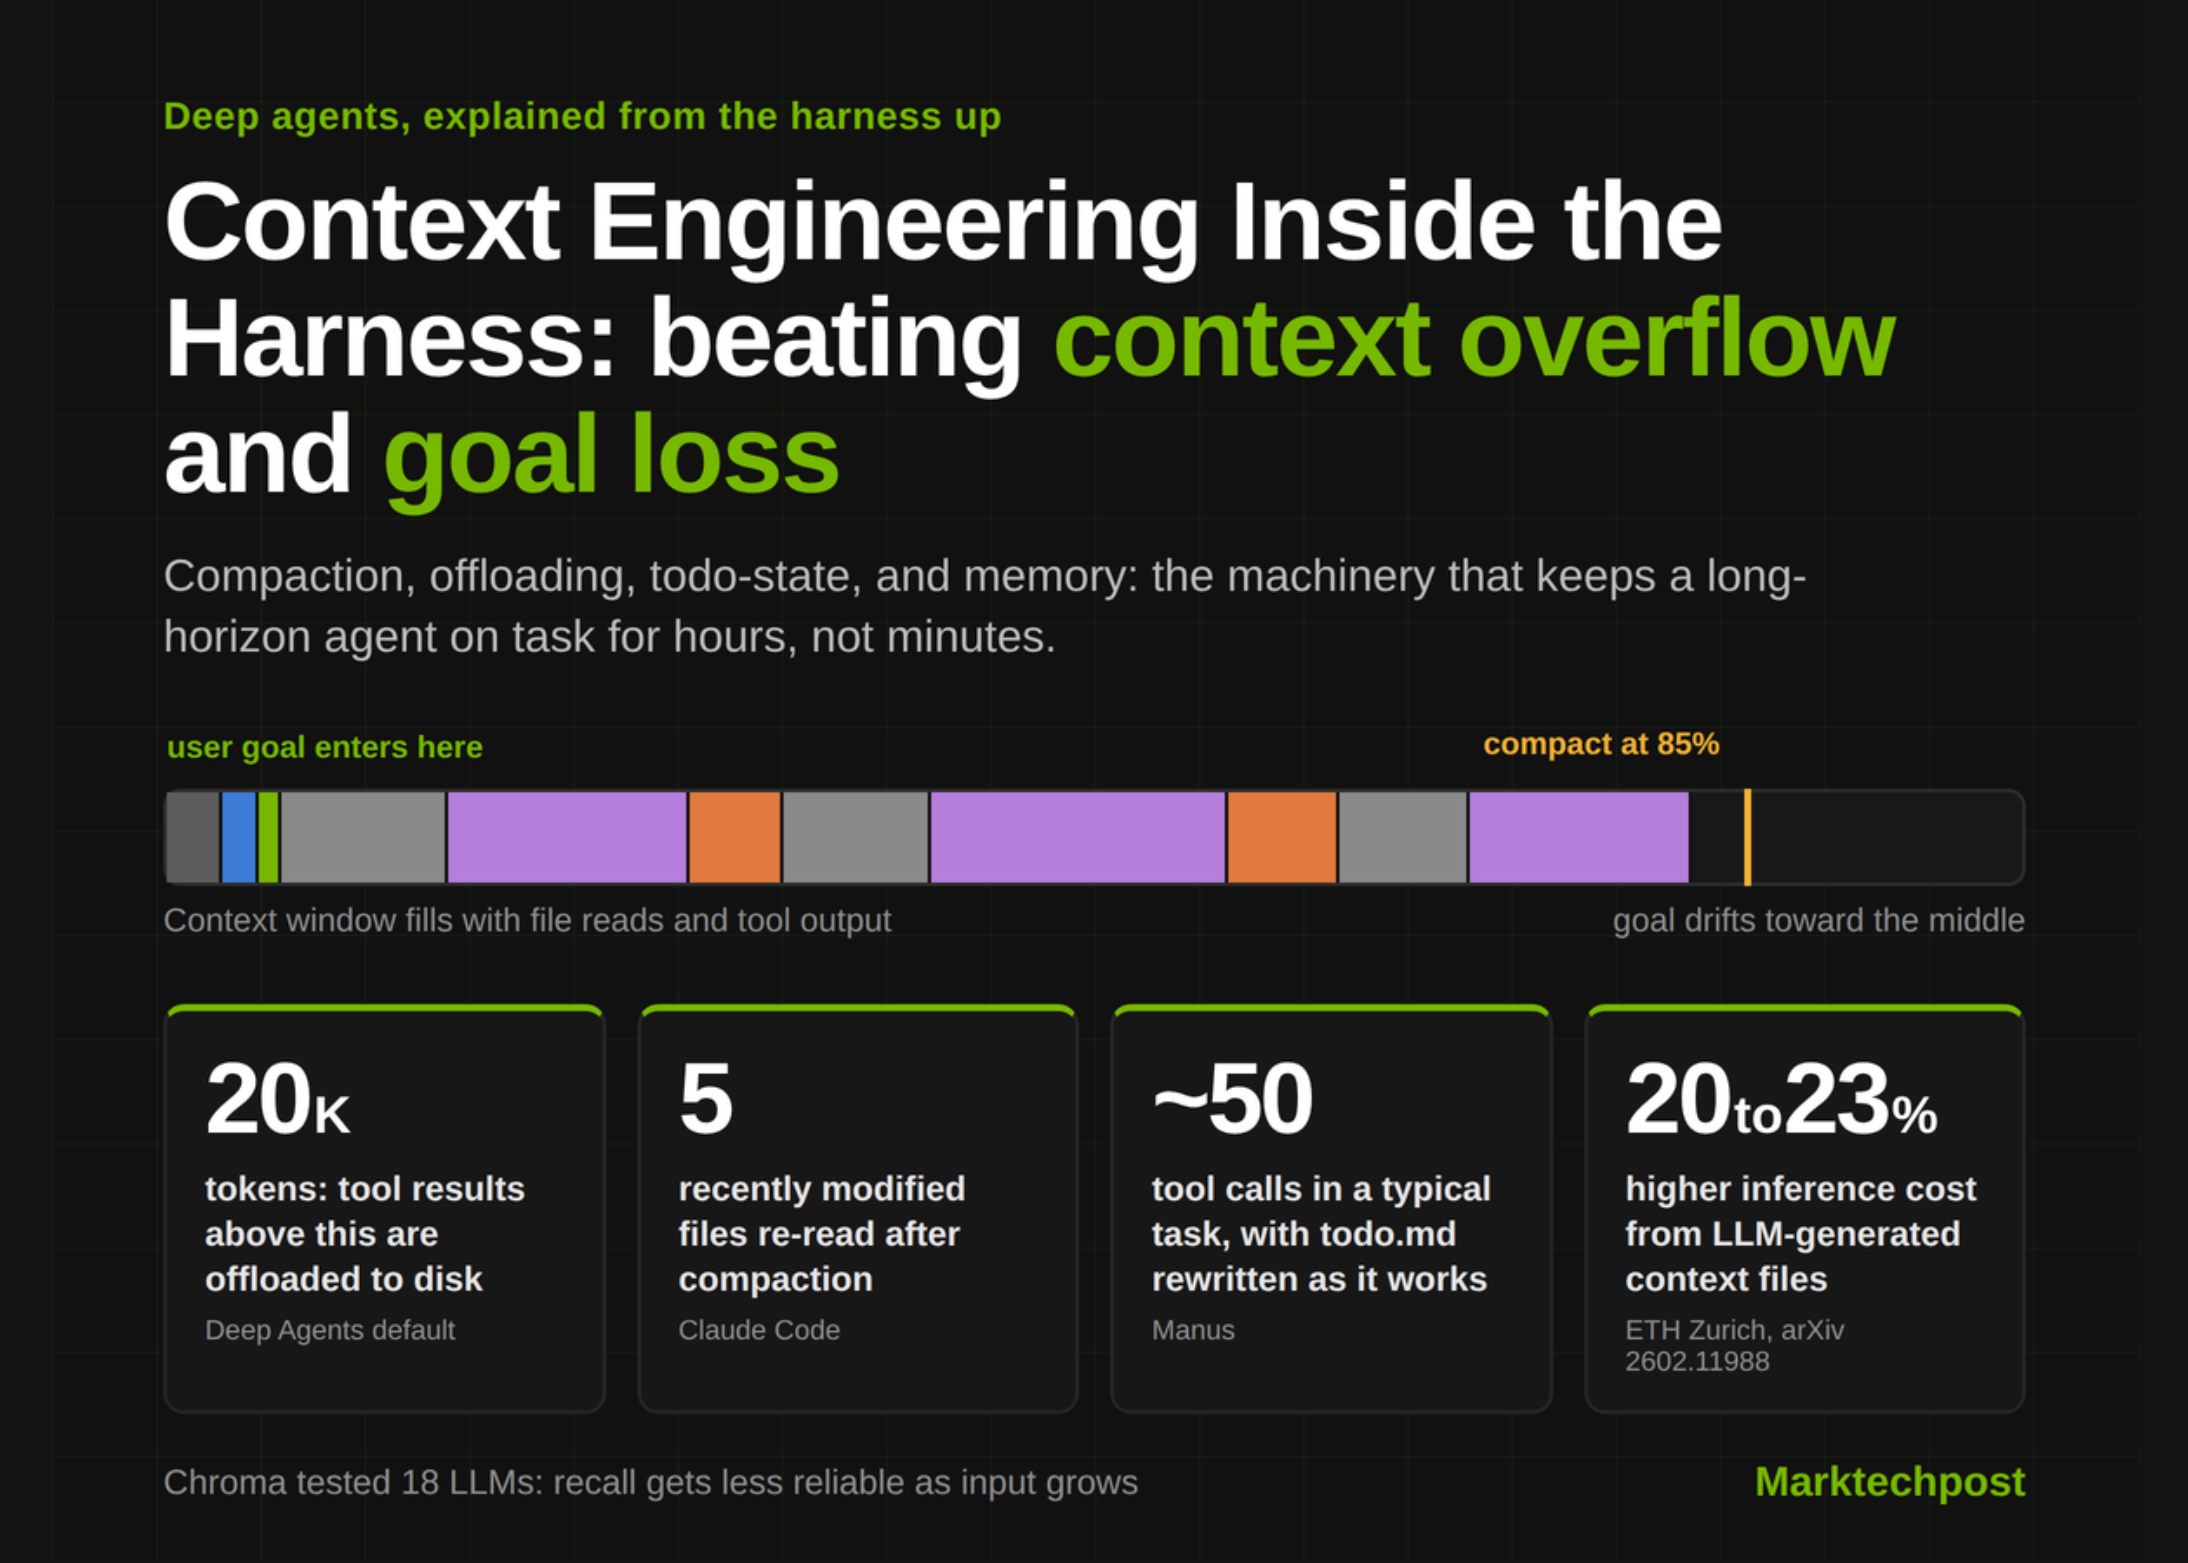
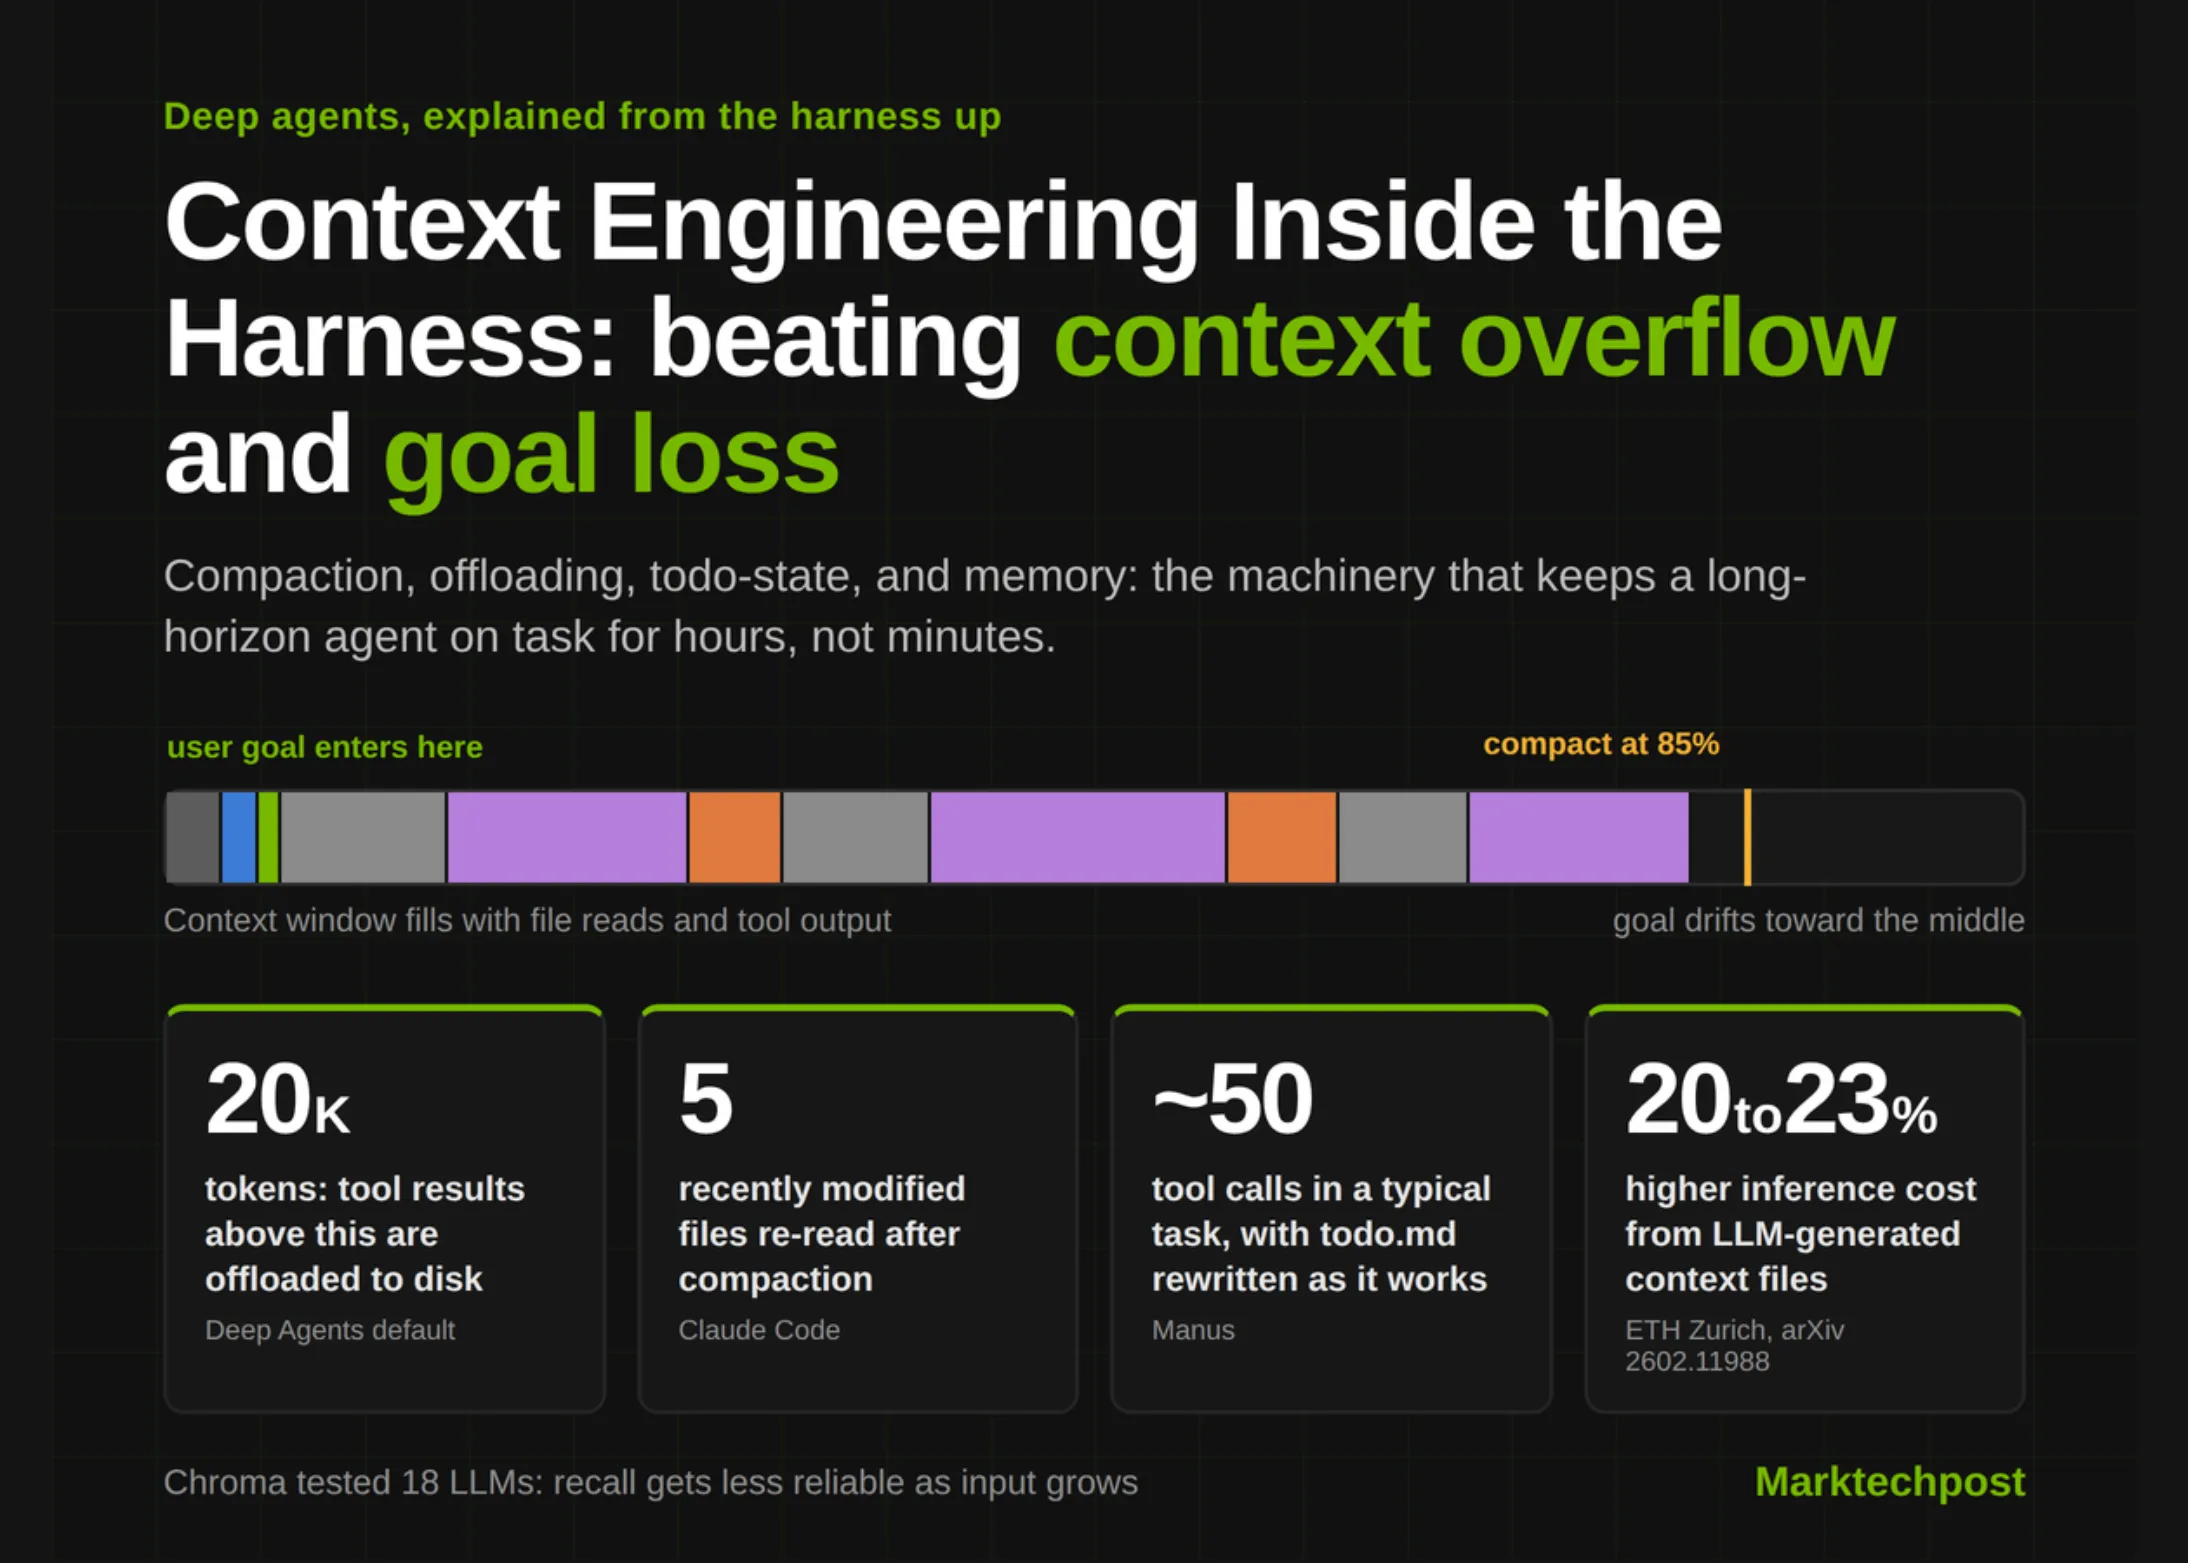
这也让 MarkTechPost 原文那张主视觉图有了更准确的位置。图中把“目标进入窗口—文件读取和工具输出不断填满上下文—接近阈值后压缩—目标向中间漂移”画成了一条时间线。我把它读成一种故障提示,而不是固定阈值的公告:目标没有从系统里消失,却可能离开模型最近、最容易被利用的注意力区域。
四个机制其实是一条状态流水线
Section titled “四个机制其实是一条状态流水线”原文把外置、压缩、todo 状态和 memory 分开介绍,又在互动模拟器里加入了研究子 Agent 委派。我读下来更愿意把它们重新排成一条工作集流水线:信息怎样进入当前窗口,怎样离开,怎样在需要时回来,目标怎样保持新鲜,探索噪声又怎样留在主线程之外。
第一步是准入。用户目标、当前约束和真正要用的工具进入窗口,而不是把所有可能有用的资料预先摊开。第二步是外置。LangChain 的 Deep Agents 文档说明,大的工具输入和结果可以保存到文件系统,再用路径和预览替代原文;它给出的默认外置阈值是 20,000 tokens,旧的写入或编辑内容在接近窗口 85% 时也可以被替换为文件指针。官方文档中的实现细节很具体,但这些数字仍然是产品默认值,不是 Agent 世界的自然常数。
第三步是交接。压缩不是简单删掉旧消息,而是用模型生成包含 session intent、artifacts created 和 next steps 的结构化摘要,同时把原始消息文本写入文件系统。这样,摘要负责让工作继续,原始记录负责让细节可以被找回。LangChain 的工程说明把这两层关系讲得很清楚。
第四步是复诵。Manus 的官方文章提到,一个典型任务平均需要约 50 次工具调用,它会持续改写 todo.md,把目标再次放到上下文末端。原文里有一句很准确:这不是可爱的仪式,而是在主动影响注意力。计划的作用不是让 Agent 看起来更有条理,而是让“我现在究竟在完成哪一个目标”重新变成近期信息。
第五步是隔离。需要大量搜索、浏览或数据处理的工作,可以在新上下文中完成,主 Agent 只接收有边界的报告。当前 Deep Agents 文档明确把 subagent isolation 解释为隔离主上下文的膨胀;AWS AgentCore 的示例则把这种隔离落实到并行的浏览器 MicroVM。它带来的不只是 token 节省,也包括更清晰的责任边界:谁探索,谁综合,谁负责最后验收。
最后才是 memory。记忆不是把所有历史永久保存,而是判断哪些规则跨任务仍然成立、未来又确实会改变决策。它的保质期和加载范围应该被设计出来,而不是默认无限延长。
这样看,所谓“四个机制”并不是四个彼此独立的开关。它们共同构成一份工作状态的生命周期:进入窗口,外置暂存,压缩交接,计划复述,隔离探索,长期记忆,再按需恢复。缺一环,故障就会伪装成“模型突然变笨”:没有外置,工具结果挤走约束;只有压缩没有原始记录,摘要出错后无处追溯;只有 todo 没有实际状态,计划会退化成愿望;只有 subagent 没有返回契约,主线程照样会被日志淹没。
我更在意能不能恢复,而不是压缩了多少
Section titled “我更在意能不能恢复,而不是压缩了多少”读完原文后,我最想补的一句是:压缩值不值得,得看恢复。
如果系统只报告“压缩后节省了多少 token”,它测量的只是存储效率,没有测量任务连续性。我更愿意问:压缩之后,Agent 能不能准确说出原始目标、已经做出的不可逆决策、当前未决问题和下一步验收条件?需要旧证据时,它能不能根据路径找到正确文件,并区分失败尝试和最终结论?
这也是我和“上下文越大越好”直觉拉开距离的地方。OpenAI 的Responses API compaction 文档提供了服务端压缩和独立 compact 接口,重点不是把历史神奇地变成无损记忆,而是让压缩结果成为后续请求可以继续携带的状态。OpenAI 在介绍 Codex 执行环境的文章里也把文件系统放在 context 的位置上:大数据不必一次性塞进输入,系统可以通过文件和查询在需要时取回相关部分。
这让我重新理解原文互动模拟器。它设置了一个 200K 窗口和 60 步任务,示例是把 12 个服务从 REST 迁移到 gRPC,然后让读者打开或关闭外置、压缩、todo 复述和子 Agent 委派。四个机制均打开时,目标距离更容易保持在近期;四个机制均关闭时,上下文会更快逼近危险区域。
这个演示适合建立心智模型,不适合拿来替代线上结论。随机的工具结果、预设的目标距离和固定阈值,不能证明真实模型一定会在某一步溢出,也不能证明所有任务同时打开四个机制后都会成功。它留下的评测问题是:强制压缩后还能不能找回目标?把关键事实移到旧历史后还能不能找回?加入一个相似但错误的干扰项后,Agent 找到的是文字,还是正确证据?

站内此前关于 Pi compaction 的文章已经讨论过摘要结构、缓存代价和会话交接;这一篇的重心不在重新解释 compaction,而在把它放回完整回路。没有外部可恢复状态,压缩只是一次更聪明的遗忘;只有摘要、原始记录和恢复路径同时存在,它才可能成为交接。
Memory 不是知识仓库,而是带成本的配置
Section titled “Memory 不是知识仓库,而是带成本的配置”原文把 memory 和上下文压缩放在一起,是因为二者都有一笔容易被忽略的成本:被写下来的东西未必免费,被加载进来的东西也不会自动变得有用。
ETH Zurich 和 LogicStar 的AGENTS.md 研究在 138 个 CTXbench 实例上考察了上下文文件的效果。论文报告,提供上下文文件并不会普遍提高任务成功率,却会让平均推理成本增加 20% 以上;在两个设置中,LLM 生成的上下文文件带来了平均 20% 和 23% 的成本增加。这个结论不应被扩大成“所有 AGENTS.md 都没有用”:论文也区分了开发者写的、用来说明非标准实践的规则,并建议在部署前用自己的任务评估。
这项研究对 memory 的提醒很硬:指令被认真执行,不等于系统因此更有效。上下文文件可能让 Agent 做更多探索、测试和推理,却没有改变最后的成功率。记忆越完整,越可能把“背景”误当成“当前约束”。

Claude Code 的记忆文档和上下文窗口文档提供了另一种更克制的设计:根规则保持短小,路径相关的规则在相关文件进入工作范围时加载,压缩后重新注入稳定约束、计划和近期工作状态。它不是把记忆系统交给一个“永久知识库”,而是承认不同信息有不同的范围和保质期。
站内关于 subagent 与主控工作内存的旧文讨论过隔离的价值;放到这里,它和 memory 其实是同一道题的两端:subagent 决定哪些过程不要进入主工作集,memory 决定哪些结论值得跨会话进入长期配置。两者都在做裁剪,只是一个向外隔离,一个向后持久化。
所以我会给 memory 设四道门:谁写入,什么内容有资格写入,什么时候失效,如何证明它真的减少了错误。一条范围明确、能避免重复踩坑的非标准约束,可能值得保留;一篇自动生成的仓库导览,即使写得很完整,也可能只是让每次启动多付一笔注意力成本。
上线前要测的是恢复能力
Section titled “上线前要测的是恢复能力”原文建议 forced summarization、needle-in-a-haystack 和 goal-drift 等定向评测。我会把它们改写成一份更贴近工作集的验收清单:
- 在任务中途强制压缩,要求 Agent 复述原始目标、已完成事项、未决问题和下一步验收条件;复述不完整就算失败,不因为最后补救成功而掩盖交接缺陷。
- 把关键事实放在旧历史或外置文件中,压缩后要求 Agent 通过路径或搜索找回;同时加入相似但错误的干扰项,区分“找到文字”和“找到正确证据”。
- 注入一次失败的工具调用或过期尝试,检查系统是否保留足够的错误证据,又没有让失败日志无限占据主窗口。
- 对比 todo/plan 开启与关闭时的目标漂移、无效工具调用和最终验收通过率,不只比较 token 数。
- 对比长期 memory 的不同准入策略:全量生成、人工短规则、按路径加载和带过期时间的规则;同时记录成功率、步骤数、延迟和费用。
- 检查 subagent 的返回是否是有边界的结论,是否包含证据位置、置信度和未解决项;如果主 Agent 仍要读取完整 transcript,说明隔离接口没有设计好。

我愿意把这六项都看成恢复测试。系统不能在一次压缩或一次委派后证明自己找回了正确目标,长时自主就仍然只是更长的单次会话。
结语:给 Agent 一张能回去的地图
Section titled “结语:给 Agent 一张能回去的地图”我从这篇文章带走的不是某个框架的默认阈值,也不是“再等一个更大的上下文窗口”。我更愿意把它记成一个系统设计问题:让 Agent 工作,不等于让它一直看着所有过去;让它长跑,则要给它一张能回去的地图。
这张地图由路径、摘要、计划、错误证据、范围规则和验收条件组成。它们共同构成一个可恢复的工作集:当前窗口保持轻,外部状态保持真,目标保持近,长期记忆保持少,重型探索保持隔离。
如果要把这篇读后感压成一句工程判断,就是:长时程 Agent 的上限,越来越取决于它如何管理“此刻该看见什么”和“需要时如何找回什么”。更大的模型仍然重要,但能否把模型放进一个可恢复的工作环境,同样决定它最后交付的是结果,还是一串看似勤奋的过程。
- 原始文章:Context Engineering Inside the Harness
- 原文主视觉图文件
- Chroma:Context Rot
- Anthropic:Effective context engineering for AI agents
- LangChain:Context engineering in Deep Agents
- LangChain:Context Management for Deep Agents
- OpenAI:Compaction
- OpenAI:Equip the Responses API with a computer environment
- Manus:Context Engineering for AI Agents
- AWS:Context-rich research agents with Deep Agents and Bedrock AgentCore
- AWS 示例项目当前入口
- AWS 示例项目 GitHub
- Claude Code:Memory
- Claude Code:Manage context
- ETH Zurich / LogicStar:AGENTS.md 论文摘要
- ETH Zurich / LogicStar:AGENTS.md 论文 HTML