Agent 真正学会工作了吗?三个 AI 原生案例给我的答案
我读完后最强烈的感受是:企业 AI 的分水岭,已经不在“有没有 Agent”,而在“这段工作有没有被组织接住”。
OpenAI 最近发了一篇文章,写 Basis、Clay 和 Exa 怎样把 Agent 放进真实工作里。标题里的 operating capability,直译是“运营能力”,但我觉得它说得更具体:一段工作从某个人脑子里的经验,变成了组织可以反复调用、检查和修正的回路。
这和“让 AI 帮我做一下”不是一回事。后者关心的是这一次输出像不像;前者关心的是下周再跑一遍,换个人来审,遇到资料缺失或权限不足时,系统会不会停在正确的位置。

我读到的不是自动化,而是工作获得了记忆
Section titled “我读到的不是自动化,而是工作获得了记忆”很多公司做 AI 试验时,第一反应是找一个任务:写邮件、做总结、查资料。任务完成了,演示也不错,于是试验结束。问题在于,下一次任务开始时,Agent 还是一个没有昨天记忆的陌生人,原来那次试验也没有给组织留下什么。
OpenAI 这篇文章有意思的地方,是它把重点从“模型能不能做”挪到了“公司怎样接住模型做过的事”。Basis 把一次入职演示做成 Skill;Clay 给每个客户账号维护一个持续更新的工作空间;Exa 让 Agent 从发现机会一直走到 pull request、测试和周报。它们分属人事、销售和开发者关系,底层却是同一个问题:工作能不能在下一轮继续存在。
所以我更愿意把 AI 原生公司理解成一种工作记忆系统。它不要求每个人都记住所有背景,而是让上下文、判断依据、操作步骤和例外处理,留在工作流里。Agent 只是进入这套记忆、使用工具并推动下一步的执行者。
三个案例其实是一条能力链
Section titled “三个案例其实是一条能力链”Basis 的例子最像“教会”。新员工第一天拿到 Codex 和公司专用的 onboarding skill,系统可以介绍公司概念、在后台完成集成设置。原文称,Basis 把新员工入职从两小时缩短到 30 分钟。更值得我注意的不是这个数字,而是它把“某位 HR 如何演示”写成了有触发条件、步骤、工具、权限和完成定义的流程。下一个批次遇到相同问题,HR 修改的是 Skill,而不是重新从头讲一遍。
Clay 的例子再往前走了一步:工作本身会变化,所以 Agent 需要“记住昨天之后发生了什么”。每个账号都有自己的工作空间和子 Agent,夜间查看一手来源并更新交易文件夹;早晨的协调 Agent 再把变化压缩成当天的优先动作。推荐旁边还放着证据,销售人员可以在行动前回看来源。这里最容易被忽略的是刷新节奏。持久上下文不是一个越大越好的知识库,而是知道什么信息该更新、多久更新一次、谁可以看到它。
Exa 的例子则是“证明”。它把生态中发现集成机会、收集上下文、写代码、跑测试、准备更新的过程串起来。Agent 可以创建 pull request,但不能替人决定哪个机会值得做,也不能跳过测试和人工审阅。这条边界很重要:真正可规模化的自动化,不是让系统永远往前冲,而是把它推到一个人能快速判断的检查点。
我把这三个案例压缩成一句自己的话:先教会流程,再保存变化,最后用证据把行动推出去。原文没有这样命名,这是我从三个案例里抽出的观察;但这个抽象能解释为什么单点 Copilot 往往很快遇到天花板。它只解决了“这一刻怎么回答”,没有解决“下一轮从哪里开始”。
Token 变多,不等于业务变好
Section titled “Token 变多,不等于业务变好”文章开头的 8.3 倍很醒目:AI 使用最靠前的企业,每位活跃用户产生的输出 token 是典型企业的 8.3 倍,而 1 月时是 2.6 倍。这个数字说明领先企业把更多工作交给了 AI,也可能说明它们在处理更长、更复杂的任务。
但这里必须刹一下车。OpenAI 的 Enterprise Signals 页面自己也提醒,token 不是业务价值的完美指标:短回答可能极有价值,长回答也可能什么都没解决。把 token 当成 KPI,很容易奖励一条越来越长、越来越贵、还需要人重新检查的流水线。
我会把观察拆成两层。第一层看工作深度:完成了多少任务,调用了哪些工具,连接了哪些上下文,Agent 工作了多久。第二层才看结果:周期是否缩短,返工是否减少,例外率有没有升高,人工审阅花了多少时间,最终的收入、质量或风险有没有改善。
这也解释了为什么 Clay 的“每晚少分拣约一小时”和 Basis 的“30 分钟入职”只能当成案例信号,不能直接当成普遍 ROI。它们告诉我们流程设计可能有效,但没有告诉我们换到另一家公司、另一套权限和另一种数据质量后,结果仍然成立。
给 Agent 一份能执行的岗位说明
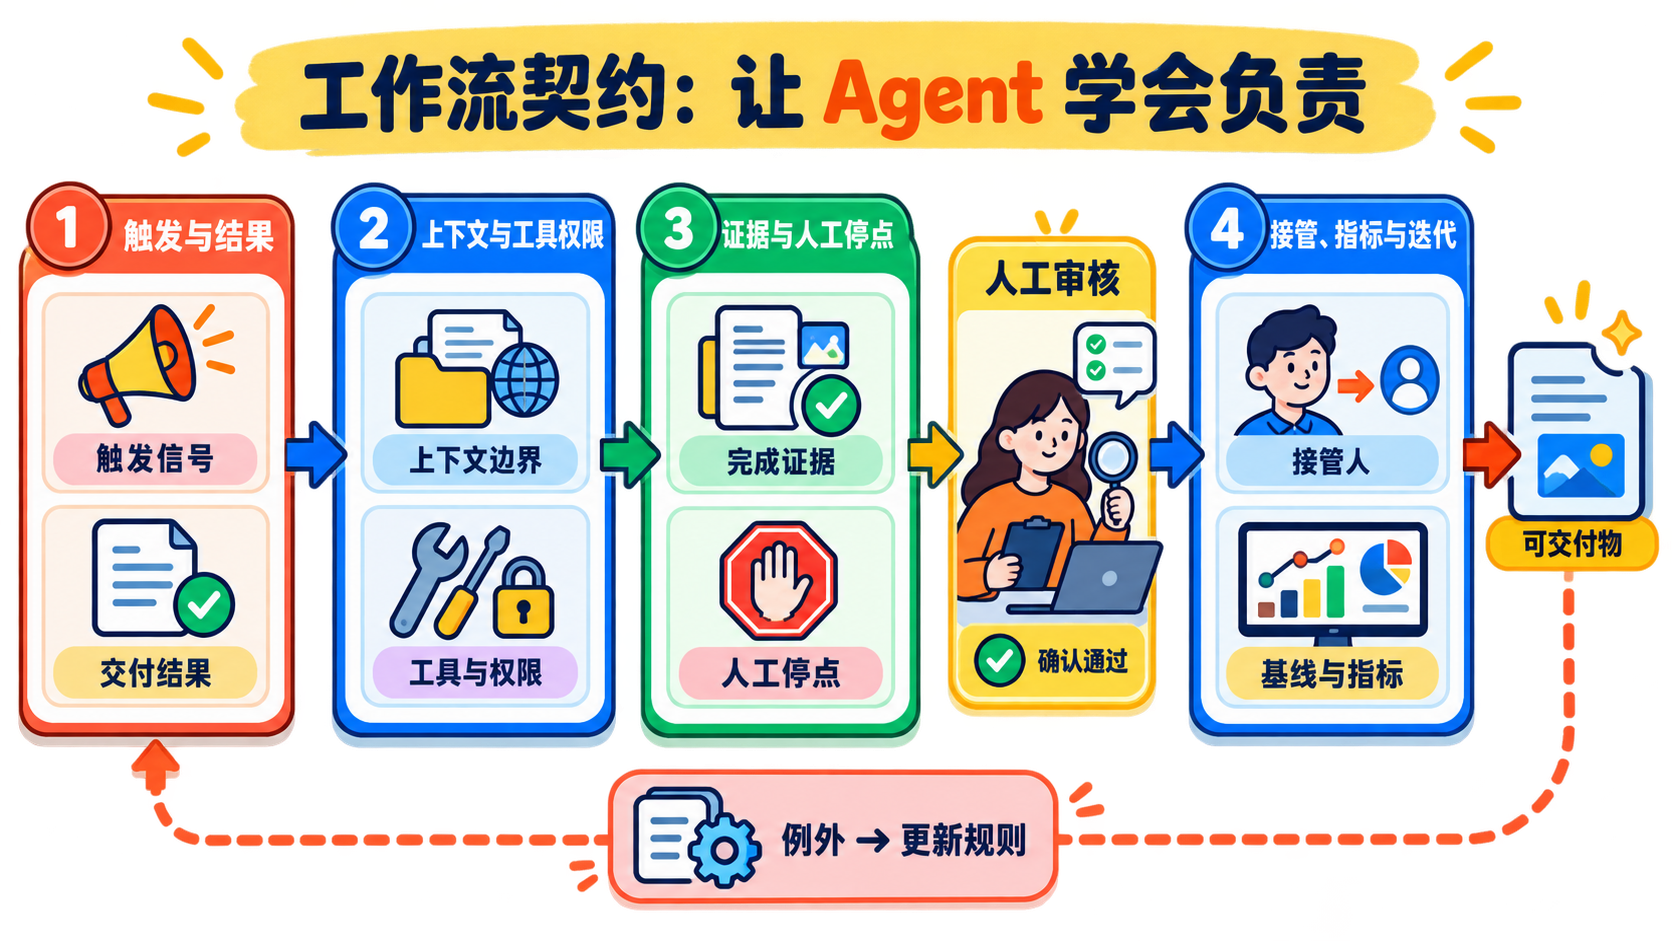
Section titled “给 Agent 一份能执行的岗位说明”如果要在小团队里试一条类似的工作流,我不会先问“我们要不要上 Agent 平台”,而会先写一份工作流契约。它至少要回答八个问题:
- 什么信号触发它?
- 这次要交付什么结果?
- 它必须读取哪些上下文,哪些内容不能读取?
- 能调用哪些工具,能修改哪些对象?
- 需要什么证据才能算完成?
- 哪一步必须停下来等人确认?
- 出现例外时由谁接管?
- 用什么基线、指标和时间窗口判断它值得继续?
说到底,这份契约就是 Agent 的岗位说明书。OpenAI 的六步建议里已经包含了其中大部分:选择一个有实质价值的工作面,定义负责人、KPI、基线和护栏,写清触发、上下文、工具、权限、证据和人工停点,再把有效的流程带到下一个工作面。
我在维护这套双线内容管线时,越来越觉得真正可复用的不是某次生成结果,而是状态、输入输出边界、图片与链接校验、人工审阅点,以及失败后从哪里恢复。文章写得再好,如果图片没有上传、引用 URL 断了,或者微信 HTML 和博客版本的语义不一致,流水线仍然算失败。这个经验和 Exa 的案例很接近:Agent 的产物要经过测试,人的责任也要落在明确的检查点上。
先让一个工作流学会负责
Section titled “先让一个工作流学会负责”我对这篇文章保留的一点疑问,是它对“失败之后怎么办”写得还不够多。Skill 可以改,工作区可以持续刷新,测试也能拦住一部分错误,但总要有人解释为什么失败、决定是否重跑,并承担错误已经发生时的后果。
因此我会给原文的六步法补上一条:先设计恢复路径,再扩大 Agent 权限。每次运行都要留下输入、证据、输出和审阅结果;例外不能只被当成日志里的红点,而要能回到流程定义里,告诉下一次运行应该增加哪条规则。只有当一个工作流的完成率、例外率和审阅负担都在可接受范围内,才值得把它复制到第二个工作面。
这比宣布“全员 AI 化”慢很多,也没有那么漂亮。但它更接近组织真正会遇到的日常:资料不全、系统权限变化、客户临时改口、某个测试偶尔失败。Agent 是否有价值,往往就在这些不顺利的时刻见分晓。
你所在的团队里,有没有一段工作已经重复到值得交给 Agent?如果明天就开始试,你最愿意先写清楚的是触发条件、权限边界,还是失败后的接管人?
- OpenAI:How AI-native companies turn workflows into operating capability:https://openai.com/index/ai-native-company-workflows/
- OpenAI:Enterprise Signals:https://openai.com/signals/enterprise-data/
- Basis:https://www.getbasis.ai/
- Clay:https://www.clay.com/about
- Exa:https://exa.ai/
- OpenAI Help Center:ChatGPT Work and Codex:https://help.openai.com/en/articles/20001275-chatgpt-work-and-codex
- 站内延伸阅读:AGENTS.md 不是文档,它是 Agent 时代的路由层、最稀缺的 AI 能力,正在变成访问权。本文只作主题延伸,不沿用其语言风格。