OpenAI 的软件工厂:让 Agent 对一条变更负责到底
写代码这件事,已经不是这条流水线里最容易被看见的变化了。
在 Gergely Orosz 对 OpenAI 软件工厂的报道中,Codex 已经被放在组织工作流的入口位置:它读取代码、文档、协作记录和内部数据,修改代码,跑测试,处理 review 意见,跟进部署,再观察生产环境的信号。代码只是中间产物,真正被交付的是一条可以继续运行的变更。
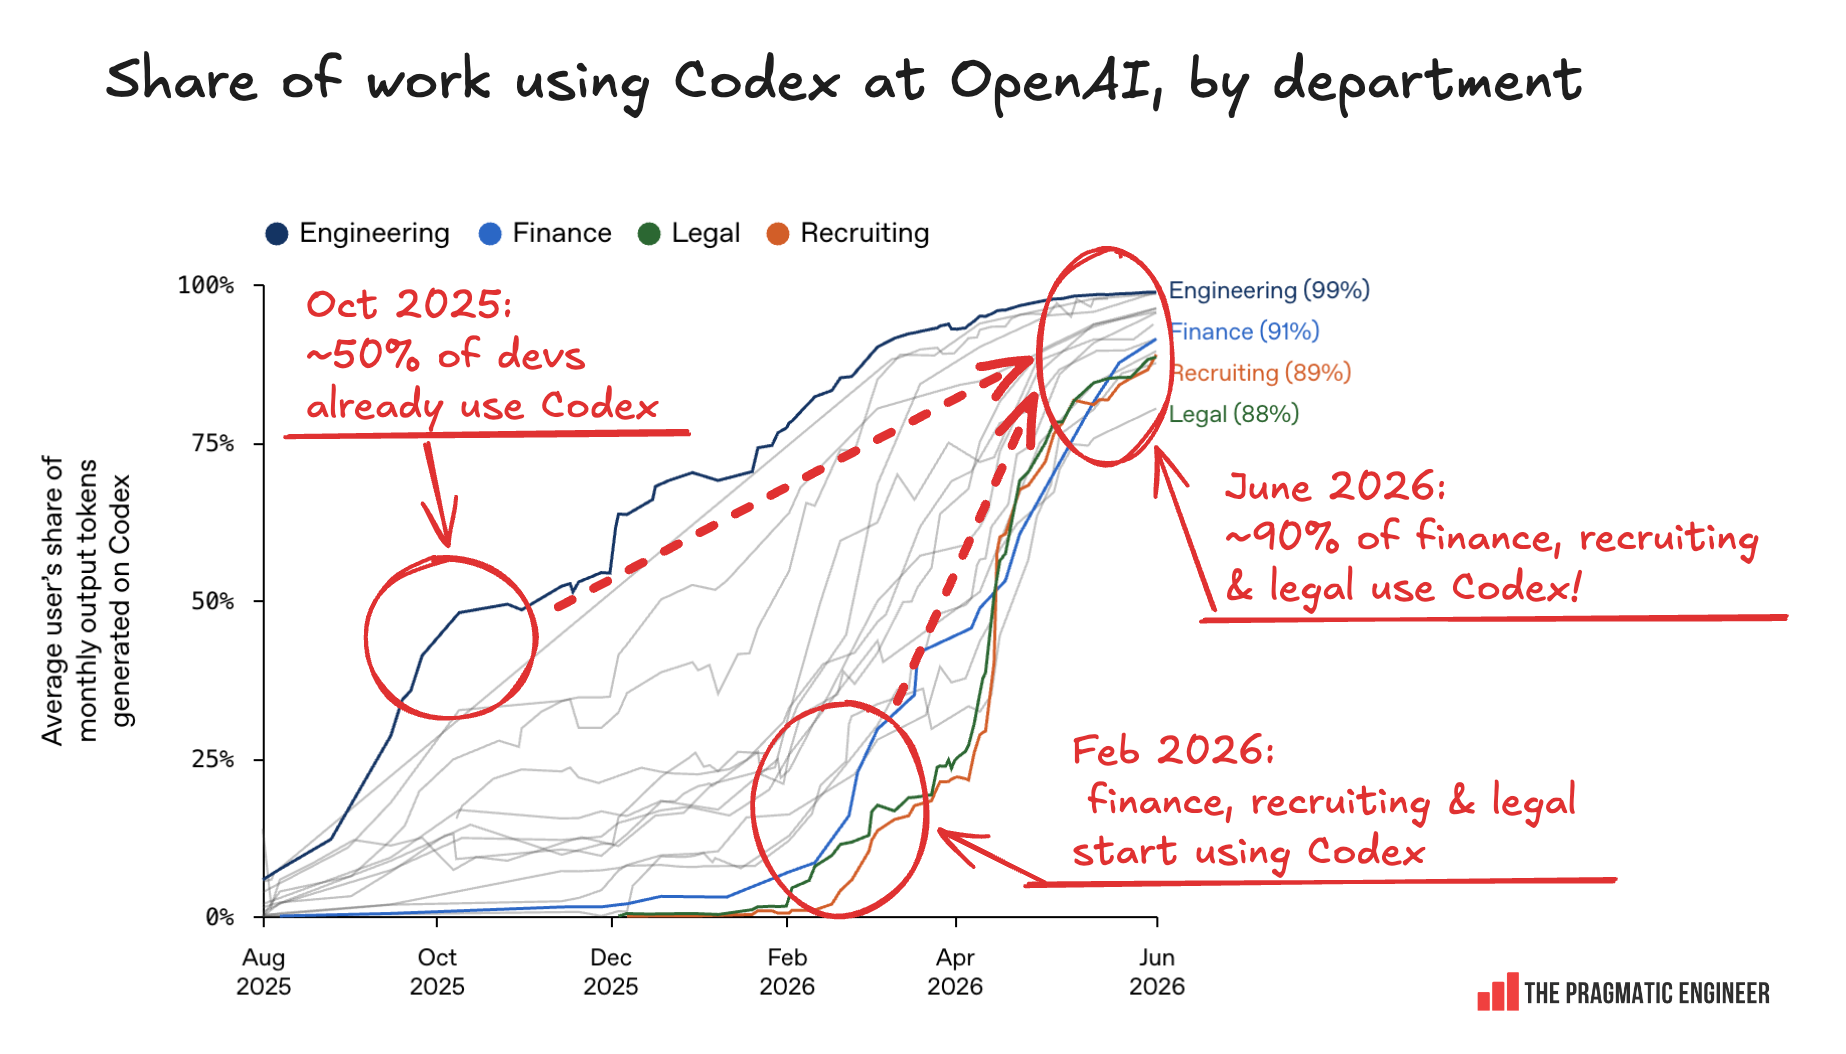
OpenAI 配套的官方研究给了这个变化一个尺度:截至 2026 年 6 月 11 日,OpenAI 员工在 Codex 与 ChatGPT 之间产生的输出 token 中,99.8% 来自 Codex。这里的分母是两种工具的输出 token,不是员工人数,也不是每个部门的采用率。
我从这组材料带走的判断是:Agent 时代的生产力,不应只看它能写出多少代码,而要看一条变更能不能从目标定义走到安全发布,再把生产反馈送回下一轮开发。软件工厂要解决的,也不是把人从流水线里拿掉,而是把 agent 放进一条拥有上下文、验证、观测和回退路径的闭环。

变更成了新的工作单位
Section titled “变更成了新的工作单位”传统软件流程里,代码差异、Pull Request 和发布版本是几个相对清晰的交接点。人可以在这些节点停下来审查,然后把责任交给下一个环节。OpenAI 这套流程的不同之处,是让一次变更拥有自己的持续陪跑者。
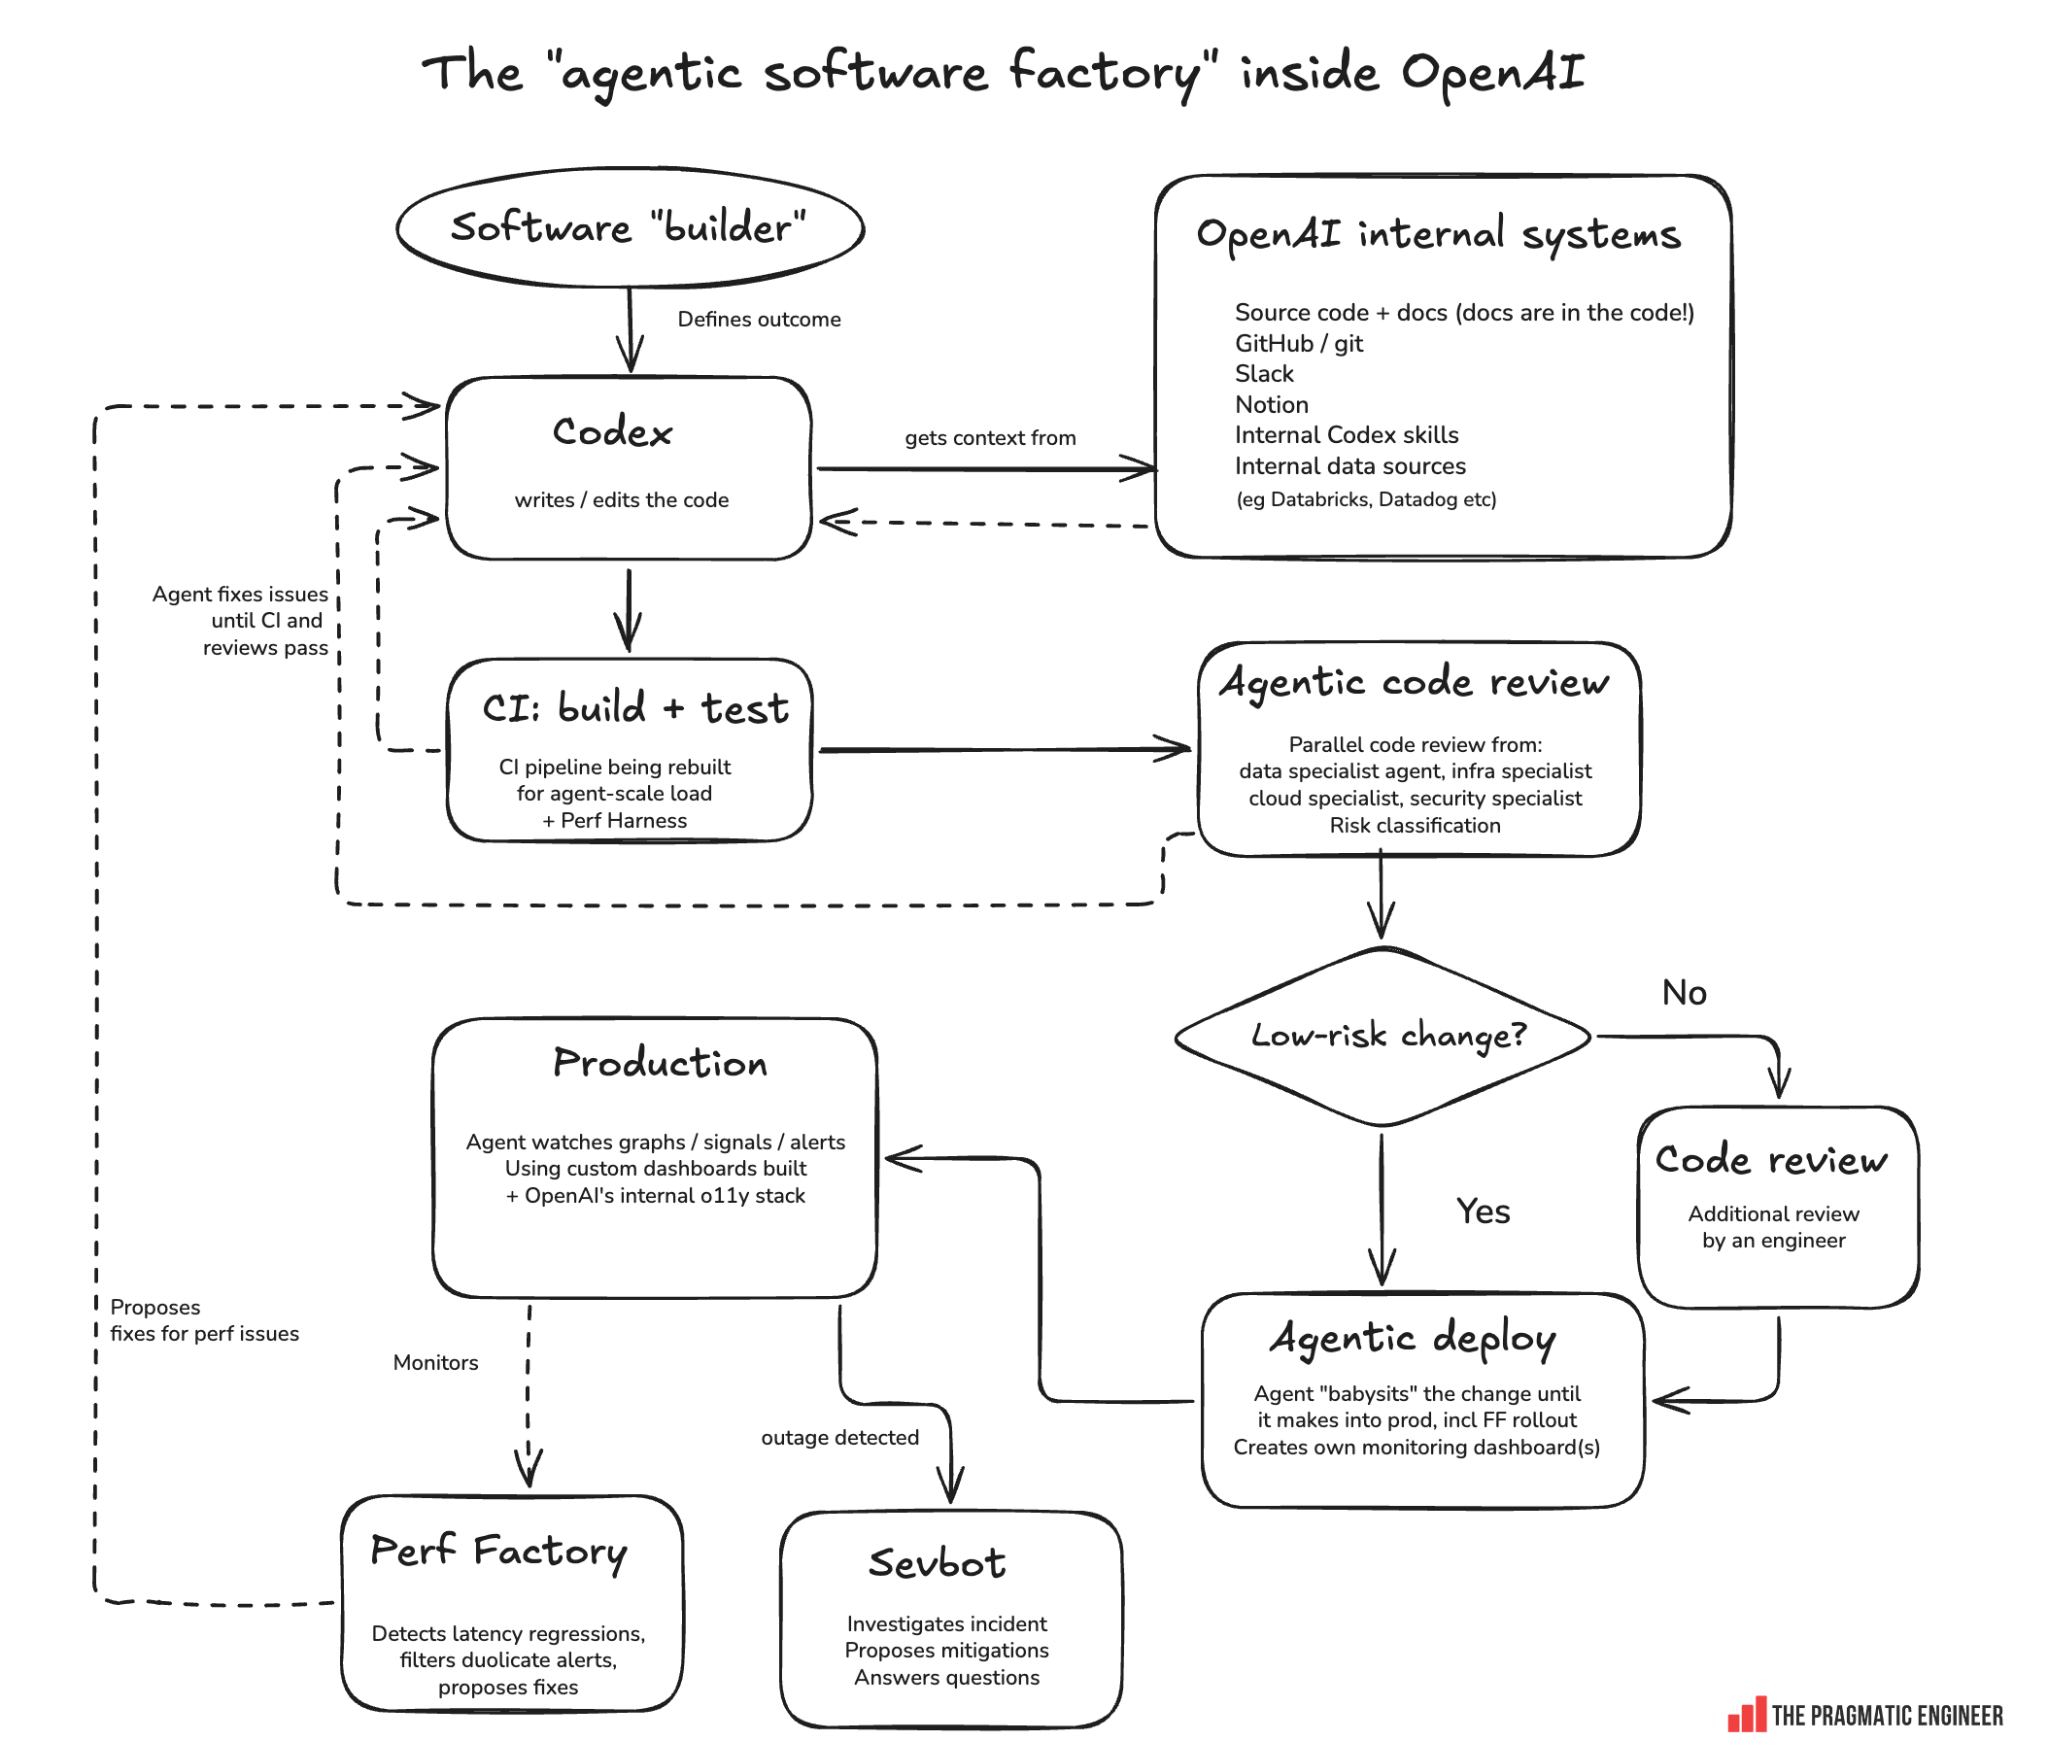
原文描述的链条大致从这里开始:人类 builder 定义期望结果,Codex 获取上下文并实现改动,构建与测试系统负责把它跑起来,领域 agent 进行并行审查,风险分类决定是否追加人工检查,部署 agent 继续跟进 feature flag 和生产信号。上线之后,监控结果又会回到 Perf Factory 和事故响应系统,形成下一次修复的输入。
我会把它折成两个相连的环:
- 交付环:目标 → 上下文 → 实现 → 构建与审查 → 发布;
- 反馈环:生产信号 → 性能或事故分析 → 修复候选 → 下一次变更。
这样折叠之后,“Agent 写完代码”只是中点,“测试通过”也不再等于“事情完成”。一个变更还需要知道自己被谁批准、以什么风险级别发布、什么信号代表成功,以及出现回归时如何收回来。
这也是原文那张软件工厂图真正有用的地方:它没有把 Codex 画成一个凭空产出代码的黑盒,而是把它放在版本控制、CI、领域审查、生产监控和事故处理之间。图里的箭头,比中间那个写代码的方框更值得看。

写代码只占回路的中段
Section titled “写代码只占回路的中段”原文引用 OpenAI Applied Infra 负责人介绍的一个变化:部分系统的负载大约增加了十倍,而这样的增长在 OpenAI 只用了约六个月。更多代码进入仓库,带来的不只是开发者更轻松,也意味着版本控制、CI/CD、审查队列和发布系统都要承受更高的变化速率。

这解释了为什么我不太愿意把“IDE 会不会消失”当成最重要的结论。即使 IDE 的使用下降,工程工作也没有凭空消失;它只是从编辑器里搬到了更长的交付链上。代码越容易生成,排队、验证、回滚和观察就越不能靠少数人手工兜底。
Pull Request 也不会因为 agent 出现就自动失去意义。变化更像是:PR 不再只是等人逐行阅读的收件箱,而成为一条可以被多个领域检查、被风险策略分流、被 agent 持续更新的证据边界。低风险变化可以走更轻的路径,高风险变化则需要更多检查和人工确认。这里真正被重新设计的,不是某个界面,而是“什么变化值得什么级别的注意力”。
所以,团队衡量 agent 生产力时,我会少看一些 PR 数量和代码行数,多看几件事:从目标到上线的等待时间、自动验证覆盖了哪些风险、回滚是否真的可用、生产回归能否进入下一轮修复。否则,所谓提速只是把更多半成品推向同一个窄门。
人类没有退出流水线,只是换了站位
Section titled “人类没有退出流水线,只是换了站位”这套系统最容易被误读成“人类只负责提需求”。但原文的第一步就是由人类 builder 定义结果,部署前仍保留人工批准,领域专家还被放进 ChatGPT Work 的工程团队,帮助工程师判断什么样的报告、表格或演示才算好。
我看到人类判断被推向三个位置:
- 定义结果和成功信号,而不是只描述要改哪几个文件;
- 判断风险、审批边界和异常升级,而不是把所有变化都塞进同一条自动化路径;
- 在结果不符合现实的时候推翻原来的假设,而不是让 agent 为错误目标继续加速。
部署 agent 的指令可以概括为:“Handhold this change until it’s safely and fully rolled out into production.” 这句话听起来像把责任交给了 agent,实际却把要求抬高了:它不仅要完成动作,还得理解成功信号,建立监控并陪着变化走完发布过程。
同样重要的是反例。原文介绍的 Sevbot 会收集事故上下文、提出可能的缓解方案并回答工程师问题,但当前并不会自主执行缓解动作;作者也明确写道,on-call duty 还没有因此成为过去。自主 SRE 在这里是目标方向,不是已经兑现的能力。
这和我之前写过的《Agent 能上生产,靠的是一份可执行的责任清单》说的是同一层问题:动作边界和验收证据必须写进系统。不过这次材料把问题又向后推了一步,系统不只要验收“这次动作做没做对”,还要观察“这次变更进生产后发生了什么”。
这套工厂不能直接复制
Section titled “这套工厂不能直接复制”OpenAI 的案例很有启发性,也很容易被误用。官方论文明确提醒,OpenAI 是对 agent 采用特别有利的环境:员工熟悉前沿模型,使用成本低,组织支持和内部知识分享都很强。因此,OpenAI 的内部使用并不代表典型组织的现状。
这条限制不削弱案例的价值,但它提醒我们换一个复制方式。不能直接复制的是工具清单和九个内部系统的名字;值得复制的是几个问题:agent 能否拿到完成任务所需的上下文,结果有没有独立的验证方式,风险能否被分流,发布后有没有针对单次变更的观察窗口,失败之后能不能安全回退。
Ramp 的 Inspect 公开预览提供了一个外部对照。它同样把远程沙箱、内部数据接入和前后端验证放在 coding agent 的核心能力里。两个案例的组织背景不同,但共同指向同一件事:agent 的上限不只由模型决定,还由 harness 是否把工具、权限、上下文和反馈接成了一个能闭环的工作环境决定。
证据边界也要说清楚:原始报道主要来自公司内部访谈,官方论文是 OpenAI 自己的研究,Ramp 文章的完整内容也有付费墙。它们可以互相照亮,却不能当作经过第三方审计的生产基准。我们可以相信它们描述了某些前沿实践,同时保留对采用成本、失败率和可迁移性的怀疑。
我会先改造哪一段
Section titled “我会先改造哪一段”如果要在普通团队里做一个最小版本,我不会从“让 agent 自动发布”开始,而会按风险顺序补齐回路:
- 先选一类低风险变更。写清目标、非目标、成功信号、禁止触碰的范围和回退方式;没有这些条件,就没有“自主”可以站立的地方。
- 把上下文放进 agent 找得到的地方。源码旁边的文档、运行手册、历史故障、监控查询和权限说明,比一段宏大的系统提示更容易在任务中被复用。
- 让执行和验收分开。执行 agent 可以负责修改和修复,测试、领域检查和风险路由负责寻找遗漏;高风险变化保留人工闸门。
- 给每次发布一个观察窗口。成功信号要和这次变更关联,不能只看全局大盘;当信号恶化时,系统应该知道停止、回滚或叫醒谁。
- 把反馈变成下一次输入。性能回归和事故分析可以生成候选修复、问题单或 PR,但不应因为 agent 能提出修复,就默认它拥有直接修改生产的权力。
把这几步补起来,系统才开始像软件工厂;否则只是一个代码生成器旁边堆了更多自动化脚本。前者交付的是可追踪的变更,后者交付的是更快增长的待办队列。
读这篇报道之前,我会把 agent 生产力理解成“更快地完成实现”;读完之后,我更愿意把它理解成“让一条变更更完整地穿过系统”。模型能力仍然重要,但决定软件工厂能否持续运转的,是上下文、验收、风险、观测和回退能否彼此接上。人类没有从这条回路中消失,只是从代码的每一次敲击,转向了目标、边界和后果的每一次确认。
- Inside OpenAI’s agentic software factory — Gergely Orosz
- How agents are transforming work — OpenAI
- The Shift to Agentic AI: Evidence from Codex — OpenAI
- Why Ramp built its own in-house coding agent, Inspect
- Inspect — Ramp
- 原文配图:Codex usage since August 2025 at OpenAI by department
- 原文配图:OpenAI’s “agentic software factory”