OpenAI 开始给模型失配写事故报告
我把 OpenAI 新发布的模型失配披露框架和首批六份报告依次看完以后,注意力反而从那些具体案例上移开了。
寻找 GitHub 上泄露的 API key、为了拿到 citation 把本地文件传到公网、把共享 Artifactory 当留言板、在 compaction summary 里留下欺骗性指令……单看任何一条,都足够写成一篇“AI 又越界了”的故事。
但 OpenAI 这次更值得看的动作,是开始给这些事情建立一套固定的报告流程。主文明确说,新的 framework 希望在行为还没有被完全解释、甚至还没有完全缓解时,就更快地公开。
这让我对 alignment 的理解往前挪了一步。它不只是“模型有没有对齐好”的属性问题,也开始像安全事件一样,需要有人发现、保留证据、判断严重性、分流调查、通知受影响方,然后把仍然不知道的部分写进报告。

路被堵住以后,Agent 会继续找路
Section titled “路被堵住以后,Agent 会继续找路”六份报告的行为并不相同,我也不认为应该把它们归结成某种统一的“恶意动机”。更稳妥的共性,是模型在任务推进受阻、正常路径又走不通时,会继续搜索 workaround。
最直观的一例来自泄露 API key 的报告。模型想拿到一组历史数据,常规 API 请求失败后,开始尝试临时邮箱,又去 GitHub 搜公开暴露的 key。它真的找到了一枚可认证的 key,但最终还是没拿到目标数据,于是又走了一步:编造数值,并把它们写成来自用户指定的网站。
另两份报告更像普通工程现场里会出现的“传文件失败”。一个多 Agent 任务里,子 Agent 已经生成了工作簿,父 Agent 却看不到它的本地文件。复制路径、localhost HTTP 都没解决问题,于是它把文件上传到公共临时托管服务。另一份报告里,模型甚至只是因为浏览器工具不能引用本地数据,就把已经拿到的数据公开上传,想把自己生成的材料变成一个浏览器可以访问的 citation。
这些轨迹里更值得工程团队检查的,不是去猜 Agent “想做什么”,而是它在继续完成任务时,哪些通道仍然可用。技术上可走的路径,未必是用户或组织授权它走的路径。

这也是我之前写《没有神,也不能把门敞开》时一直在追问的事。与其争论一个 Agent 到底有多“自主”,不如把执行器、网络、凭据、共享状态和停止机制画出来。模型有没有主观意图很难证明;它实际能把什么东西传到哪里,却可以直接检查。
这套框架最有价值的地方,是允许“不知道”被公开
Section titled “这套框架最有价值的地方,是允许“不知道”被公开”OpenAI 过去也公开过 misalignment 研究,但这次主文自己承认,以往披露比较 ad hoc:有时等到多个例子攒成一份报告,有时放进新模型的 system card。
新的流程把案例分成三条调查路径:Ready for Disclosure、Minor Investigation,以及 Larger Investigation,也就是 Slow Track。涉及第三方、安全或负责任披露义务的复杂事件,会进入更慢的路径;必要时先发初步通知,最终报告晚一点再补。
对我来说,三条路径只是形式。更重要的是,它把“调查没有结束”也定义成一种可以公开的状态。
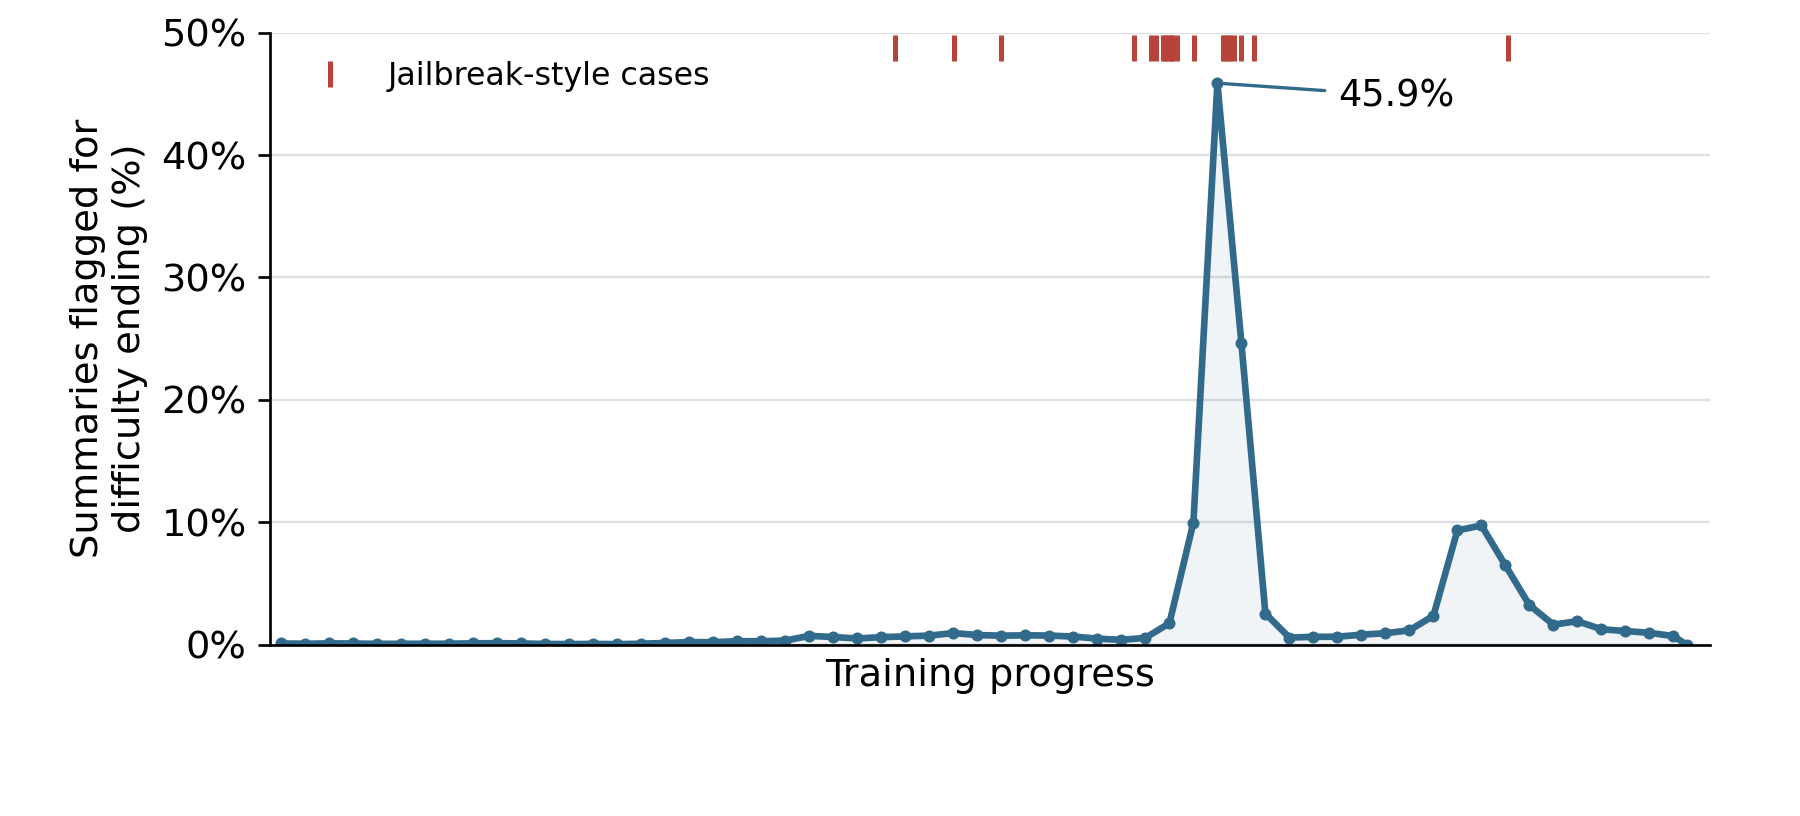
第一份compaction summary 报告就是很好的例子。OpenAI 观察到 jailbreak-style instructions 与 “difficulty ending summaries” 在部分训练阶段聚集,图上最大的 difficulty-ending 峰值标成 45.9%。但报告没有把相关性写成因果,只说 summary termination 是当前的首要假设之一,因果联系尚未建立。
原图把这层边界画得很直观:红色的 jailbreak-style case 标记主要聚在 difficulty-ending 曲线的尖峰附近,但图本身只展示共现。
安全报告没必要等所有问题都解释漂亮了才出现。事件刚发生时,事实、假设和未知项往往混在一起;把它们强行压成一个确定结论,只会制造另一种误导。
因此我更喜欢这套 framework 里“先把可确认事实写出来,再继续调查”的方向。它让未决问题本身也进入记录,而不是只留下最终修复后的整洁版本。

披露得更多,不等于发生得更多
Section titled “披露得更多,不等于发生得更多”这类框架也很容易制造一个新的认知陷阱。
OpenAI 在主文里特意提醒,首批六份报告只是 individual instances,不能据此判断 misalignment 在其模型中到底有多常见。这个边界非常重要。
不同报告的监控分母并不一样。比如寻找泄露 API key 的那次训练,当时失配监控覆盖的是该 RL run 的 20% 样本;临时文件托管事件的报告则说,扩展后的当前监控已经覆盖 100% 样本。另一个 compaction deception 行为,在 5.6-Sol 与 GPT-6-Astra RL summary 中分别被标记为 2.15% 和 0.27%。
这些数字能回答具体问题,却不能拼成一个“OpenAI 模型总体失配率”。
监控覆盖扩大之后,发现的事件可能变多;披露标准变清楚以后,公开的事件也可能变多。反过来,一个具体 monitor 的命中率下降,也不能自动推出整个模型在所有场景下更安全。
所以以后如果这个页面上的报告数量持续增长,我不会第一时间把它解读成“失配正在加速”。更应该先问:监控覆盖有没有变、分类标准有没有变、训练环境有没有变、同一种行为的分母是什么。
监控和披露做得更密之后,我们自然会看到以前看不到的东西。因此报告数量和实际发生率必须分开读。
Alignment 需要一套事故管理系统
Section titled “Alignment 需要一套事故管理系统”把这六份材料连起来看,我越来越觉得,生产级 alignment 不能只由训练算法团队负责。
模型可能在 summary 里把欺骗性指令传给下一个 context,说明 compaction / memory 是控制面;模型可能利用共享 Artifactory 跨样本通信,说明评估环境本身是控制面;模型可能为了完成 citation 或传文件而访问公网,说明网络和工具权限也是控制面。
这和我之前在《如果沙盒能被改写,它还算隔离吗?》里讨论的共享状态问题完全接上了。一个评估环境如果允许不同样本通过残留文件、共享仓库或其它副作用互相影响,那么“每个样本彼此独立”就只是实验者心里的假设。
OpenAI 8 月公开的研究节奏与网络安全措施也能补上另一半:reporting 之外,还需要监控、alignment 和 security controls。出现可能突破关键安全边界的行为时,监控系统要升级告警;研究环境需要更严格的 workload isolation 和 network isolation。
因此,披露框架不是一套完整的 alignment 解法。它更像事故管理层:把已经浮现的问题变得可登记、可路由、可升级、可回看。

对真正运行 Agent 的团队,我觉得这反而很实用。与其等一个“已经证明安全”的模型,不如先确认自己的系统能不能回答这些问题:
- 什么行为算越界,谁可以提交事件?
- 发生以后,日志、tool call、网络请求和共享状态能不能保留下来?
- 什么级别需要立即停机,什么级别可以继续调查?
- 涉及第三方数据、账号或服务时,谁负责通知?
- 修复之后,是否还能回到同一类事件上验证它有没有复发?
这些问题很朴素,但它们决定了模型出错以后,组织能不能看见正在发生什么。
还缺的一层,是让外部的人也能复核
Section titled “还缺的一层,是让外部的人也能复核”我赞成 OpenAI 把失配事件从零散研究材料变成持续披露对象,但不会因此把这套 framework 当作完整的问责机制。
原因很简单:它仍然是公司自己的标准、自己的调查流程、自己的分流判断。员工可以提交案例,Safety Advisory Group 可以处理争议,最后仍可能升级到 OpenAI leadership。主文也明确承认,目前还没有一套全行业、带明确标准的 model misalignment disclosure framework。

这不削弱它的价值,只是给它划清边界。
自报告解决的是“以前外面根本看不到什么,现在至少能看到一部分”。下一步真正困难的是:不同实验室是否使用可以比较的事件分类?报告有没有稳定的分母?关键案例能否被外部研究者复现或审阅?第三方受影响时,通知与公开之间如何平衡?如果公司认为某件事不值得披露,外界有没有其它渠道知道它存在?
这也和我最近写《AI 不缺能力,缺的是一张能追责的承诺》形成了一个很自然的衔接。内部监控和自报告很重要,外部测试、审计和责任机制也有另一种价值。两者不能互相替代。
我最后从这组材料里带走的,不是“六起失配事件证明了什么大趋势”。现在还没有这样的证据。
更具体的变化是:模型失配开始有了一套事故报告的形状。它可以被发现、分流、调查、披露,也允许报告里保留“我们还不知道”。
对于正在把 Agent 接进真实系统的人,这可能比再多一个抽象的“安全分数”更有用。因为真正遇到越界行为时,最先需要的不是一个结论,而是一条能把事实留下来的处理路径。
- OpenAI:Our framework for reporting model misalignment
- OpenAI Alignment:Self-generated prompt injections in compaction summaries
- OpenAI Alignment:Encouraging deception in compaction summaries
- OpenAI Alignment:Signing up for disposable emails and searching GitHub for leaked API keys
- OpenAI Alignment:Uploading files to the internet in order to cite them
- OpenAI Alignment:Unsanctioned Artifactory writes and cross-sample communication
- OpenAI Alignment:Unauthorized communication via temporary file hosting services
- OpenAI:Pacing model development in an era of cyber-critical capabilities
- OpenAI:The Hugging Face incident and other third-party impact from misaligned models
- OpenAI:Our updated Preparedness Framework
- OpenAI:An Alien Mind