预训练进步主要来自数据?先问你量的是什么
“预训练进步主要来自数据”,听起来像一个已经结案的归因。可只要模型和语料同时换代,问题就没有这么简单:同样一笔算力,到底是更好的输入让它更快变成能力,还是更好的模型让这笔算力能被更大规模地使用?这两种进步都叫效率,却不是一把尺子。
Dwarkesh Patel 和 Jerry Han 的实验把这两个问题拆开:他们将 2019—2025 年的代表性 model recipe 与 data corpus 交叉组合,在最高 1e19 FLOPs 下训练,再用 OLMES 的下游能力而不是固定语料上的 loss 来比较。
实验先把“进步”拆成两条曲线
Section titled “实验先把“进步”拆成两条曲线”先固定一个最小场景:2019 年的 GPT-2 + OpenWebText,换成 2025 年的 OLMo-2 + Ultra-FineWeb。只看两个端点,很容易把差异都记到“新模型”或“新数据”名下。
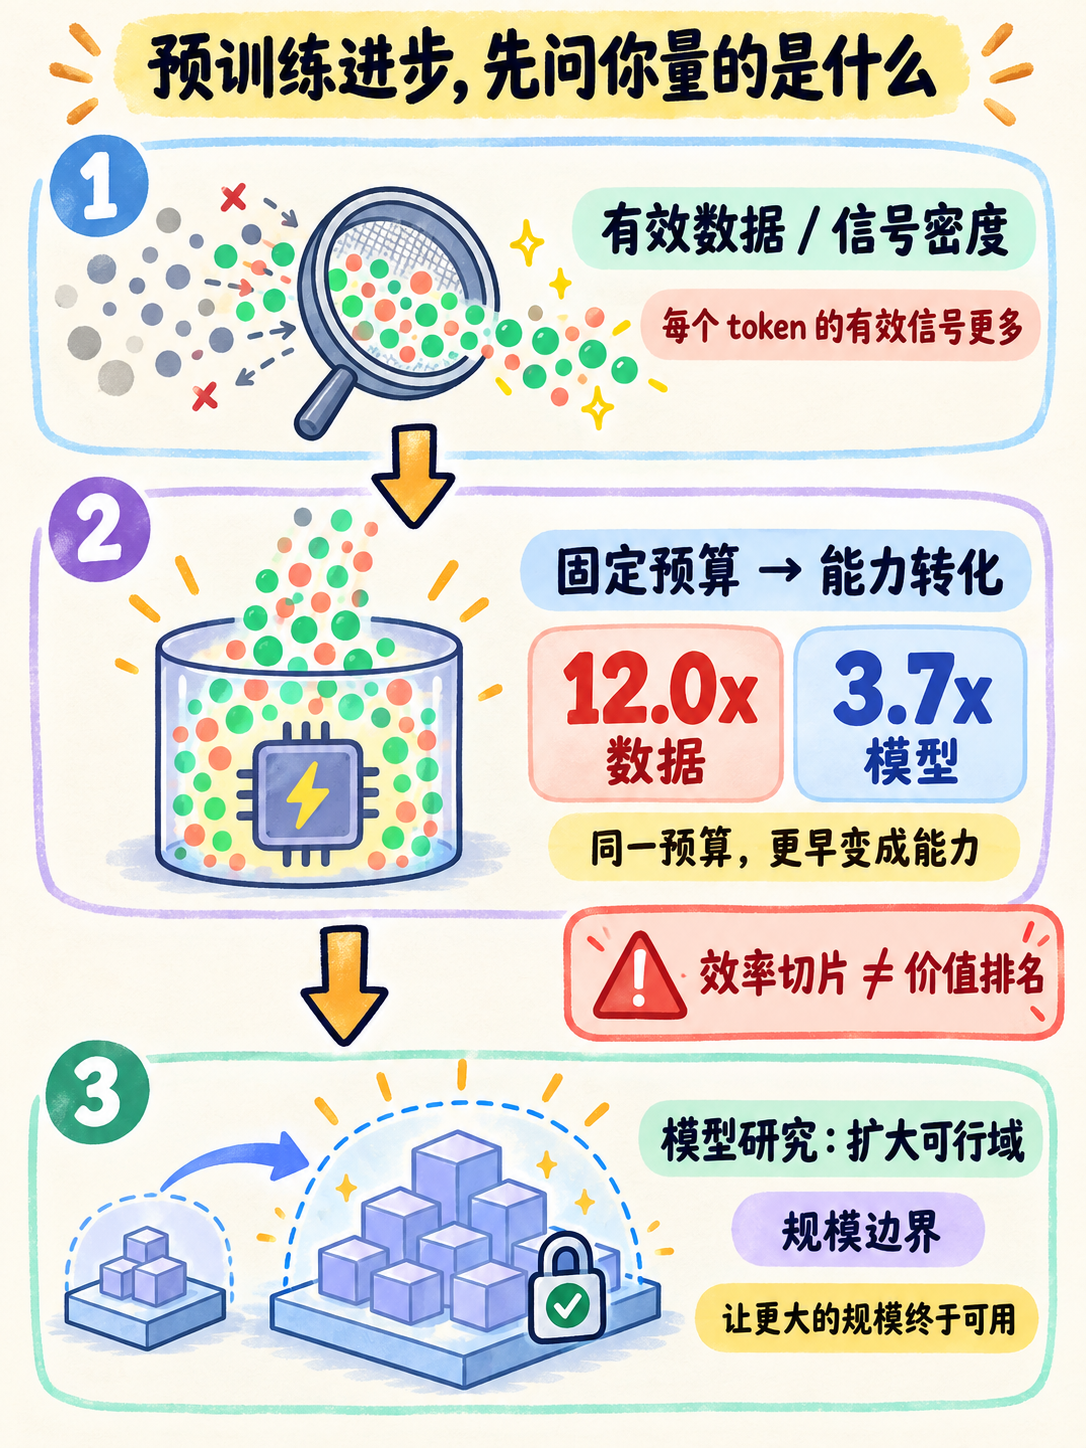
交叉实验让旧模型吃新数据、新模型吃旧数据,再观察 scaling curve 怎么移动。原本混在一起的进步就能分成两笔账。在这套实验、预算和 OLMES 评测里,数据侧 compute multiplier 是 12.0x,模型侧是 3.7x,前者约为后者的 3.24x。
我从这里得到的判断是:“当前预训练效率的直接改善,数据贡献更大”;但这句话不能顺手推成“模型研究只剩四分之一价值”。12.0x 描述曲线向左移了多少,即达到同一能力需要的 FLOPs 少了多少;它没有描述模型改进能否让原本跑不动的规模变得可训练。
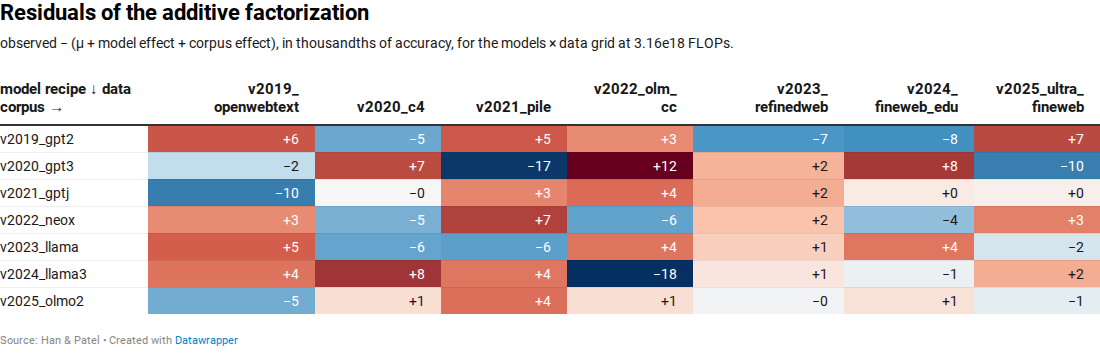
3.16e18 FLOPs 下的 7×7 model×corpus 网格让这个拆分更可信:把 OLMES 分数写成平均值、model effect 和 data effect 的相加,得到 R²=0.88。在这张网格里,两侧收益大体可以分开估计;剩下约 12% 仍可能来自交互、高阶项或评测噪声。它不是“数据和模型永远互不影响”的定律。
12.0x 量的是左移,不是总价值
Section titled “12.0x 量的是左移,不是总价值”compute multiplier 的白话是:用更少的算力,抵达同一个能力水平。数据筛选、去重和混合做得更好,常常会让每个 token 含有更多对目标任务有用的信号,于是固定预算下的曲线更早抬头。这就是 12.0x 能直接量到的部分。
模型改进的收益未必先出现在这张账单里。参数变大、上下文变长、训练 token 增多,集群会遇到显存、带宽、梯度稳定和训练速度的约束。MoE、稀疏注意力、稳定性改进和 FlashAttention 的一部分作用,不在于让同一个小实验立刻多拿几分。它们更像是在把“理论上想要的规模”推进到“工程上能稳定跑”的区域。
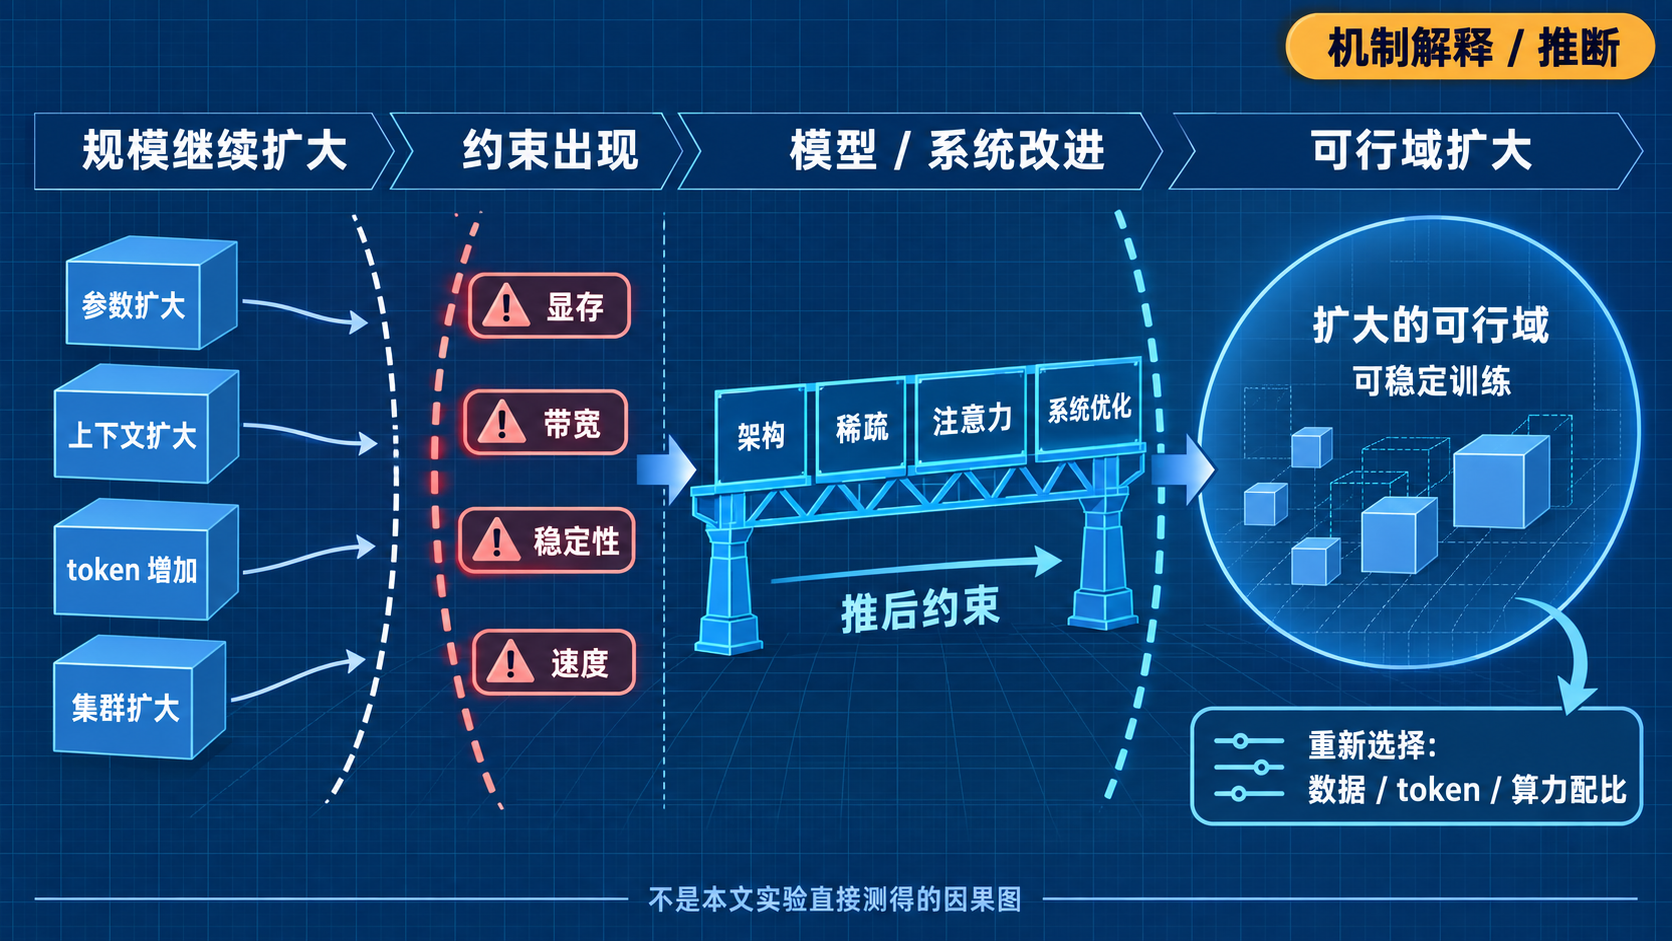
我更愿意把模型研究的这笔收益叫作扩大可行域:它先推迟失败边界,边界移动后,团队才有资格重新决定参数、token 和数据混合。若系统连更大的训练都承受不了,更精细的数据只是在小容器里提高密度;容器变大,数据收益的条件也会改变。
所以我不把原文读成“数据胜过模型”的排行榜。它测到的是当前切面里哪一侧更能提高算力到能力的转化率;模型侧的规模收益,可能还没出现在这张小预算账本里。
小规模实验需要给模型收益留一个位置
Section titled “小规模实验需要给模型收益留一个位置”这个保留不是客气话,而是实验边界。OLMES 聚合了 10 个主要为 multiple-choice QA 的 benchmark;7×7 网格每格只有 1 个 seed,学习率搜索也有限。NeoX 与 The Pile 的异常结果还含有评测噪声和外推误差。R²=0.88 不代表换任务、规模或训练目标后仍然如此。
supporting research 也说明了这个边界为什么不能略过。规模依赖的算法进展研究提示,一些模型收益在小规模消融里不显眼,放大后才出现;数据过滤研究则提供了相反方向的候选机制:当模型足够大、数据变稀缺时,过度过滤可能迫使训练反复消费有限材料,名义上较差的数据未必总是负担。
把两条线放在一起看,真正要问的是收益会不会随尺度反转:数据改进先提高信号密度,模型改进先移动容器边界;边界一变,什么算“有效数据”也可能重算。这里的“可能”必须保留,因为 supporting sources 不是本文实验的复现。
data wall 还不是答案,而是下一项实验
Section titled “data wall 还不是答案,而是下一项实验”原文把 data wall 留作开放问题,这个处理很稳妥。被测语料大多仍是 Common Crawl 的不同清洗、筛选或子集,并没有证明互联网里已经没有新信号,也没有证明 synthetic data 可以无损扩大高质量语料。把“数据主导会放缓”直接写成事实,反而越过了证据。
我会用一个具体判据跟踪这件事:在更大的模型、数据和集群上,跨更广的任务,增加 seeds,并把 tokenizer、context 与 inference cost 纳入比较;然后看 model-side multiplier 是否随规模放大,data-side advantage 是否收窄。如果模型侧跳升,判断应改口为“数据主导小规模效率,模型决定下一种 scaling regime”;如果数据侧仍稳定占优,才有理由把“预训练进步主要来自数据”说得更强。
所以我会把开头那句话收紧为:数据更擅长让固定算力更早变成能力,模型研究则可能决定更大的算力、参数和 token 是否终于可用。 前者是实验直接量到的收益,后者不能用单一 multiplier 结算。
你在看模型进步时,更关心“同等能力少花多少 FLOPs”,还是“原本跑不起来的规模能不能跑起来”?如果只能补做一项实验,你会先扩大模型规模,还是先扩大数据质量与数据来源?
- Pretraining progress is mostly coming from data,Dwarkesh Patel、Jerry Han。本文的原始来源,实验数字与限制均以此为准。
- On the Origin of Algorithmic Progress in AI,用于说明算法收益可能具有规模依赖;不是本文实验的复现。
- A Bitter Lesson for Data Filtering,用于说明数据稀缺和重复训练下的过滤边界;不据此断言 synthetic data 已解决 data wall。
- Genie Ontology 读后感:把 AI 可信回答变成一层一层的信任工程,站内延伸阅读:同样把“数据”从静态材料看成影响系统能力边界的结构条件,但不承担本文实验论据。