LLM 变快的秘密,是让大模型少做几次决定吗?

读 ByteByteGo 的这篇解释 时,我先被一个数字绊住了:一个 70B 模型每生成一个 token,可能要从显存里搬大约 140 GB 的权重,但解码阶段真正用到的计算单元只有约 20%–40%。我以前想到“让模型更快”,第一反应总是更多算力。这个数字把我的直觉拧了一下:大模型有时不是算不动,而是搬得太慢。
慢的是搬运,不是思考
Section titled “慢的是搬运,不是思考”普通生成像接龙。模型读完目前已有的内容,算出下一个 token,再把这个 token 接回上下文,继续下一轮。第 50 个 token 要等第 49 个 token 出现,依赖链没有消失。KV cache 只能把已经算过的历史状态做成便签,不能把“下一个词是什么”提前算出来。
所以,500 个输出 token 大致就要经历 500 次串行解码步。每一步都要把模型权重从 VRAM 读进计算单元,再对一个很窄的向量做运算。文章给出的量级是:prompt processing 的计算利用率可以到 90%–95%,而 token generation 只有 20%–40%。此时决定速度的,往往是内存带宽,而不是芯片宣传页上的峰值 FLOPS。

这也是我读完后最先修正的判断:优化推理,不一定要让每次计算更复杂,先要看每次搬进来的数据有没有被充分利用。推测解码的机会,就藏在这块“已经付了搬运费、却没有塞满的计算空间”里。
它没有打破因果,只是先写草稿
Section titled “它没有打破因果,只是先写草稿”Transformer 有一个容易被忽略的能力:给定一串 token,它可以在一次前向传播里为多个位置计算预测。因果掩码会挡住未来信息,第 3 个位置只能看见前 3 个位置,所以这种并行评分并没有偷看答案。
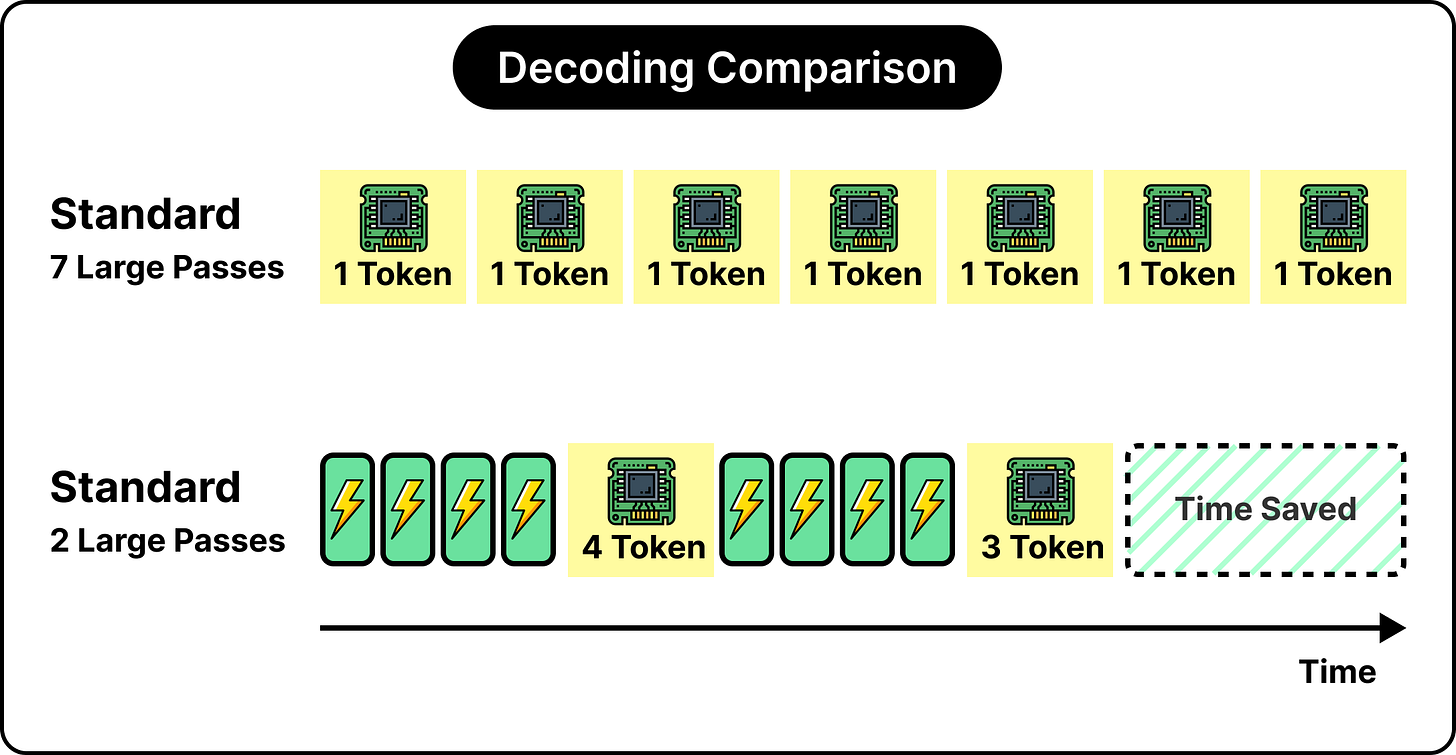
推测解码借的就是这个差别。一个更小、更快的 draft model 先串行猜出 K 个 token,target model 把这 K 个候选接到上下文后,一次性检查多个位置。原始论文把这个方法概括成“用近似模型提出候选,再由大模型并行验证”,并在特定条件下报告了约 2–3 倍的加速,同时保持输出分布不变。

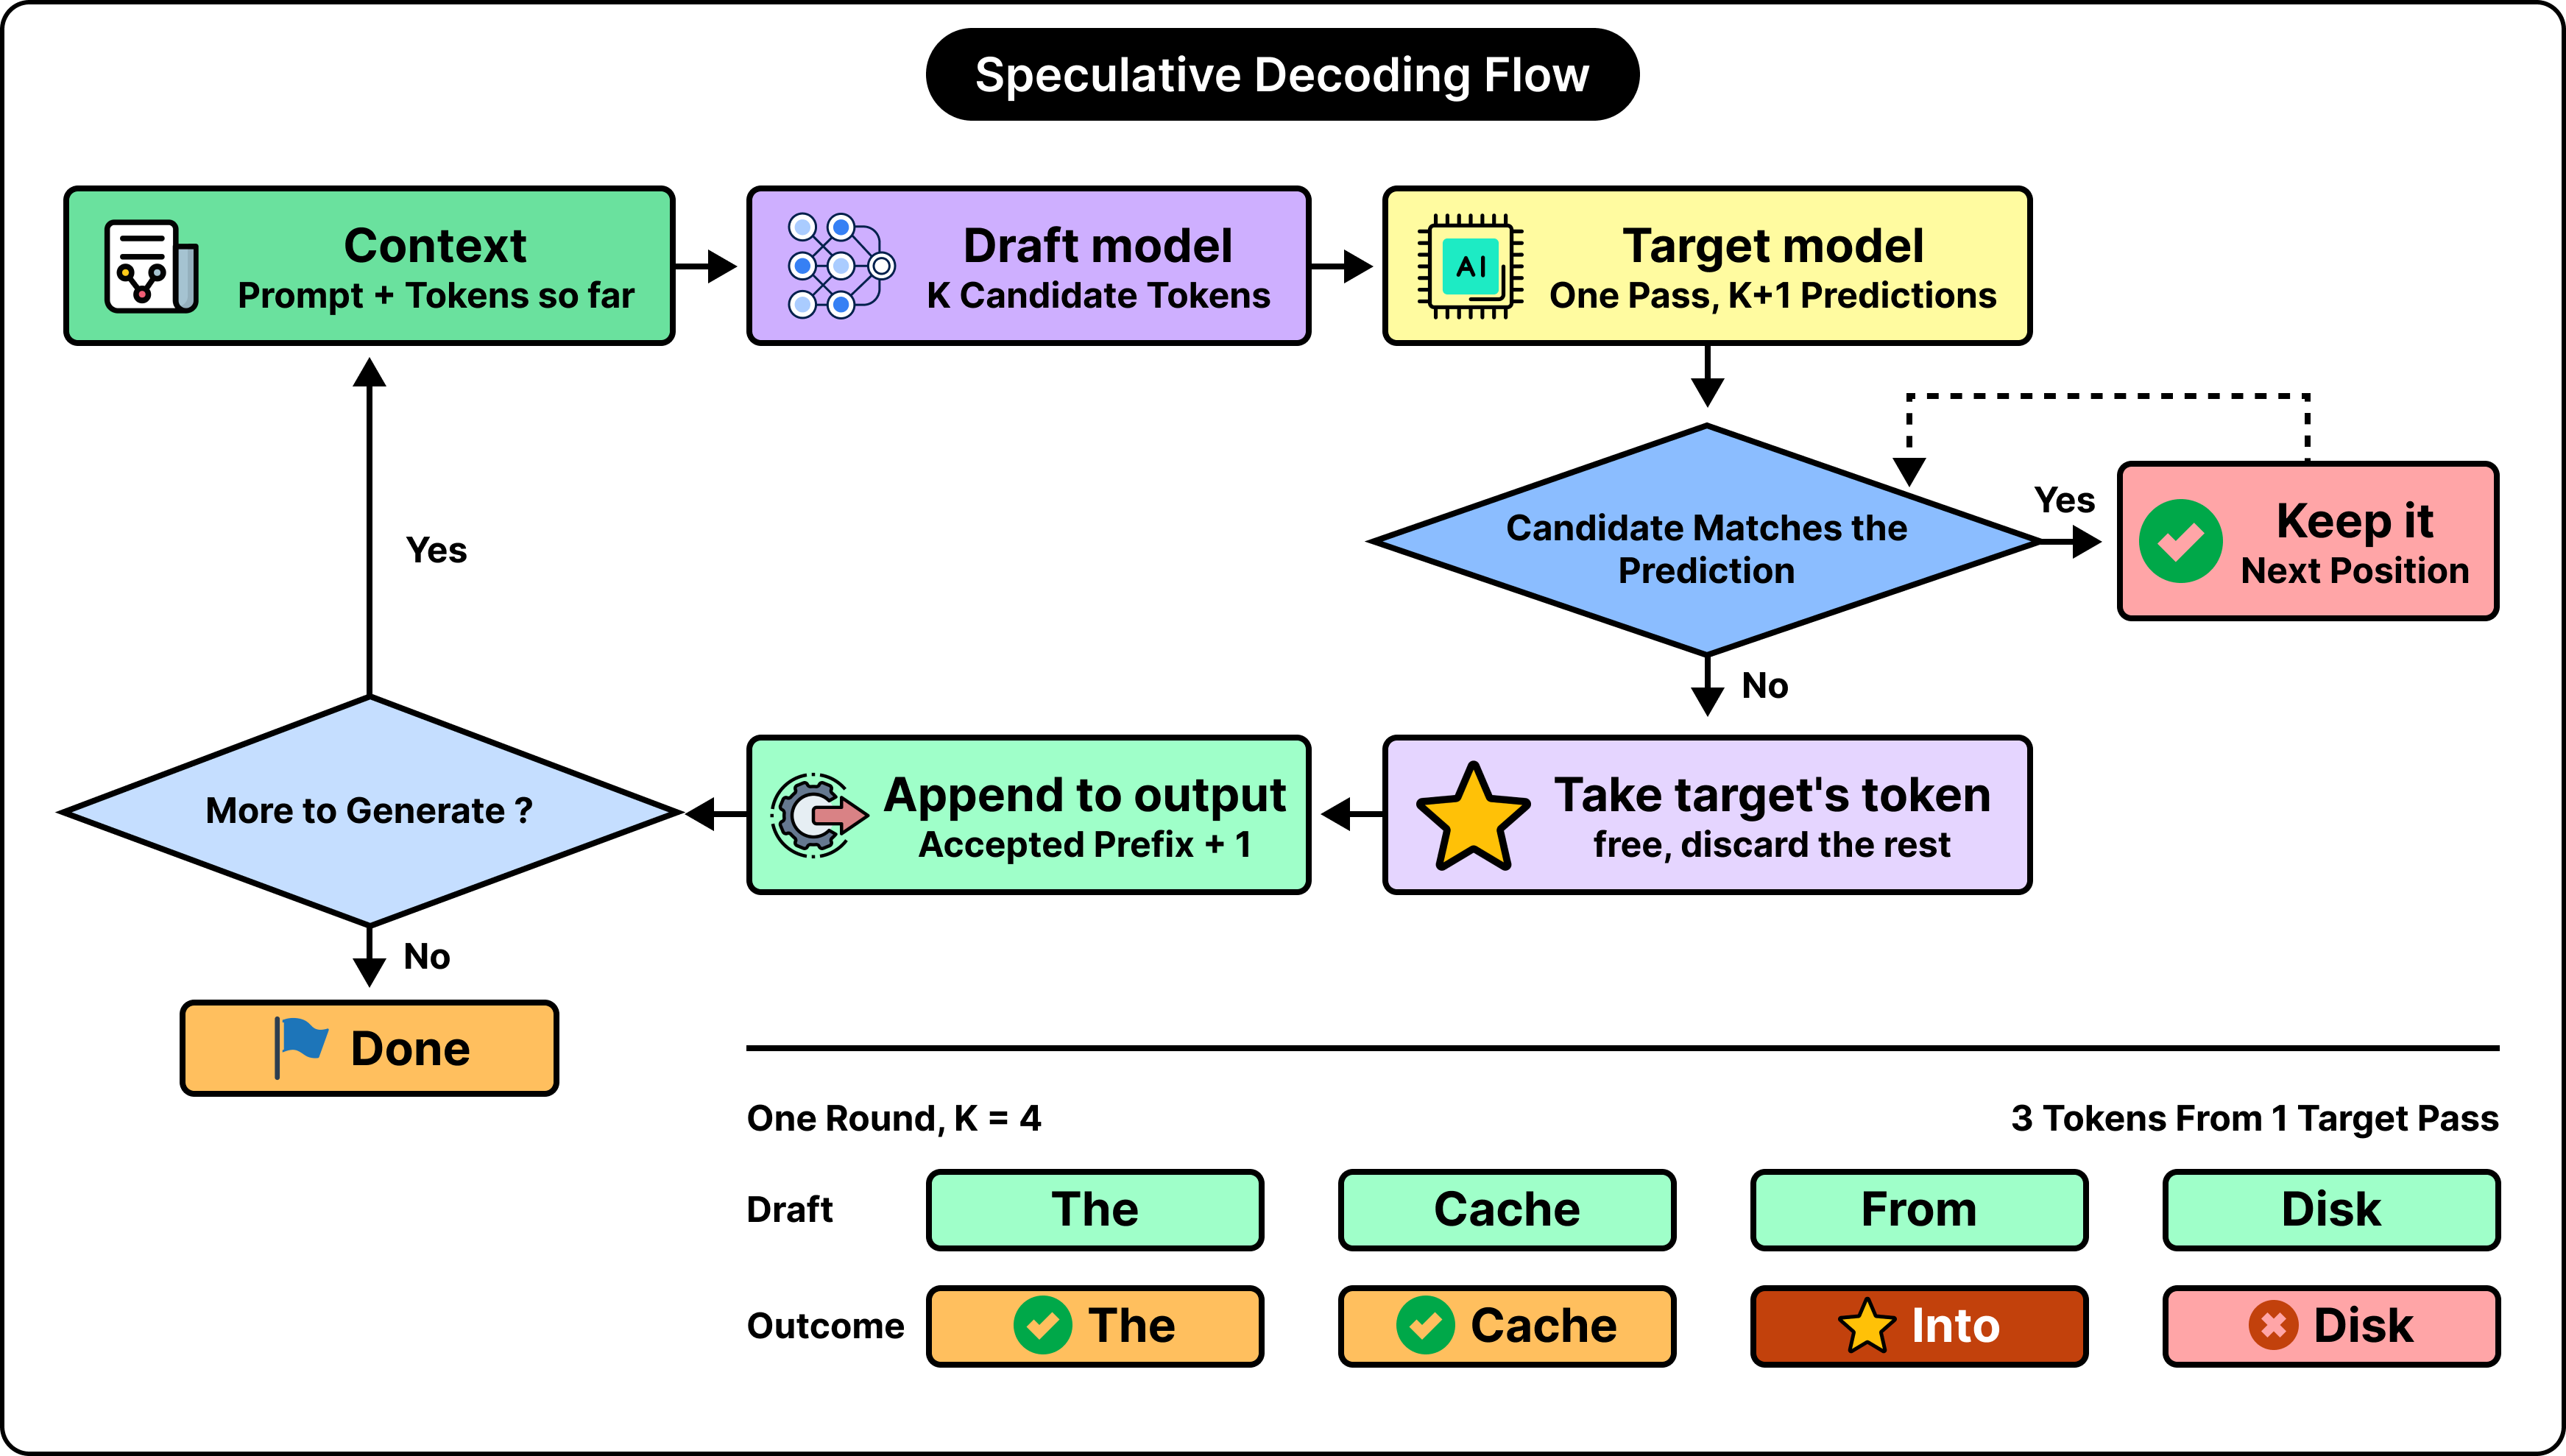
这里的关键不是 target model 少做了判断,而是把原来排成一列的判断,改成了一次读取权重、同时给多个位置打分。候选从左到右验收,前面匹配的留下;一旦遇到第一个不匹配,后面的候选全部丢掉,但 target model 在这个位置已经算出的 token 可以直接使用。
一轮输出因此可以写成:已接受的候选前缀 + 第一个不匹配位置的 target token。最坏时,猜测全错,仍然能拿到一个 target token;最好时,一次验证能带走一串 token。这解释了它为什么不至于因为“猜错”就完全白费,也解释了它为什么绝不是任何情况下都能加速。
“无损”也要读准。采样版本通过比较 draft 与 target 的概率,并在拒绝后从修正分布重采样,让最终分布仍由 target model 决定。Hugging Face 文档把这种标准 speculative decoding 视为 lossless,但同时提醒采样本身允许不同措辞;vLLM 的文档则进一步把浮点精度和 batch 数值稳定性列为现实边界。无损不是每次逐字一样,而是没有把 draft model 的偏好偷偷混进来。
小模型是提案者,大模型是裁决者
Section titled “小模型是提案者,大模型是裁决者”接受率决定了“猜测”能不能变成有效工作。代码、摘要、抽取和 RAG 往往有较强的结构,后续 token 更容易被小模型猜中;开放式写作和高温度采样的不确定性更高,接受率就会下降。K 常取 3–5,继续加长草稿并不一定更好,因为后面的候选已经建立在 draft 自己未经验证的输出上。
DeepSeek-V3 的技术报告给出了一个很有代表性的例子:第二个预测 token 的接受率约为 85%–90%,并带来约 1.8 倍的生成 TPS。这里更值得记住的,是训练和推理之间的连接:MTP 让模型在训练时就学会预测多个未来 token,推理时这些额外预测头可以承担草稿角色。
候选来源其实有四种。可以部署一个同系列的小模型;可以在 target checkpoint 里训练额外预测头;可以用量化、跳层或压缩 KV cache 的便宜版本来草拟;也可以直接在 prompt 和历史输出里搜索重复的 n-gram。它们没有改变同一个问题:用什么更便宜的预测,去填 target model 原本空着的时间。

这让我想起我在 《开权模型真正打开的是试错路径》 里写过的一点:开放权重的价值,除了让更多人“拥有一个模型”,也让人有机会把模型拆开,试验它的显存、缓存和预测头。推测解码正是这种系统层试错的例子。不过,小模型只负责提案,最终裁决仍在大模型手里;tokenizer、显存和训练控制权,都会把看似漂亮的方案框回现实。
“3 倍”要先问发生在哪种负载
Section titled ““3 倍”要先问发生在哪种负载”文章最值得警惕的地方,是它没有把 3 倍写成普遍承诺。推测解码花的是服务器原本没有分配出去的计算余量。单请求、低并发、memory-bound 时,这笔余量确实存在;并发请求一多,同一次权重读取已经服务了更多请求,计算单元开始饱和,额外的验证工作就要和真实请求抢资源。

原文引用的一项评估里,70B 模型在 batch size 1 时最高约 1.96x,batch size 128 时降到约 1.21x;再往上,推测可能跌破基线。vLLM 的最新文档也把 speculative decoding 放在中低 QPS、memory-bound 的场景里讨论,并提供动态调整推测深度的实现方向。换句话说,K 不该是一个写死的常数:接受率下降或并发上升时,就应该缩短 K,甚至关闭推测。
还有一个容易被宣传语遮住的边界:它主要改善的是生成中的 inter-token latency,首 token 延迟基本不变。长 prompt、短回答的任务,最慢的部分可能根本不在它负责的区间里。
如果要把它接进生产服务,我会先记录五个数:TTFT、inter-token latency、接受长度、整体吞吐,以及推测开始亏损的并发阈值。上线标准应当是一条能自动收缩的策略:负载升高时,K 变小,必要时归零。漂亮的加速倍数可以放在后面。
如果你要把推测解码接进现有服务,你会先看接受率,还是先看并发?为什么?