机器人开始在部署现场学习
训练结束以后,一个机器人还能不能继续学?
这个问题以前很容易被理解成:要不要继续 fine-tune,要不要做在线强化学习,要不要更新 policy 的参数。最近读到《In-Context Robot Learning with VLM Agents》,我觉得它把问题换了一个位置。
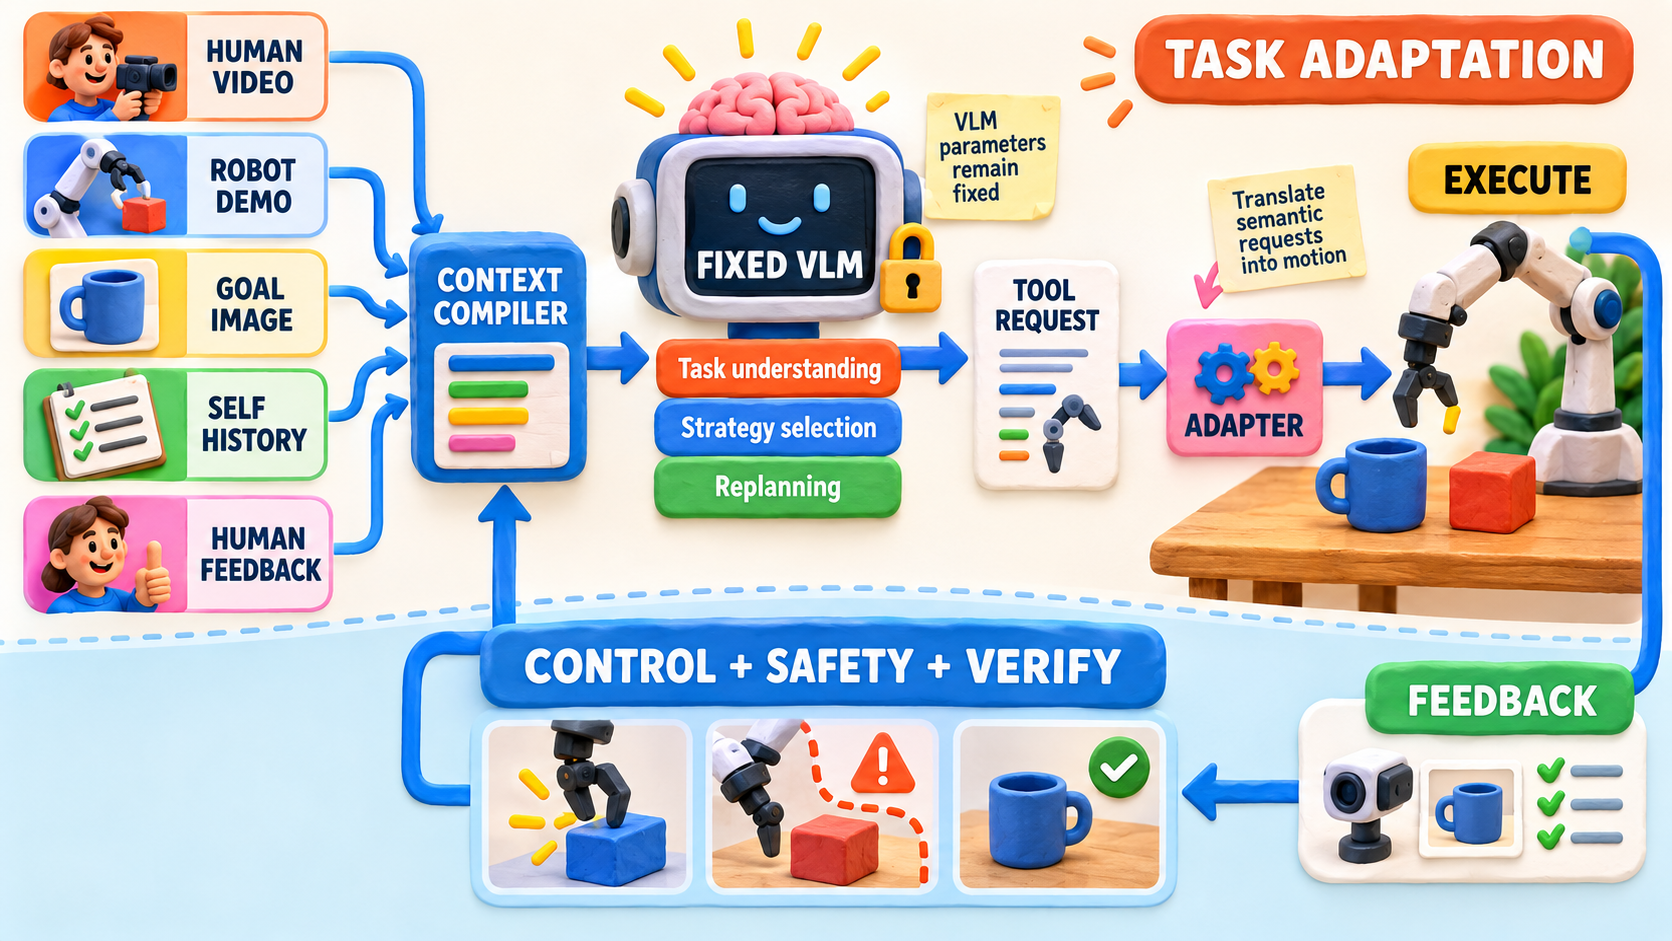
论文里的 GPT-Policy 没有在执行任务时更新 VLM 参数。研究者把人类示范视频、机器人示范、目标图片、机器人自己刚刚经历过的失败,以及人的即时反馈放进上下文,再让一个通用 VLM 通过结构化工具接口控制真实机器人。
换句话说,变化的不是模型权重,而是模型在这一刻能够看到的世界。
这让我更愿意把 in-context learning 理解成一种部署时学习接口:系统不必先把每个新任务重新训练进模型,很多适应可以先发生在 context、状态和反馈层。
我更在意的是论文后半截。它没有把故事停在“机器人会学了”,而是把失败也摆了出来:知道该做什么,和能够可靠地做到,并不是一回事。
五种上下文,其实是五种缺失信息
Section titled “五种上下文,其实是五种缺失信息”GPT-Policy 给机器人准备了五类 context:人类视频、机器人示范与动作、目标图片、自身交互历史,以及在线的人机交互。
如果只把它们看成五种 prompt,容易低估这件事。
人类视频回答的是“这件事大概按什么顺序发生”。机器人示范进一步告诉系统“这个身体当时怎样移动”。目标图片只规定终态,不规定过程。Self-interaction history 保存的是“我刚才试过什么、发生了什么”。人的指向和实时反馈,则会在任务进行中改变目标与规则。
这些信息原本散落在不同时间尺度里:示范发生在任务之前,目标图定义终点,机器人历史来自刚刚发生的动作,人类反馈甚至可能在执行中途出现。GPT-Policy 做的关键工作,是把它们编译成当前决策可以使用的 context。
论文里最干净的两组对照很能说明这一点。
在 Pick Red Towel 和 Pick Up Notebook 两个任务上,不给人类示范时都是 0/3;加入一段 human video 后,两项都变成 2/3。示范里没有机器人 action label,VLM 仍然需要根据自己的视角和当前机器人状态重新生成动作。
接触更敏感的任务里,信息粒度继续起作用。拧瓶盖任务从无示范的 0/3,到 robot video 的 2/3,再到 video + action reference 的 3/3;拔下并重新插回插头则是 0/3、0/3、2/3。论文还记录了瓶盖任务 13 个视频关键帧对应 205 个 action samples,插头任务 14 个关键帧对应 131 个 samples。
我从这组结果里读到的不是“context 越多越好”,而是另一件更具体的事:当前决策缺什么信息,就补什么信息。
只看视频,模型可以知道动作大意;但遇到接触、姿态和夹爪状态高度敏感的环节,稀疏画面中间发生了什么仍需要猜。时间对齐的 action reference 相当于把一部分猜测空间直接压掉。
学习没有只发生在模型里
Section titled “学习没有只发生在模型里”这和我以前写 《Not the Model, You’re the Harness》 时关注的东西接上了,只不过这一次,harness 从代码执行环境走进了物理世界。
GPT-Policy 的 VLM 并不是直接把一句“把毛巾拿起来”变成电机电流。中间还有完整的一层系统:context compiler 组织视觉和历史,tool schema 约束模型输出,adapter 把语义动作变成位姿和轨迹,IK 检查动作是否可执行,真实机器人执行后再把观察和结果送回下一轮决策。
所以“固定模型也能适应”并不神秘。模型参数没变,系统状态一直在变。
这点在 self-interaction history 上尤其明显。机器人过去的观察、动作、失败和结果继续留在 context 里,后面的决策因此不必假装自己刚刚开机。在论文的一个任务里,Agent 会先移开遮住目标的毛巾再寻找粉色盘子;在移动探索任务中,它也会根据先前观察继续找目标和绕开障碍。
这里的“记忆”不是档案功能,而是下一步动作的输入资格。这也正好呼应我在 《给 Agent 装记忆之前,先决定它该忘什么》 里的判断:保存历史没有意义,只有历史能以正确范围进入下一次决策,才算真正影响了 Agent。
机器人让这个问题变得更具体。文本 Agent 读到一条过时记忆,可能给出一个差答案;机器人读到错误状态,可能直接去抓一个已经不在那里的物体。
好计划,到了接触那一刻仍然会失效
Section titled “好计划,到了接触那一刻仍然会失效”如果文章只看到这里,很容易得到一个过度乐观的结论:以后通用 VLM 加一个机器人 harness 就够了。
论文自己把这个结论否掉了。
作者明确写道,当前 planner 不做 collision checking。他们在双臂操作里反复观察到两只机械臂发生碰撞,并直接承认现有 safeguard 不足以支持安全自主部署。
问题就在这里。VLM 可以从 human video 里理解“先抓这里,再拉那里”,却不知道接触瞬间物体有没有滑动;它可以生成一个看起来合理的末端位姿,却不能因此保证这条轨迹在真实机械结构上安全;它也可能宣布“任务完成”,而插头其实还没有完全插回去。
论文因此专门区分 model-declared completion 和 physical task success。软件 Agent 里的 verifier、tests、policy gate,到了机器人这里会变成传感器、碰撞检测、抓取稳定性、力反馈,以及对真实状态的再次确认。
物理世界没有“差不多通过”。
一个物体没有放稳,一个夹爪发生滑移,一条双臂轨迹在中间相交,都不是语言模型再想一遍就自动消失的问题。
我更看好分层,而不是让 VLM 接管低层动作
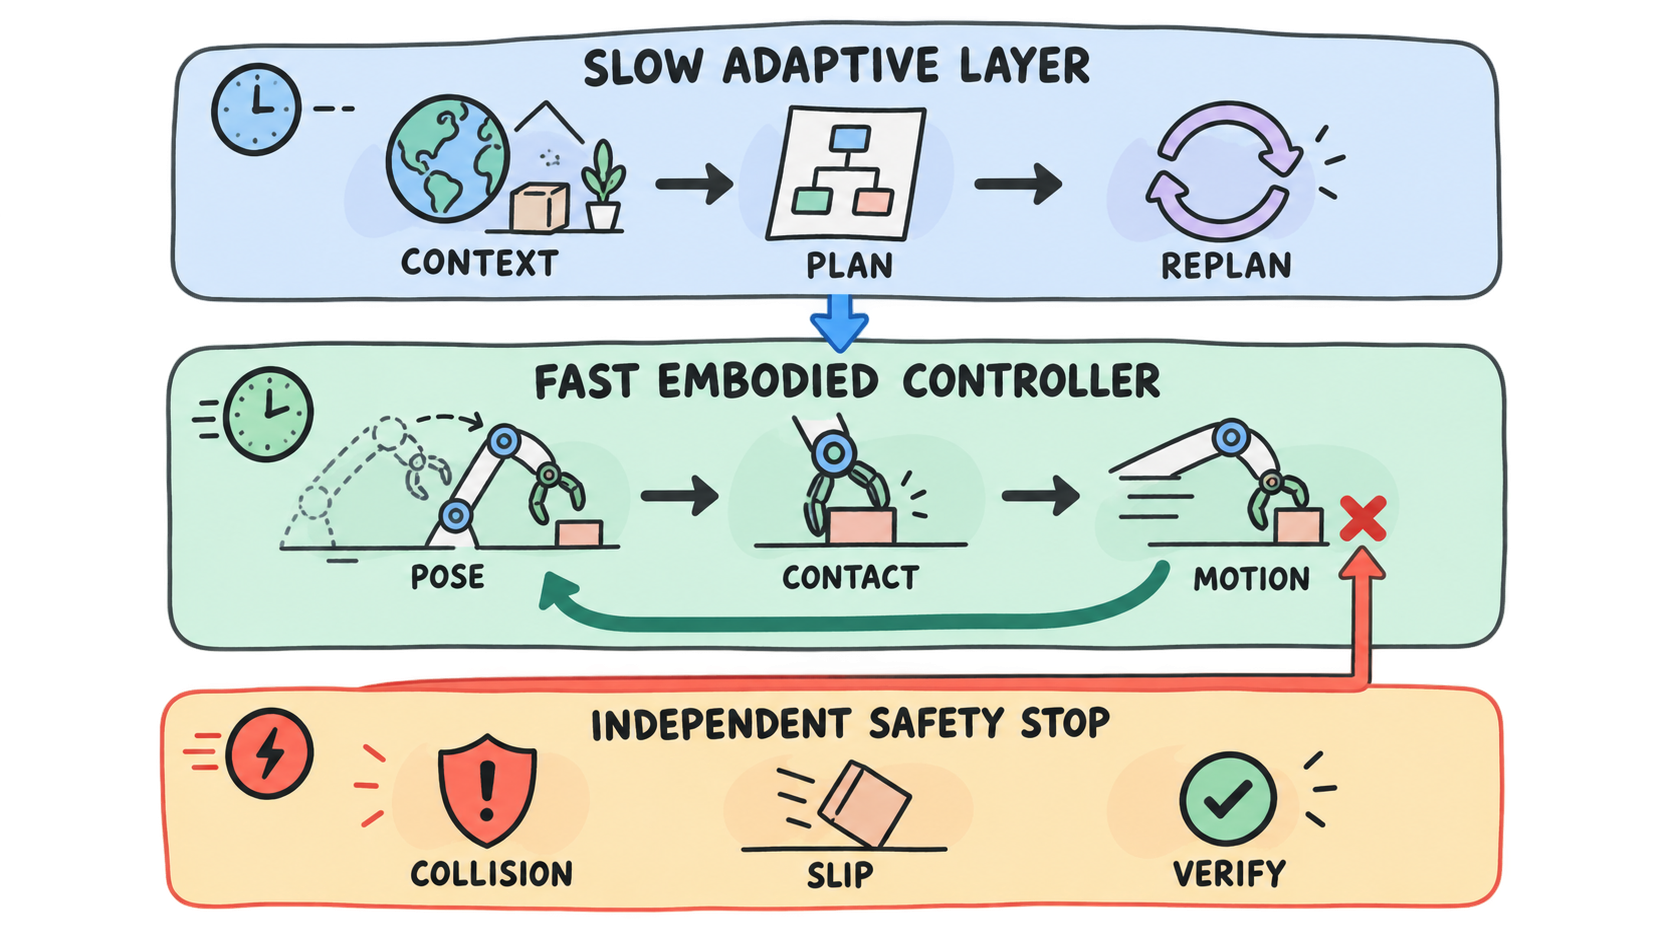
Section titled “我更看好分层,而不是让 VLM 接管低层动作”读完以后,我更倾向于把通用 VLM 放在一层慢速、善于读 context 的适应系统里。它适合从示范里理解程序,从目标图里理解终态,从历史里推断下一步,再根据人的反馈改计划。
但没有必要让它承担所有低层控制。
作者自己在 future directions 里提出了类似方向:用 deliberative System 2 agent 负责上下文推理,再配一个快速 System 1 controller,例如 VLA policy,处理 pose refinement 和双臂协调;接触层再增加 slip detection、force-aware limits 和 local recovery。
我认为这比“把机器人所有能力都训练进一个端到端模型”更值得认真观察。
原因不是模块化天然更高级,而是这些环节的反馈频率和失败代价根本不同。
理解一次示范,允许更慢一些。夹爪接触物体以后,控制回路却不能按同样的节奏等待。任务层可以容忍 VLM 重新规划,碰撞层则应该能够独立于 VLM 立即打断动作。
机器人把一个老问题重新摆到了台面上:不同时间尺度的问题,需要不同时间尺度的控制器。模型更强,并不会让这个约束消失。
Context 可能会成为一种新的“软件层”
Section titled “Context 可能会成为一种新的“软件层””RoboTTT、GEN-1.5、Show-Harness 和 GPT-Policy 放在一起看,会出现一条很有意思的研究线。
大家都在回答同一个问题:训练集不可能提前覆盖机器人未来遇到的每个任务,那么部署以后,系统怎样从眼前的新信息继续适应?
这里至少有几条路线。
RoboTTT 把长 context 压进 test-time fast weights;GEN-1.5 把 one-shot physical learning 做进专门的 embodied foundation model;Show-Harness 强调 semantic action interface;GPT-Policy 则把固定通用 VLM、异构 context、工具执行和闭环反馈拼成一个可实验的系统。
我暂时不关心哪条路线最后会赢。更值得跟踪的是,它们都在把部署时状态纳入系统能力。
未来我们评价一个机器人 Agent,可能不能只问“它训练过什么”,还要问:
它现在看到了什么示范? 保留了哪些历史? 哪些失败会写回下一轮? 谁负责确认动作真的成功? 哪些状态会过期? 什么情况下必须把控制权从通用 VLM 交给更快、更确定的系统?
这些问题听起来很像今天的 Agent harness engineering,只不过变量从文件、工具和 token,换成了摄像头、机械臂、接触和时间。
这篇论文最后留给我的,不是“机器人看一遍就会了”。更准确的说法是:训练结束后,policy 仍然可以通过 context 接受新的证据,并据此改变当前行为。
但判断变好了,不代表动作就可靠。接触控制、碰撞安全和结果验证仍要由完整的工程闭环承担。
到了机器人这里,harness 也不再只是模型外面的软件脚手架。它漏掉的每一个边界,最后都有可能变成一次真实动作。
- In-Context Robot Learning with VLM Agents
- GPT-Policy Project Page
- GPT-Policy GitHub
- Show-Harness: Just a VLM Agent Can Play Robots
- RoboTTT: Context Scaling for Robot Policies
- GEN-1.5: Embodied Foundation Models are One-Shot Learners
- In-Context Imitation Learning via Next-Token Prediction
- Not the Model, You’re the Harness
- 给 Agent 装记忆之前,先决定它该忘什么