给冰冻的世界装上外骨骼:Google EnvHarness 如何用“环境侧 Harness”破解 Agent 进化死局

1. 为什么“更聪明的 Agent”总是在同一个死板世界里撞墙?
Section titled “1. 为什么“更聪明的 Agent”总是在同一个死板世界里撞墙?”这两年大模型演进到智能体阶段,整个技术圈的重心都在发生一次根本性的迁移:从依赖海量静态文本的微调,转向让 Agent 在真实的交互环境中不断试错、总结技能甚至通过强化学习在线自我进化。
但在实际落地中,所有做 Agent 训练与评测的团队都会迅速撞上一堵坚硬的高墙——环境的静态困局(The Static Environment Dilemma)。
搭建一个高保真的真实评测环境极其昂贵。不管是软件工程领域的 SWE-bench、网页交互领域的 WebArena,还是具身环境 ALFWorld,背后都需要搭建复杂的 Docker 容器、拉起无头浏览器或配置沉重的物理模拟器。一个包含几百道真实任务的 Benchmark,光是保证环境能稳定复现和自动化评分,就要耗费顶尖工程团队数月的心血。
然而,这些千辛万苦建好的环境一旦落成,就变成了一潭冰冻的死水:
- 对弱点完全盲目:环境不管面对的是开源小模型还是顶配大模型,给出的初始状态和反馈规则永远一成不变。如果一个 Agent 的死穴是“在长上下文里容易迷航”或者“写完代码从来不跑测试就盲目提交”,静态环境根本不会针对性地设卡加练。
- 缺乏梯级成长空间:当 Agent 解决了当前固定任务集的 70% 后,剩下的 30% 成了无法逾越的顽疾,而已经解出的任务又失去了教学价值。环境无法根据 Agent 刚刚掌握的新能力动态增加难度。
在此之前,学术界和工业界尝试破局的主流思路是环境生成(Environment Generation)——比如通过 LLM 凭空合成新的代码 Issue、生成虚拟的网页或自动编写测试用例(如 SWE-smith、GenEnv 等)。
但这条路很快暴露出了致命的缺陷:为每个特定领域开发专用的生成管线极其脆弱;更要命的是,生成出的新任务缺乏不可动摇的人类真值(Ground Truth),只能依赖昂贵且经常产生幻觉的 LLM Verifier 来评分。其结果往往是 Agent 没有学到真正的解决问题能力,反而敏锐地捕获到了“生成环境或评测器本身的逻辑漏洞”,大搞 Reward Hacking。
正如同我们在《Agent 频繁撞墙,可能不是模型变蠢,而是接口在用“沉默”惩罚它》中讨论过的那样,环境与反馈的设计,直接决定了智能体能力的上限与下限。
Google Cloud AI Research 团队最近放出的重磅论文《EnvHarness: Awakening Static Worlds for Agent Learning》(arXiv:2608.19880),给出了一个极其清爽、甚至充满数学对称美感的新答案。

2. 完美的镜像对称:把 Agent Harness 搬到交互环的另一侧
Section titled “2. 完美的镜像对称:把 Agent Harness 搬到交互环的另一侧”要理解 EnvHarness 的绝妙之处,我们需要先回顾一下过去两年 AI 领域最成功的范式——Agent Harness。
我们在《Not the Model, You’re the Harness》中曾讨论过:Anthropic 和 OpenAI 并没有为了让 Claude 或 GPT-4 处理复杂工程任务而频繁改动底层模型权重。相反,他们选择冻结大模型(Frozen LLM),并在外层包裹一层由记忆(Memory)、技能库(Skills)、工具协议(Tools)和推理暂存区(Scratchpad)构成的 Agent Harness。通过外骨骼的组合,原本只会文本续写的模型瞬间获得了复杂的自主执行力。
Google 的研究团队发现:在 Agent 与环境的交互闭环里,既然我们可以冻结模型做外挂,为什么不能反过来,冻结环境并给环境做外挂?
这就是 EnvHarness(Environment Harness) 的核心思想。
它完全镜像了 Agent Harness 的设计哲学:
- 底层的基准环境保持 100% 冻结(Frozen Environment):SWE-bench 仓库里的代码、WebArena 里的真实网站、ALFWorld 的场景逻辑,乃至最核心的人类手写单元测试验证器(Ground-Truth Verifiers),一行代码都不改动。
- 外层包裹可编程的装饰器组件(Plug-in Decorator Components):通过拦截标准的交互接口(
reset、step、observe、evaluate),动态重塑环境的初始状态、交互动力学与任务空间。
这一对称设计带来了一个决定性的工程红利:无论外层的 EnvHarness 怎么变幻花样,最终评判任务成功与否的裁决者,依然是底层原汁原味、铁面无私的人类单元测试。
这从根本上杜绝了生成式环境里由 LLM 裁判带来的评分漂移与作弊漏洞,同时让同一套框架可以无缝运行在具身智能、网页浏览、代码修复、文档分析等截然不同的异构领域中。
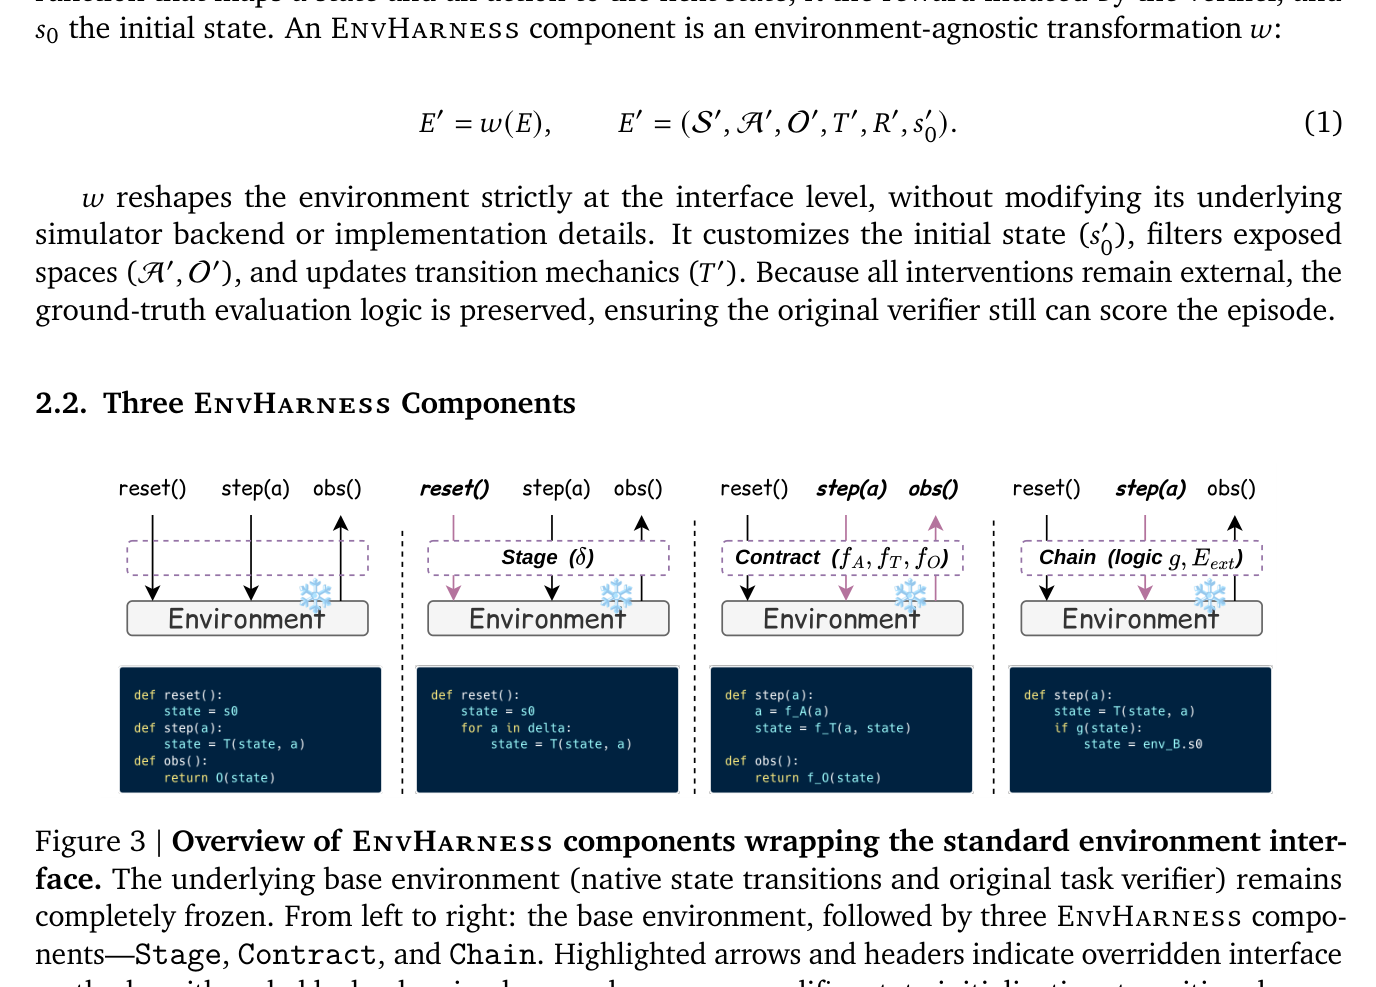
3. 三大正交积木:Setup、Rule 与 Link 是如何解构物理法则的?
Section titled “3. 三大正交积木:Setup、Rule 与 Link 是如何解构物理法则的?”在数学与软件架构上,EnvHarness 将环境的动态重构分解为三个正交的维度。这三大组件像乐高积木一样,全部遵循 Gymnasium-style 的抽象接口,可以任意叠加嵌套:
1. Setup(Stage):时间维度的起点重构
Section titled “1. Setup(Stage):时间维度的起点重构”在标准强化学习中,环境重置后会给出一个固定的初始状态 $s_0$。Setup 组件(记为 $w_{stage, \delta}$)拦截 reset() 调用,在底层环境完成原生重置后,自动在后台回放一段预设的动作序列 $\delta = (a_1, a_2, \dots, a_k)$,将初始状态推进到新的状态 $s’_0$。
这种设计的精妙之处在于**“天然可达(Reachable by Construction)”**。它不需要侵入底层数据库或修改模拟器内部变量,而是完全利用环境自身支持的合法动作来改变世界。
例如在 ALFWorld 的“把干净杯子放到桌上”任务中,默认状态下杯子就放在显眼处。Setup 可以自动执行“拿起杯子 -> 打开抽屉 -> 放入杯子 -> 关上抽屉”,在任务一开始就为 Agent 制造出“杯子被藏在抽屉里”的障碍,强迫它先展开空间探索,而不是直接伸手抓取。
2. Rule(Contract):动力学与感知的重写
Section titled “2. Rule(Contract):动力学与感知的重写”Rule 组件(记为 $w_{contract, r}$)拦截交互过程中的每一步 step() 和 observe(),通过三元映射组 $r = (f_A, f_T, f_O)$ 分别重塑动作空间、状态转移机制与观测反馈:
- 动作约束 $f_A$:屏蔽高层捷径命令。例如在模拟环境中禁用“直接传送到目标房间”的快捷操作,强迫 Agent 学习逐步导航;
- 状态转移干预 $f_T$:注入前置条件与真实工程约束。例如当检测到 Agent 试图提交代码 Patch 时,如果它在这之前没有执行过
pytest或runtests.py,Rule会直接拦截这次提交,并返回模拟的 Pre-commit Hook 报错:“githook: verify-tests failed. Run the test suite before submitting.”; - 感知扰动 $f_O$:截断冗余或过于直白的房间描述,强迫 Agent 在有限观测下依靠多步探索建立空间工作记忆。
3. Link(Chain):空间维度的长程拼接
Section titled “3. Link(Chain):空间维度的长程拼接”现实世界的复杂任务往往需要跨越多个子系统。Link 组件(记为 $w_{chain, \ell}$)将两个或多个独立的环境实例串联起来,只有当 Agent 连续完成了前序任务与后续任务时,整个复合环境才判定为成功。
例如在完成代码修复任务后,立即无缝拼接一个生成回归测试用例的任务。这种长程拼接极大地考验了 Agent 的目标持久性(Goal Persistence),避免模型陷入“局部任务一完成就提前停机”的短视行为。
在代码实现上,EnvHarness 采用了极其克制的 Decorator(装饰器)设计模式。基础抽象类 ActionableEnv 仅定义了 7 个核心方法,而 EnvHarness 本身既是一个 ActionableEnv,又持有一个内部的 inner 环境对象。
这意味着你可以像洋葱一样自由嵌套:
env = Rules(Setups(Link(BaseBenchBridge)))对于正在执行任务的 Agent 而言,它面对的始终是一个标准而纯粹的统一接口,完全感知不到底下究竟套了多少层装饰器。

4. EnvRigger:一个不知疲倦的“动态私教”与自适应难度黄金带
Section titled “4. EnvRigger:一个不知疲倦的“动态私教”与自适应难度黄金带”如果 EnvHarness 只是提供了一套环境组件的语法规范,那它充其量还只是一个供人类工程师编写测试用例的工具箱。让这套系统真正产生智能跃迁的,是其背后的自动化闭环驱动引擎——EnvRigger。
EnvRigger 将目标 Agent(Policy $\pi$)完全视为黑盒,通过四大阶段构成的自治循环,源源不断地为 Agent 量身定做“最适合它当前水平的训练关卡”:
- Observe(黑盒观察):在基准任务上收集目标 Agent 的大量 Rollout 执行轨迹。失败的轨迹暴露了能力的断崖,而成功的轨迹则标定了能力的舒适区;
- Diagnose(弱点诊断):LLM 诊断器系统分析失败轨迹中的根因——是陷入了重复无效命令的死循环?还是被过长的输出冲垮了上下文?抑或是存在“写完代码从来不验证”的不良习惯?
- Write(合成 Python 组件):针对诊断出的具体盲区,EnvRigger 直接合成可执行的 Python 代码(即具体的
_Rules或_Setups子类),为当前任务定制专属的 EnvHarness 装饰器; - Validate(闭环实测验证):将重塑后的新环境投入新的 Rollout 实测。EnvRigger 会严格监控 Agent 在新环境中的成功率,并将其锚定在 $[0.4, 0.6]$ 的最佳学习难度区间(Target Difficulty Band)。
如果新环境太难导致 Agent 彻底崩溃,或者太简单直接秒过,候选组件会被驳回并触发反思重写;只有当环境恰好卡在 Agent 的“最近发展区(Zone of Proximal Development)”时,该组件才会被正式收录。
更关键的是,随着 Agent 通过这些定制环境提炼出新技能(例如借助 Google 的 ReasoningBank 架构存入长期技能库),Agent 本身的能力边界被推高了。此时,EnvRigger 会自动发起下一轮诊断,识别出更深层的软肋并生成更严苛的环境。
这种策略与环境的双向螺旋演进(Co-evolution),彻底打破了以往“环境固定、模型单向刷题”的死板局面。

5. 跨模型跃迁与 RL 终局:环境 Scaling 到底能走多远?
Section titled “5. 跨模型跃迁与 RL 终局:环境 Scaling 到底能走多远?”论文给出的实验数据非常扎实,全面覆盖了从具身操控(ALFWorld)、真实网页操作(WebArena)、软件工程(SWE-bench Verified)到办公自动化(OfficeQA、SpreadsheetBench)五大硬核场景:
1. 泛化表现与执行效率双重突破
Section titled “1. 泛化表现与执行效率双重突破”在所有五个基准测试中,从 EnvHarness 环境中提炼技能的 Agent,全面击败了“无技能基线”以及“从原始静态环境中提炼技能”的对照组:
- 在未见过的测试集(Held-out instances)上,最高取得了 +9.0% 的绝对成功率提升;
- 在解决相同任务时,Agent 的交互步数减少了约 9.8%(例如在 SWE-bench Verified 上,平均步数从 55.01 步显著压降至 49.61 步)。这意味着 Agent 不仅成功率更高,而且行动更加精准干脆,摆脱了大量无意义的试探动作。
2. 跨模型底座的惊人普适性
Section titled “2. 跨模型底座的惊人普适性”EnvHarness 并不依赖特定专有大模型的能力红利。研究团队在 SWE-bench Verified 上测试了跨度极大的四种模型底座:
- 开源小模型 Qwen3.6-27B:成功率相对提升 +7.6%;
- 紧凑型商用模型 Gemini 3.1 Flash-Lite:相对提升 +8.7%;
- 前沿旗舰模型 Gemini 3.5 Flash 与 Claude 3.5 Sonnet / 4.6:分别稳定提升 +5.4% 与 +4.6%。
无论模型底层能力是 30 分还是 70 分,EnvRigger 都能精准咬住该模型当下的薄弱点,提供匹配其维度的强化训练。
3. 环境 Scaling 的质变拐点
Section titled “3. 环境 Scaling 的质变拐点”在环境规模扩展实验(Figure 5)中,研究团队对比了三种环境供给策略在相同计算预算下的表现:
- 使用原始静态环境(SWE-Lite),随着题目数量从 50 道增加到 300 道,性能很快在 52.13% 附近停滞;
- 使用生成式合成环境(SWE-smith),由于缺乏高质量的人类真实验证器,最终成绩仅为 50.37%;
- 而 EnvHarness 随着环境数量的增加,成功率从 47.67% 一路陡峭爬升至 54.79%,在 300 个环境处依然保持着强劲的上升斜率。
这直接证明:盲目增加无针对性的静态题目,收益递减极快;只有根据学习者动态生成的针对性环境,才能维持高斜率的 Scaling Law。
4. 在线强化学习(RL)的高信噪比优化信号
Section titled “4. 在线强化学习(RL)的高信噪比优化信号”尤为值得关注的是论文中的在线强化学习实验(Table 4)。当研究团队使用 GRPO 算法(基于 verl-agent 框架)直接在 EnvHarness 环境中进行在线策略训练时,Agent 在 ALFWorld 上的成功率从 81.4% 跃升至 87.9%,在 WebShop 上的得分从 75.6 提升至 79.2。
这表明 EnvHarness 生成的动态环境不仅仅是一种“数据增强手段”,它本身就是一种极其纯净、高信噪比的独立强化学习优化信号源。
6. 静态 Benchmark 刷榜已死:可编程训练场才是分水岭
Section titled “6. 静态 Benchmark 刷榜已死:可编程训练场才是分水岭”读完 EnvHarness 这篇论文,最强烈的感受是:软件工程里历经几十年检验的架构智慧,在 AI Agent 时代依然拥有降维打击般的力量。
过去一年多,整个行业陷入了一种奇特的“不对称执念”:我们乐此不疲地为大模型设计各种复杂的 Plan-and-Solve、ReAct、Reflection 循环,给它挂载数十个 MCP 工具,却理所当然地把环境当成一个被动接受指令的死物。当 Agent 表现不佳时,所有人第一反应都是“模型上下文不够长”、“Prompt 没写好”或者“微调数据不够多”。
Google 的这项工作用极其克制的工程实践提醒了我们:环境不该是沉默的受体,而应当是有机闭环中的自适应反馈源。
通过一个简单的 Python Decorator 抽象,EnvHarness 既保全了人类真实评测基准不可动摇的公信力,又赋予了静态世界随 Agent 弱点实时变形的能力。它不再试图在真空中凭空捏造一个破绽百出的虚拟世界,而是在现实世界的入口处,为 Agent 搭建了一座自适应的“全息重力训练室”。
当静态 Benchmark 的分数越来越容易被各种微调技巧刷爆,未来的 Agent 核心竞争力,必然取决于谁能拥有更懂自己弱点、能不知疲倦地设计极限关卡的可编程环境体系。
你在构建或训练 Agent 时,是否也曾遇到过“在固定测试集上刷高分、上线实战却频繁被边缘场景击穿”的困境?你认为给环境套上可编程的装饰器,未来会在哪些复杂业务场景(如金融风控、CI/CD 自动化)中最先爆发出威力?欢迎在评论区分享你的实战观察与思考。
- Not the Model, You’re the Harness
- Agent 频繁撞墙,可能不是模型变蠢,而是接口在用“沉默”惩罚它
- Anthropic 这篇长跑 Agent harness 文章,讲透了交接制度
- 1.5 万 Stars 背后:Google 揭秘 Agent Skills 的工业化构建与治理真相
- SWE-smith: Scaling Software Engineering Agent Evaluation (arXiv:2410.06992)
- VeriEnv: Verified Environment Synthesis for Autonomous Agents (arXiv:2407.08740)
- EnvHarness: Awakening Static Worlds for Agent Learning (arXiv:2608.19880)
- EnvHarness Official Website
- Google Research EnvHarness GitHub Repository
- ReasoningBank: Long-term Skill Memory for Agents
- SWE-bench: Can Language Models Resolve Real-World GitHub Issues?
- WebArena: A Realistic Web Environment for Building Autonomous Agents