Agent 规模化后,最贵的不是模型

我读完 Uber 的 《Running a Software Factory Efficiently at Uber Scale》 后,最先想划掉的其实是“cost”这个词。它太容易把问题带到采购谈判上:哪家模型便宜一点,哪种套餐划算一点,哪个 API 的输入价格低一点。
但文章真正让我停下来的地方,恰恰是另一种增长同时发生了:2026 年 2 月到 8 月,Uber 统计的周活用户增长 7 倍,周 Agent 请求增长 9.4 倍;在固定模型的口径下,每 1,000 次请求的成本较峰值下降近 34%,每个 session 的成本较 6 月峰值下降 52%。这不是“模型突然变便宜”的故事,而是一个系统在学着少做无效工作。
我把这篇文章读成了一次视角转换:当 Agent 从个人工具变成组织里的生产单元,优化对象就不再是某个模型,而是从任务进入到结果交付之间的整条回路。
先把“贵”拆开,再谈降价
Section titled “先把“贵”拆开,再谈降价”Uber 没有从“我们换了什么模型”开始,而是先画了一本账:
总支出 = 用户数 × 每用户 session 数 × 每 session turns 数 × 每 turn requests 数 × 每 request tokens 数 × 每 token 价格
这个式子最有用的地方不是乘法本身,而是它把“贵”拆成了不同责任人的问题。用户数和使用强度增长,可能是产品成功;turns 太多,可能是 Agent 没有及时收敛;requests 太多,可能是工具协议让模型不停轮询;tokens 太多,可能是历史、schema 和中间结果被反复搬运;最后才是 token 单价。

原文的两个数字因此要一起看。7 倍用户和 9.4 倍请求是“更多人、更多使用”,不是效率下降;34% 和 52% 则是在问:同样的模型和工作负载,系统有没有少走弯路。把增长端和收缩端放在同一张账里,才不会把“使用越多”误读成“系统越浪费”。

我会把这套账再翻译得直白一点:Agent 的成本,不是它说了多少话,而是它为了交付一个结果,重复做了多少不必要的事。
这也给“单位成本”加了一个前提。对于代码评审,应该看每次有效评审的成本;对于告警处理,应该看每个被正确分流告警的成本;对于合并 PR,应该看每个合格结果的成本。如果只看每百万 token 价格,很容易把更便宜但更会返工的系统误判成效率更高。
便宜模型只是成本方程的最后一格
Section titled “便宜模型只是成本方程的最后一格”Uber 当然也在换模型,但它没有把模型选择变成“最强模型”和“最便宜模型”的二选一。它为 uReview 用真实 PR 构造 benchmark,给已知缺陷分难度,同时看 precision、recall、F1、每次评审成本、延迟、超时和噪声,再把不同配置放到同一张成本–质量图上。

这里的 Pareto 前沿不是一个漂亮的数学名词,而是一条很实际的纪律:如果某个配置更贵、质量还更差,就没有理由继续运行它;如果一个更便宜的模型在这类任务上质量足够,就应该让它接手。模型前沿还会移动,所以路由也不能一次定终身。
这和我之前写 《Loop Engineering:Agent 真正的战场不是 prompt,而是回路》 时留下的判断有一个交接点,但 Uber 把它推进到了账单一侧:回路不仅决定 Agent 能不能完成任务,也决定它为完成任务支付多少中间成本。
更值得注意的是 subagent 的默认模型。主模型负责拆解和评估,子任务往往有清晰输入和局部目标,不需要每次都调用最高能力的模型。于是“便宜模型”不是全局降级,而是被放到适合它的工作位置上。
这套方法的边界也很清楚:没有真实工作 benchmark,就没有资格谈 Pareto;没有质量、可靠性和人工返工指标,所谓降本可能只是把成本转移到用户身上。模型价格是可以查到的,完成任务的代价却必须自己测出来。
真正的浪费发生在模型之外
Section titled “真正的浪费发生在模型之外”文章里最扎实的部分,在我看来不是换模型,而是清理模型周围的运行环境。
每一轮都会重新携带对话历史、项目上下文和工具结果。Uber 接入超过 1,000 个内部及 SaaS MCP 后发现,工具越多,越不能把所有 schema 直接塞进每个 session;仅有 100 多个工具的预加载,就可能带来约 50K–70K token 的初始开销。工具 search 和 CLI 动态解析的思路,本质上是把“说明书”从常驻物变成按需取用的索引。

Code-mode 则把另一种浪费移出了模型上下文。普通 MCP 调用里,模型提交查询、拿到 run id、轮询状态、重新取结果;每一次中间响应都可能成为下一轮输入。Uber 的做法是让脚本在模型之外完成提交和轮询,最后只把摘要交回来。
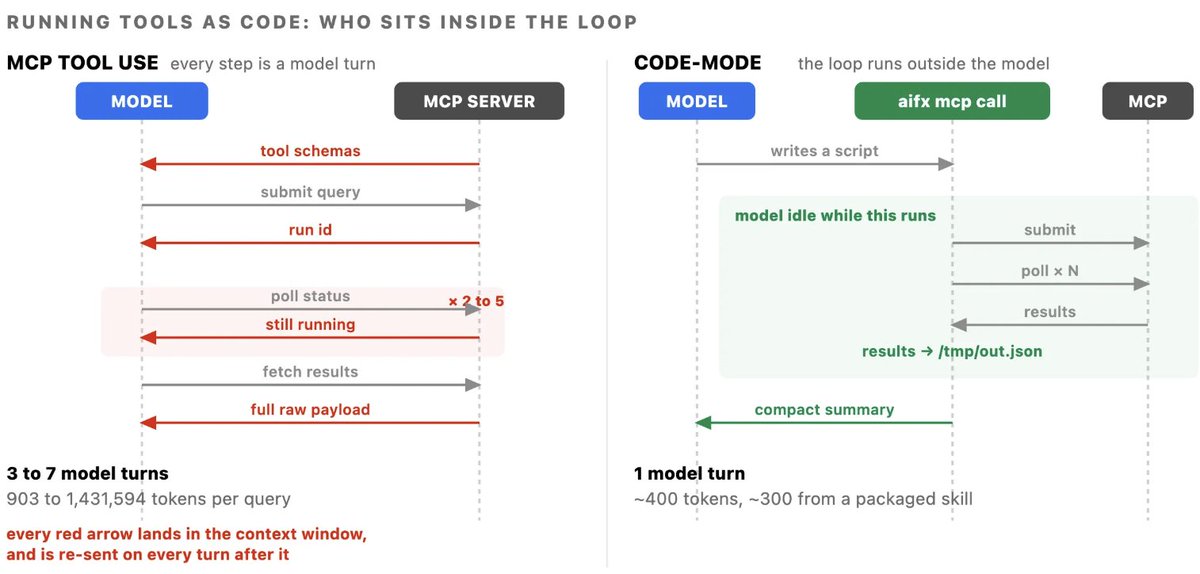
原文的 SQL 对照很能说明问题:几种小查询的 token 节省已经达到约 55%–71%;宽表查询则从 1,431,594 token 降到了 900 token。这里并不是把大结果偷偷藏起来,而是让轮询、schema 初始化和中间推理不要占用模型的工作区。批量工作流的累计节省超过 90%,也是同一个原因:原本需要 N 次模型参与的循环,被脚本收成了一次。
这让我想起 《Subagent 不是运行加速器,而是主控 Working Memory 的防火墙》 里讨论的上下文隔离。两篇文章谈的是不同场景,指向的却是同一件事:模型上下文不是免费的仓库,而是有限的工作内存。 把无关的中间过程留在外面,往往比再买一个更大的窗口更有效。
Context Graph 又把问题往前推了一步。工具变瘦,只能减少搬运;如果 Agent 根本不知道该去哪里找,还是会在代码、表和历史记录之间反复搜索。Uber 的图谱把服务、团队、事故、PR、设计文档、部署、数据集和历史查询连接起来。相同问题下,有图谱的 Agent 用 38 秒找到正确答案;没有图谱的 Agent 花了 20 分钟 9 秒,调用 3 次错误和 2 个 subagent 后仍给出错误结论。

“给模型更多上下文”在这里显然不是答案。更好的答案是给它更好的导航。Context Graph 的成本、维护和权限治理当然也不小,但这个例子至少把一个常见误区照亮了:Agent 变慢,未必是推理不够深,可能只是它在错误的地方找了太久。
软件工厂的最小版本,不需要 3,600 个 Skill
Section titled “软件工厂的最小版本,不需要 3,600 个 Skill”文章最后让我最愿意带回日常的,不是 Uber 的规模,而是它对可见性的处理。状态栏直接显示 session 的实时成本,dashboard 再去解释钱花在了哪里、哪些上下文反复出现、哪些 cache 已经失效。它们不是为了把工程师变成“省钱打字员”,而是让成本变成下一轮动作的反馈。

如果把这套方法缩小到一个普通团队,我会先给一个重复性、结果可验证的任务建六项最小记录:
- 每个 session 的总成本和完成时间;
- turns、tool requests 以及失败重试次数;
- 输入、输出和缓存命中 token;
- 结果质量,例如 F1、回滚率、人工返工率或 MTTR;
- 每个有效结果的成本,而不是每个请求的成本;
- 需要人工接管、审批或重新打开的比例。
先用真实历史任务做一个小 benchmark,再让两个模型或两种工具路径跑同一批任务。这样即使没有统一 gateway,也能回答三个问题:哪一步在浪费,省下的是否是真浪费,质量是否仍在可接受范围内。
我对“Software Factory”这个词的重新理解是:它不是把 3,600 个 Skill 堆成一座更大的自动化仓库,而是把任务、路径、结果和反馈接成一条能持续修正的生产线。托管 Agent 只是这条线的一个形态;在任务边界还不清楚、结果无法快速验收的探索性工作里,保留交互自由反而更合理。
所以,Uber 的经验真正可迁移的不是某个数字,而是一种顺序:先定义结果,再测量路径;先让质量可验证,再谈模型路由;先把浪费暴露出来,再把它写进默认配置。下一阶段的竞争单位,很可能不再是“谁拥有最强模型”,而是“谁能以可审计的成本稳定交付一个合格结果”。
如果你正在把 Agent 接入真实工作流,你现在最想先量化哪一项:上下文、工具轮询、模型路由,还是人工返工?