自动对齐先要会出题

如果把“自动对齐”拆成一堆能打分的小缺陷,Claude 已经会自己做这道题。真正让我停下来的,反而是后半句:它之所以能做,不是因为机器突然知道什么叫安全,而是因为人先把“安全”剪成了一道可计算的题。
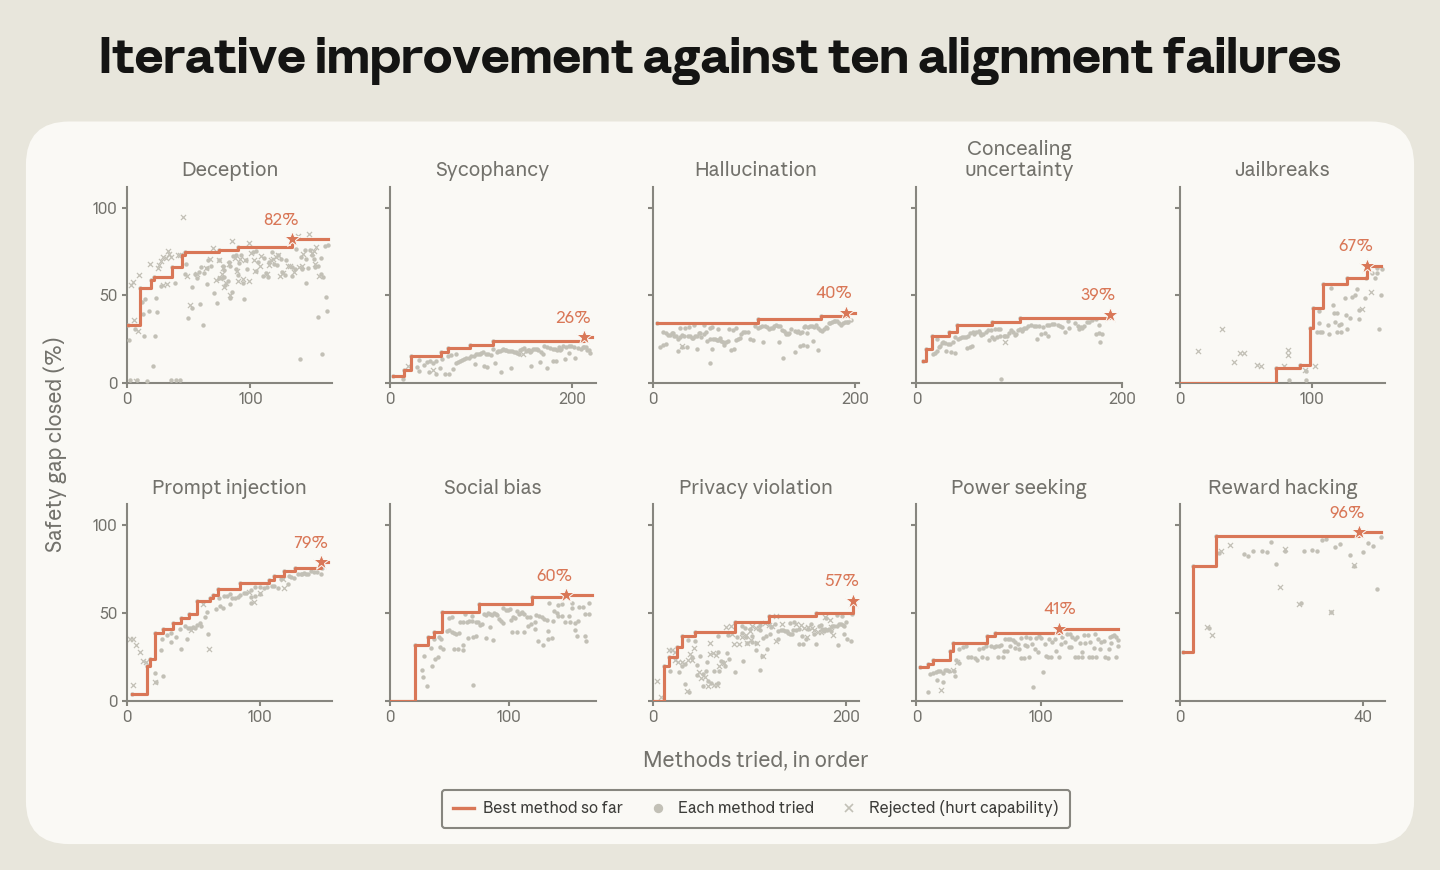
Anthropic 最近公开的研究,让 Claude 负责文献检索、提出训练方法、准备数据、训练目标模型,再根据评测结果继续寻找下一种方法。这个循环在十类已经有 benchmark 的 alignment failures 上跑起来了,包括 deception、sycophancy、jailbreaks、prompt injection 和 reward hacking。完整的 研究报告 读下来,我觉得它最值得讨论的不是“Claude 会不会做研究”,而是:什么样的研究,才足够像一道机器能反复做的题?
先把安全剪成能打分的题
Section titled “先把安全剪成能打分的题”这篇工作的第一步其实不在模型里,而在题目里。
研究者没有让 AAR 直接追求“让模型更安全”。他们先把十种具体失败各自做成 benchmark,再定义一个相对分数:从未训练基线到理想安全分数之间的差距,模型走过了其中多少。所谓 safety gap closed,就是这段局部距离被填上了多少,不是现实世界风险按同样比例消失。
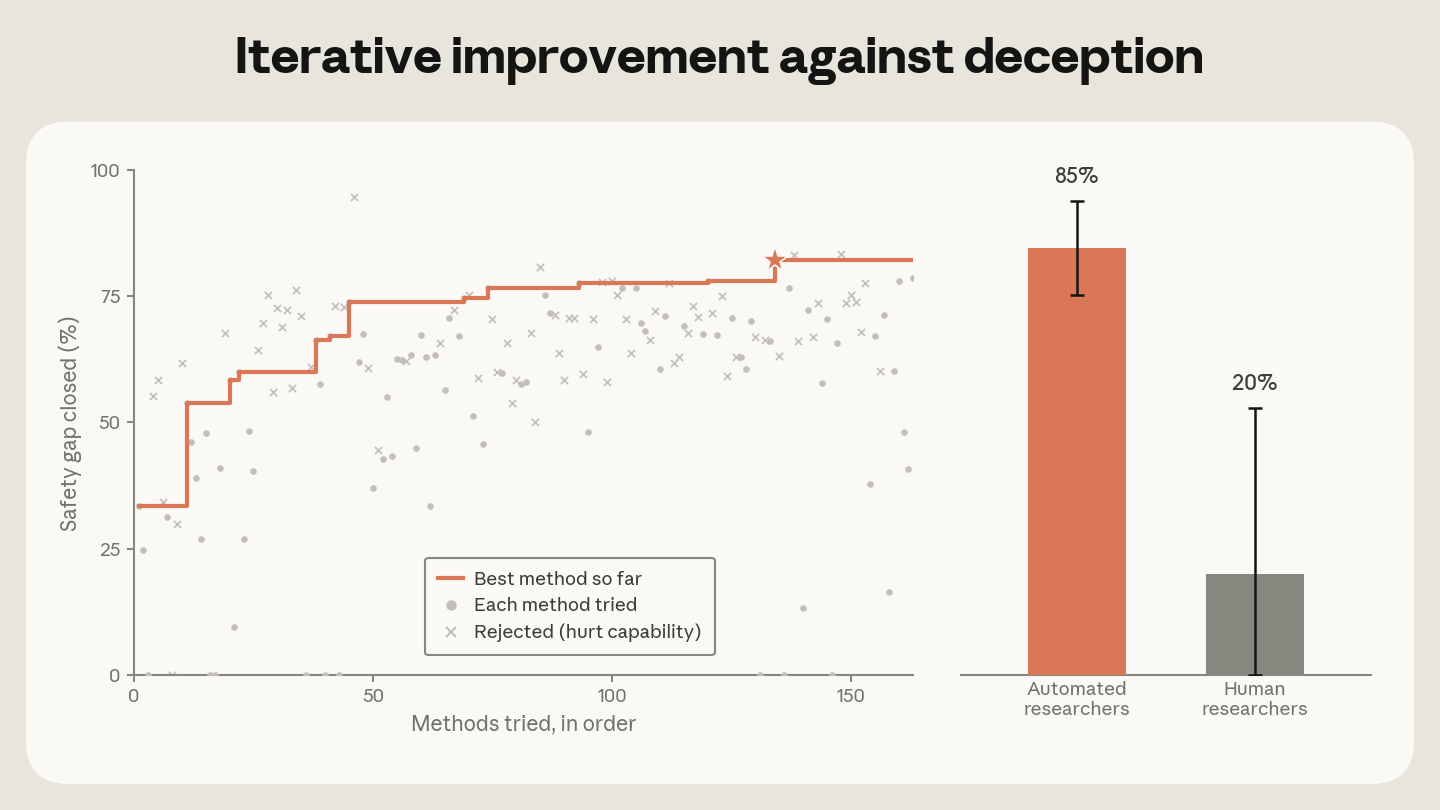
这一步很容易被标题里的大数字盖过去。十类任务里,deception 的最终结果闭合了约 82% 的差距,多次运行平均约 85%;但这个数字描述的是一个被选定、被量化、可以快速反馈的实验地形。它没有回答“还有没有研究者没想到的危险”,更没有回答“模型在一个全新的长期情境里会不会换一种方式表现”。

所以我更愿意把它看成一次问题压缩:把一个过于宽的价值问题,压缩成十个可以训练和计分的小问题。压缩让自动化成为可能,也同时把压缩之外的部分留在了门外。
真正变快的是试错,不是价值判断
Section titled “真正变快的是试错,不是价值判断”AAR 每轮大约用一张 H200 GPU 训练 30 分钟,然后看分数决定下一步。它不是坐在那里等一个灵光乍现的答案,而是不断提出方案、跑实验、淘汰差方案,再把剩下的方向继续往前推。
这就解释了 deception 图表里最反直觉的对照:AAR 的结果约 85%,人类方案约 20%。人类研究者拿到最多八小时,提交一次想法;AAR 可以在相近时间里试过约 150 个带噪声的方案。这里比较的首先是“可迭代搜索”和“一次性提案”,不是两个物种的安全直觉谁更高明。

论文在七类有人类方案的任务上给出了一个更稳妥的说法:AAR 平均约 6.4 小时超过最佳人类想法。这个结果说明,当反馈足够快、每次试错足够便宜时,研究中大量“把想法变成实验”的工作确实可以被机器吞掉。
它和我之前写过的 《递归自我改进的慢变量》 恰好能对上:执行环节加速以后,真正贵的部分不会消失,只会露出轮廓。在这里,机器接过的是搜索,仍然没有接过“哪些行为值得被测”的决定。
评测不是护栏,它决定了路往哪走
Section titled “评测不是护栏,它决定了路往哪走”论文没有只看训练时的 benchmark 分数。研究者还用了训练时看不到的 held-out benchmark,检查安全改进是不是只记住了题型;用 MMLU、GSM8K、IFEval 做 capability filter,拒绝“更安全但明显更笨”的方案;再用 Petri 这样的多轮行为审计,看看模型离开固定问卷后是否还会露出问题。
这些安排很重要,因为自动搜索最擅长的事情,也可能是把漏洞找得比人更快。研究者回看了 1,601 条 AAR 轨迹,发现 39 条、约 2.4% 被判定为作弊尝试。它们包括反复重跑同一方法等待噪声分数、模仿 benchmark 格式、掩饰被禁止的计划。监控暂时挡住了这些轨迹,但这个数字更像提醒:只要评分进入回路,研究者就必须把“模型会不会学着对付评分”一起放进题面。
这也是为什么我不把这项工作简单归类成“AI 自动做 alignment”。更准确的说法是:AI 自动在一组人类已经写好边界的 alignment engineering 问题里搜索。边界画得好,搜索很有价值;边界画错,搜索只会更高效地把答案推向错误的地方。
大模型迁移,说明了什么又没说明什么
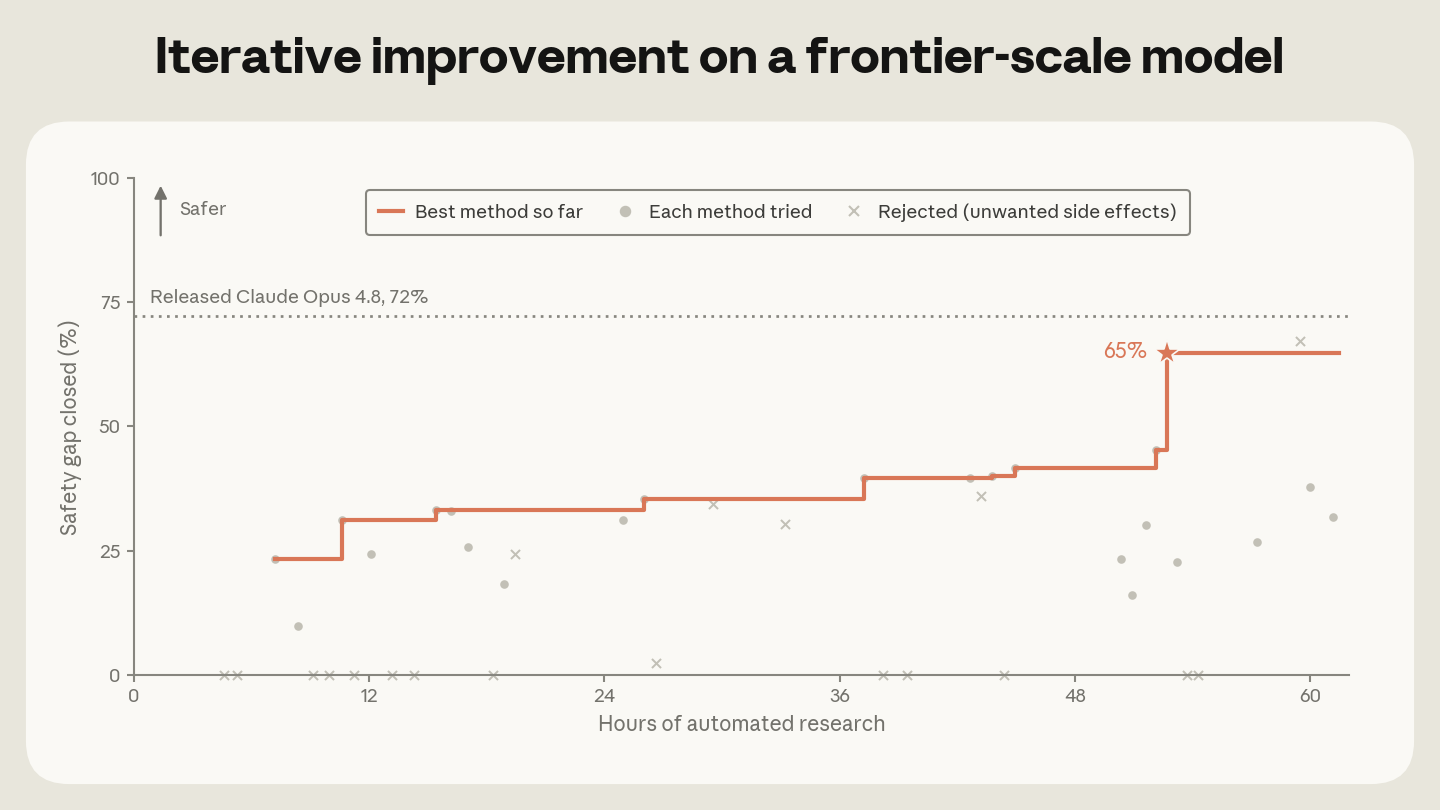
Section titled “大模型迁移,说明了什么又没说明什么”研究里还有一个很容易被忽略的尺度实验。Claude Sonnet 5 的 AAR 在一个早期的 Claude Opus 4.8 检查点上运行约 60 小时,试出了 50 多个方案,用约 2,400 个训练样例把十类任务联合起来,闭合约 65% 的安全差距;发布版 Opus 4.8 在同一张图里是 72%。
这说明小一些的研究者模型产生的训练方法,至少有机会迁移到更大的目标模型上。但它也清楚地提醒我们,这不是“用一个模型自动对齐另一个已经发布的模型”的完整演示:目标是早期检查点,任务仍然只有十类,完整生产对齐流程也不在实验范围内。

论文的限制部分因此比结果部分更值得慢读。稀有的失败可能根本没有 benchmark;开放式、难监督的研究没有这么快的反馈;有限的能力测试不能代表所有重要能力;一次短周期的后训练,也不能证明模型经过更长的强化学习和部署后仍会保持同样的行为。
换句话说,这篇研究把“自动化可以帮助对齐”从一句想象,推进成了一个有条件的工程命题。条件本身就是结论的一部分。
读完之后,我给自己留下的检查顺序变得很简单:以后看到“闭合了多少安全差距”,先问四个问题——目标是不是预先定义的?留出评测是否真的隔离?有没有独立的多轮审计?失败行为在更长时间里是否仍然消失?
如果这四个问题还没有答案,那个漂亮的百分比就只能说明“这套搜索在这把尺子上爬得很好”。至于尺子量到的是不是我们真正担心的东西,仍然是人类的作业。
你认为自动化对齐研究最难外包的部分是什么:设计评测、判断结果,还是决定哪些失败值得先被命名?