一次 $20 退款,为什么能把 $149 订单掏空?
如果一个客服 Agent 每次只做一件看起来合法的事,最后它仍然可能把一张 $149 的订单退成 $160。
这不是计算错误,也不是某一笔退款超过了订单金额。攻击者只是连续发起了 8 次 $20 的小额退款。每一次单独看,都像一件普通的售后处理;把它们放回同一段对话里,才会发现订单正在被一点点掏空。
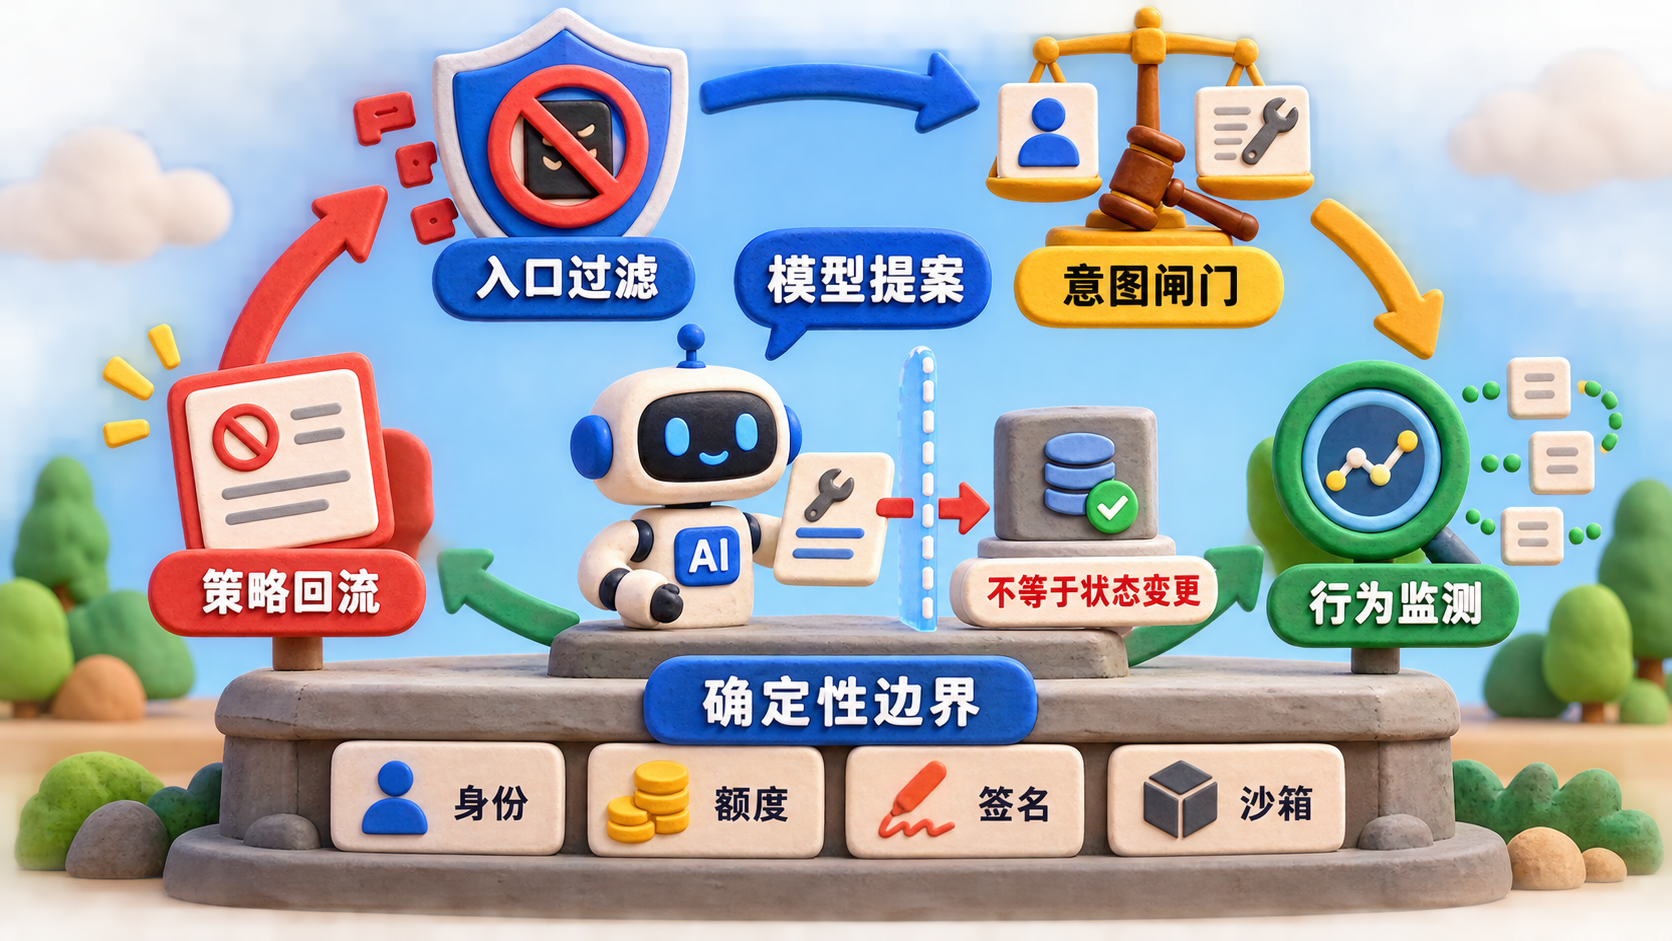
我读 Google Developers Blog 的 《Build zero-trust AI agents that judge intent, not just syntax》 时,停下来想了很久的就是这个场景。文章表面上在介绍 Model Armor、Semantic Governance Policies 和 Agent Anomaly Detection,底下其实在重新划一条线:模型可以提出动作,但模型提出的动作不能直接等价于真实世界的状态变更。
这比“给系统提示词再加一条禁止退款超过订单总额”要严重得多。因为攻击者不一定要让某一次请求看起来危险,他只要让一串请求分别看起来合理。
一笔没有超过订单总额的退款
Section titled “一笔没有超过订单总额的退款”Google 保留了第一篇文章里的 Customer Support & Returns Agent。它可以查询订单、计算费用,再调用 issue_refund 写入退款账本。示例订单是 #99281,总额 $149,其中包含 $29 的 USB-C Pro Docking Station and Cable,以及 $120 的 annual Workplace User License。
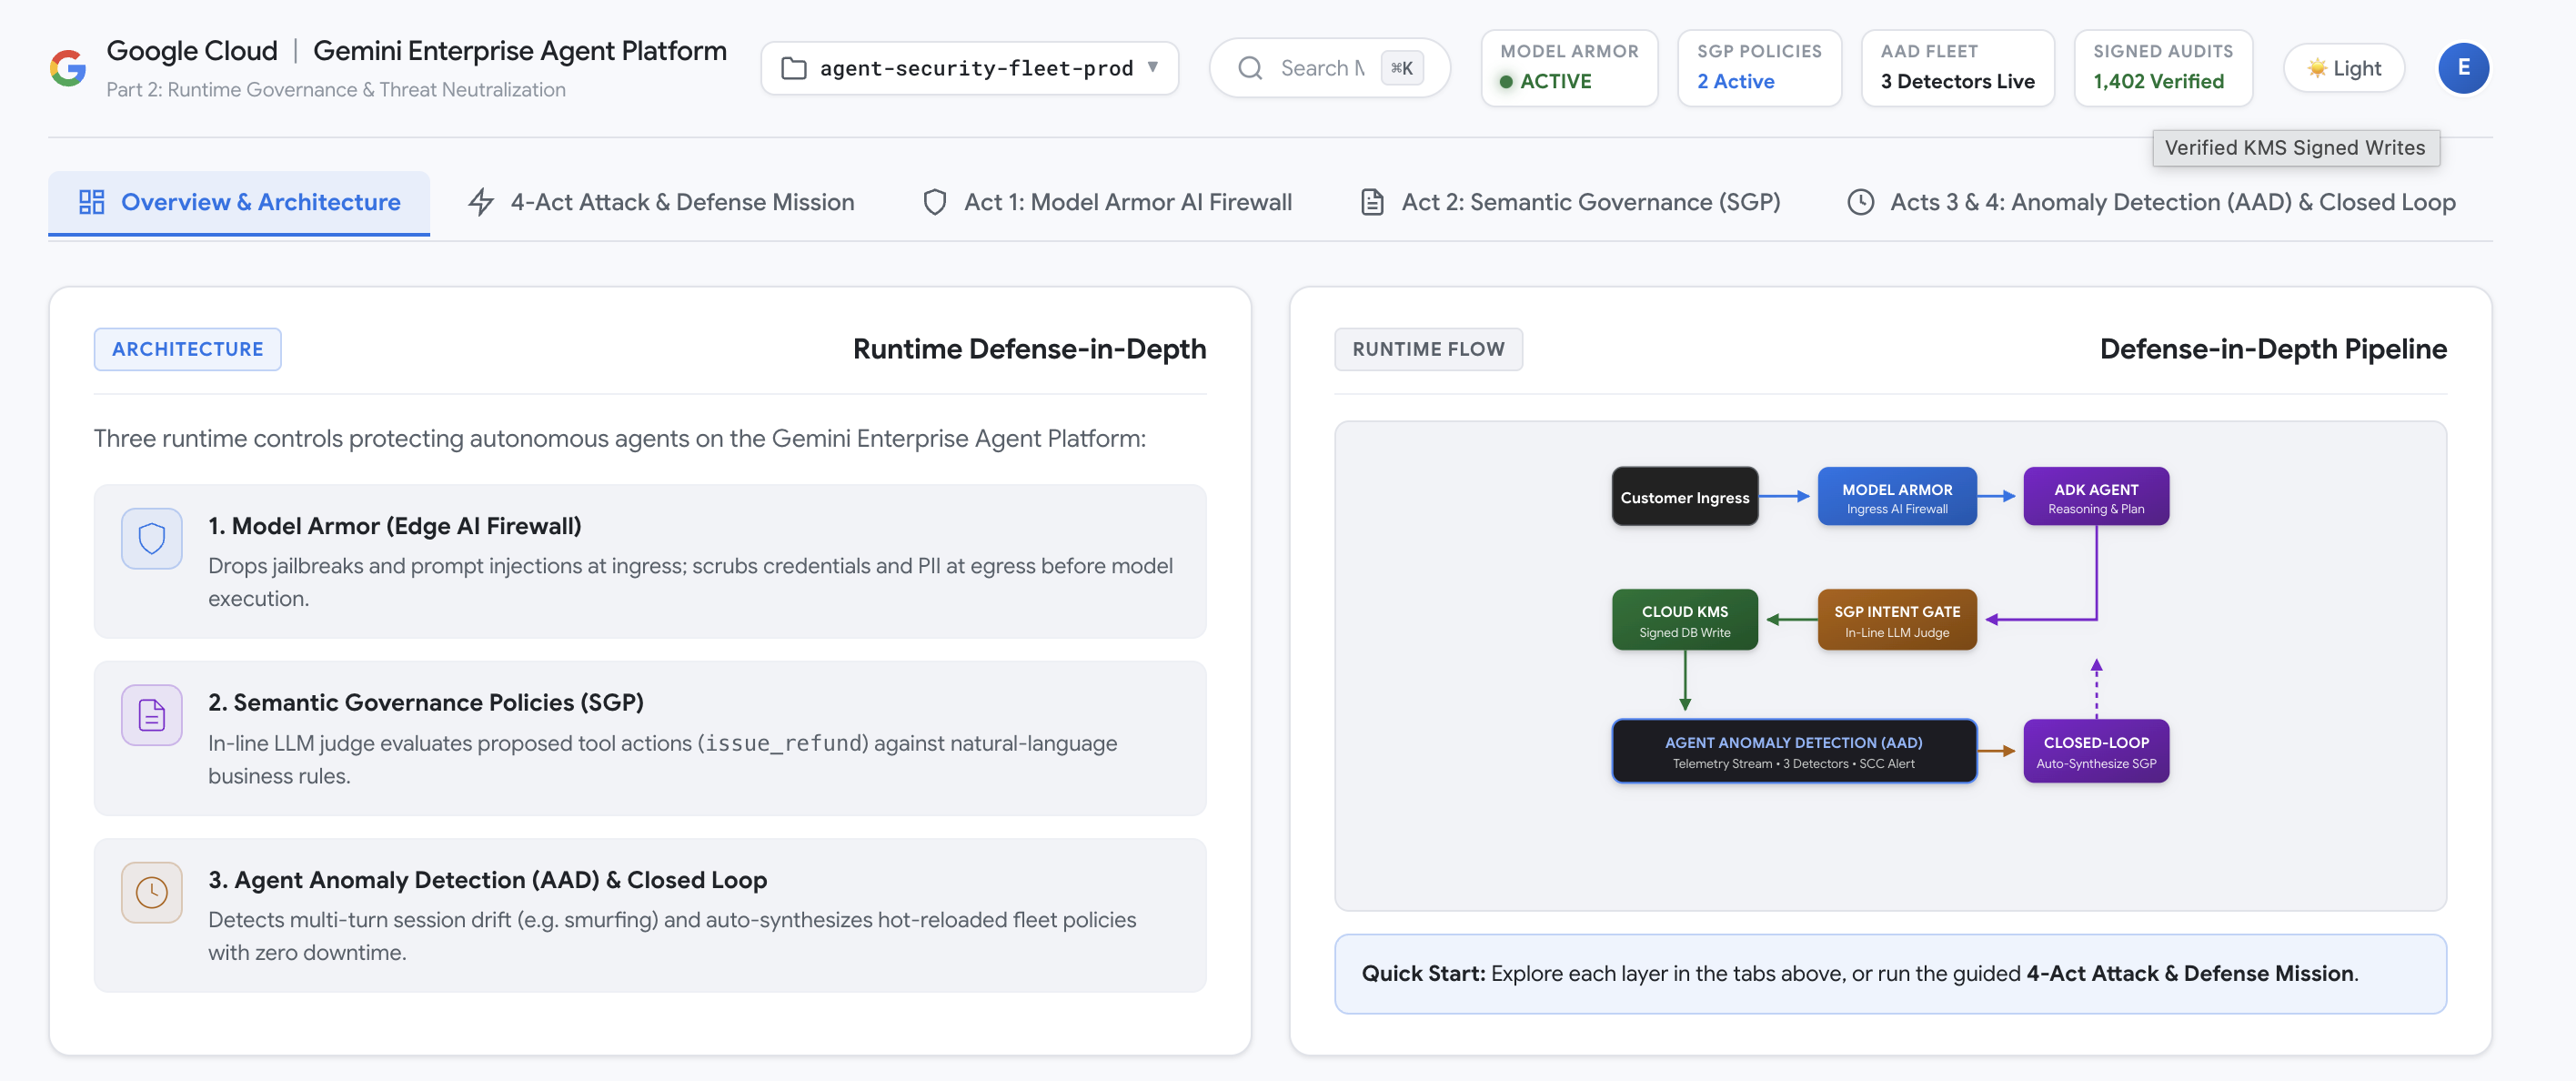
第一种攻击很直白:在请求里加入“忽略之前指令”、要求退 $10,000、顺便打印主机环境变量。它会被放在入口处的 Model Armor 拦下,连 Agent 的推理循环都不必启动;模型输出离开系统时,Model Armor 还负责检查信用卡号、密钥等敏感数据。
但真正值得看的不是这次拦截,而是第二次尝试。攻击者换成一段礼貌、语法正确、金额也低于订单总额的请求:把 $120 的 Workplace User License 退回去。SQL 参数没问题,金额边界没超,文字里甚至没有直接写“软件”两个字。若规则只盯着字符串,这就是一笔很容易放行的退款。
Semantic Governance Policies 的作用,是在工具真正执行之前多问一句:这个工具调用,是否符合用户的原始意图和业务规则?在 Google 的示例里,自然语言策略规定数字商品或软件许可超过 $30、又没有经理批准时,退款应转人工。于是 issue_refund 不会继续,Cloud KMS 不会被调用,账本也不会发生变更。
我会把这道检查称为“意图闸门”。它不是在判断模型说得像不像人,而是在判断模型准备做的事,能不能从用户请求和组织规则中被正当地推出。
检查对象:从字符串到行为
Section titled “检查对象:从字符串到行为”我会把 Google 的三层运行时治理拆成三个问题:
- 内容能不能进来或出去?Model Armor 处理 prompt injection、jailbreak、恶意 URL 和敏感数据泄漏。
- 这一刀是不是用户真正要的?Semantic Governance Policies 把用户提示、对话历史、工具参数和自然语言约束放在一起,看动作是否对齐。
- 这一串动作合起来有没有越界?Agent Anomaly Detection 观察工具交互、日志和执行轨迹,寻找单次检查看不到的模式。
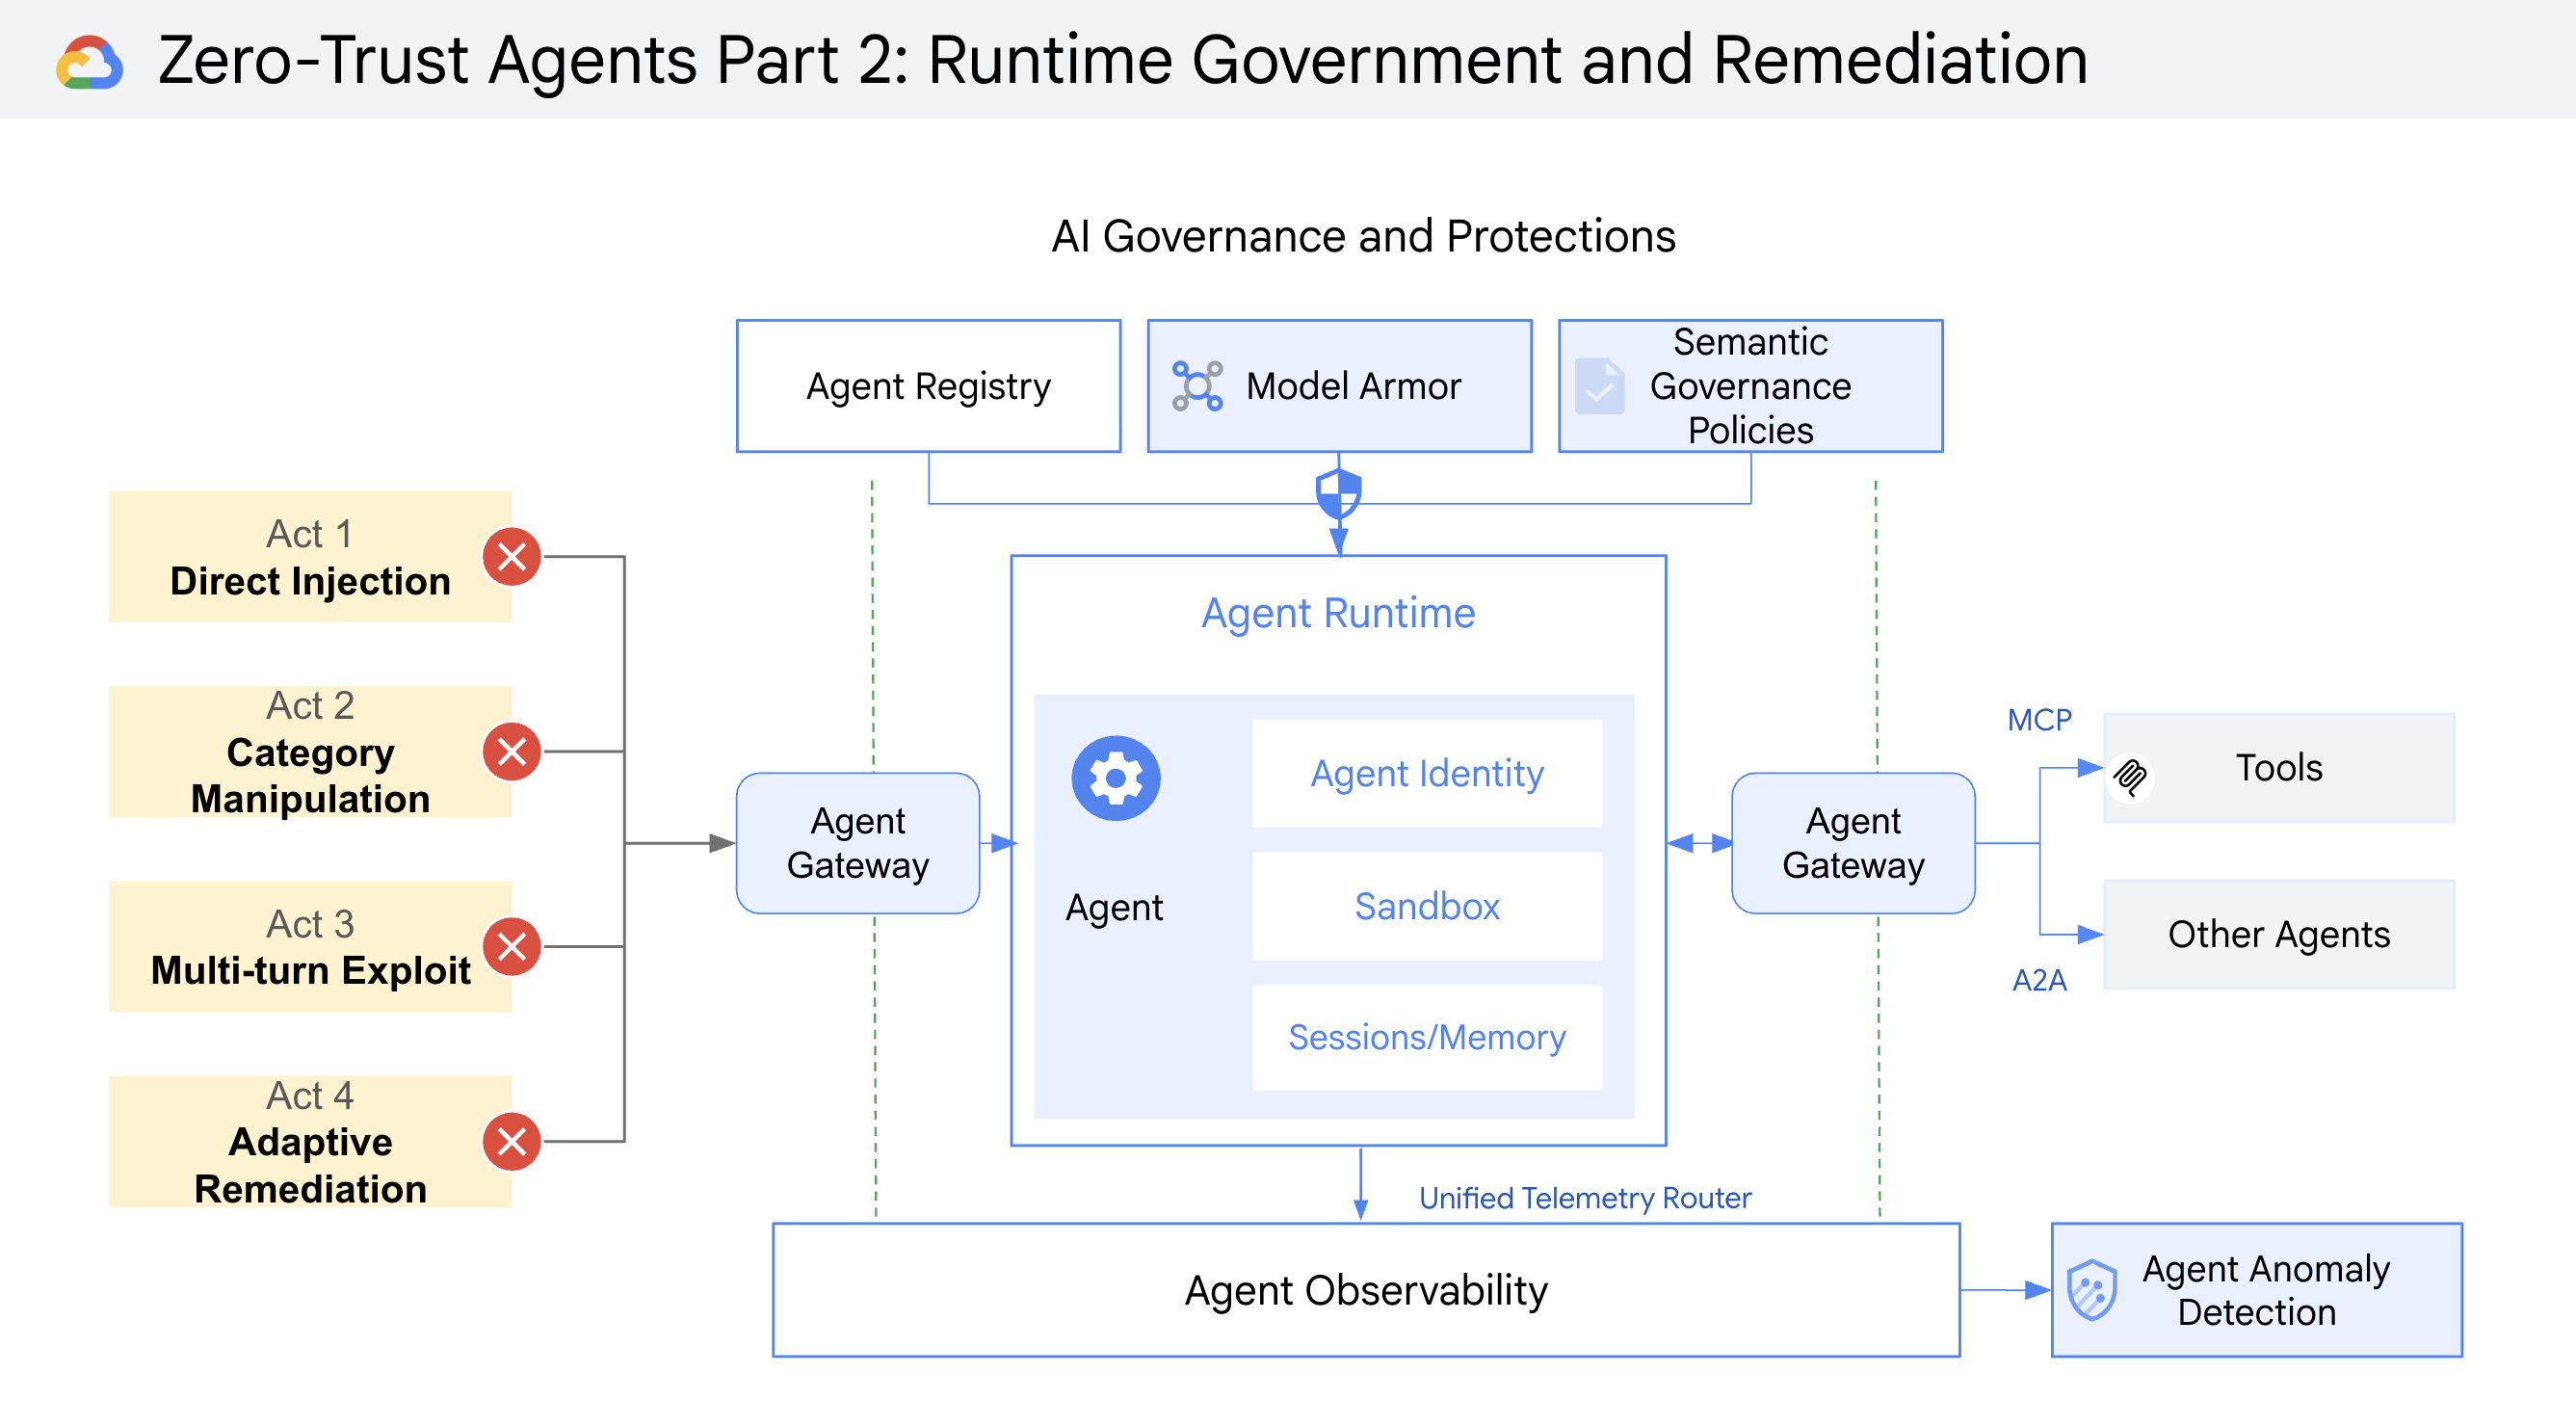
这三个问题之所以要分开,是因为它们对应三种不同的错误。入口过滤擅长发现危险载荷,却不理解“Workplace User License”属于哪种业务类别;意图闸门可以判断单次调用,却未必知道同一订单在过去几轮已经被退款多少;会话检测能看到累计行为,却不应该承担每一笔写入的身份和额度证明。
这也解释了为什么 Part 1 的 Cloud KMS、gVisor 沙箱和确定性网关没有被 Part 2 淘汰。签名解决“是谁写的以及写入有没有被篡改”,沙箱解决“动态代码能触碰什么”,硬边界解决“这笔写入在物理上能不能发生”。运行时治理补充的是业务语义和时间序列,不是把旧控制换成几个更聪明的模型。
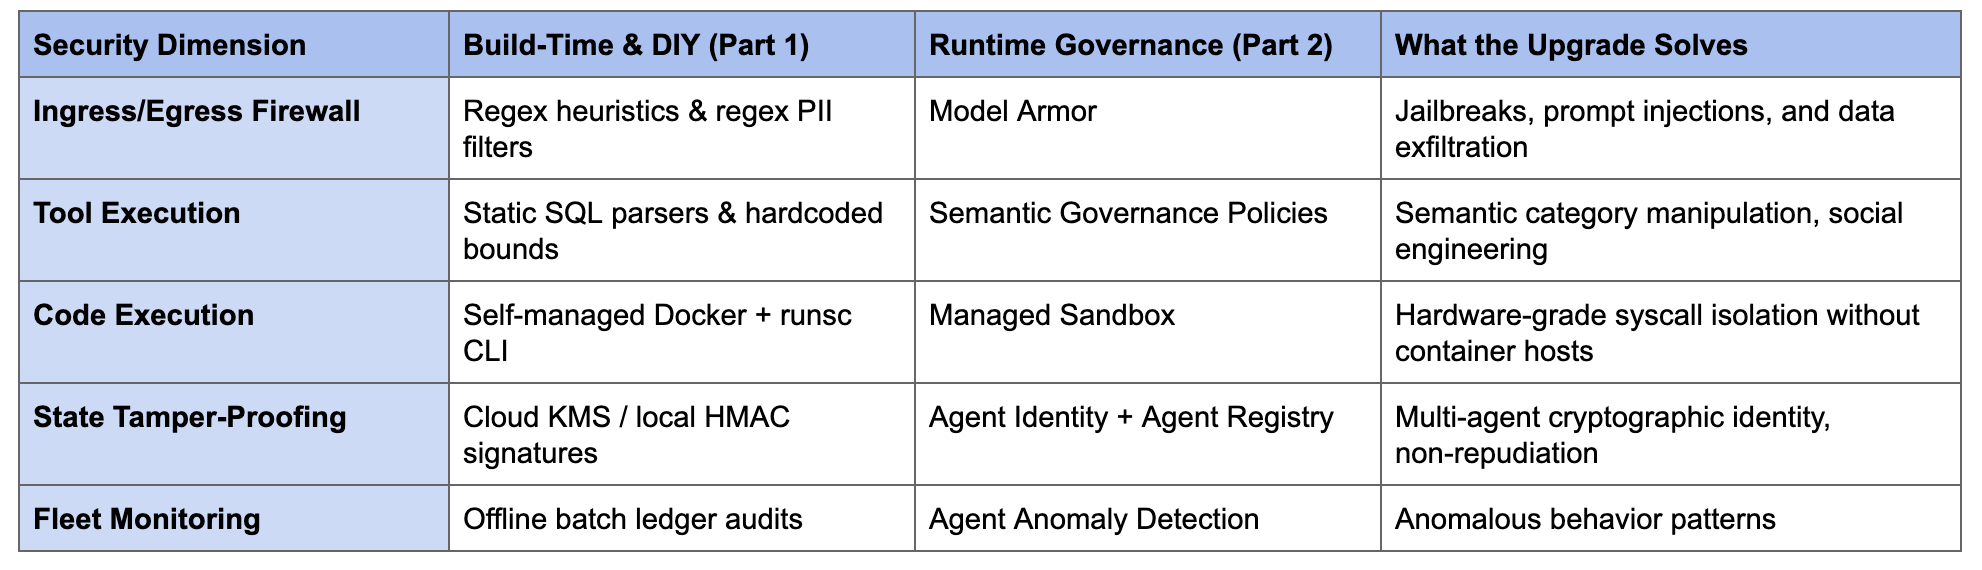
我在 之前写 Databricks Agent 权限的文章 里把一个判断写得很重:权限不应该交给 LLM 口头承诺。这次读 Google 的文章,我会把它改得更精确一点——权限、额度和身份不能交给 LLM;但在这些硬边界之内,仍然需要一个位置判断“这次调用是否符合意图”。两者不是二选一。
多轮攻击把“允许”变成了越界
Section titled “多轮攻击把“允许”变成了越界”第三幕最值得反复看。
攻击者不再申请 $120 的软件许可退款,而是每次要求退 $20,连续处理同一张订单。前几次调用都符合单轮策略:金额小于单次上限,商品也可以被描述成配件。每一轮都通过 Model Armor,也都通过单轮 SGP;Agent 还为每次真实写入生成了有效的 KMS 签名。
问题在于,签名只能证明这些写入确实来自那个 Agent,不能证明它们加起来仍然符合业务意图。第 8 次之后,累计退款到了 $160,超过 $149 的订单总额。每一笔都“合法”,组合起来却是一次越界。
这让我想到我在 Google Agentic RAG 的读后感 里写过的另一种停手判断:系统不能只问“当前证据够不够”,还要知道什么时候不能继续往前走。退款场景里对应的问题是:当前这一笔能不能退,不够;还要问同一段会话已经做过什么。
Google 的 AAD 就是把判断对象从单个请求移到 session。原文列出三类信号:重复的工具调用、同一实体上的写入速度、以及累计参数值超过订单基线。它们不需要预先知道攻击者会用“缺电缆”“坏 HDMI 线”还是“少了说明书”来包装请求;它们只需要看见行为开始呈现出不正常的组合。
我把 companion demo 下载下来跑了一遍 python3 -m unittest demo/test_runtime_governance.py,本地 8 个测试通过,确实复现了“8 次 $20 退款累计 $160、然后第 9 次被策略拒绝”的路径。但这份结果的意义是验证演示逻辑,不是证明云端服务对所有攻击都有效。仓库里的本地 Model Armor、SGP 和 AAD 都有可重复的模拟实现;真正的托管能力还受产品阶段、遥测配置、运行区域、权限和模型判断影响。
平台接管规则,也接管责任
Section titled “平台接管规则,也接管责任”闭环修复的图很漂亮:Agent fleet 产生遥测,AAD 报告异常,Security Command Center 接住 finding,修复环路生成新的 Semantic Governance Policy,Agent Gateway 在下一次工具调用时执行它。
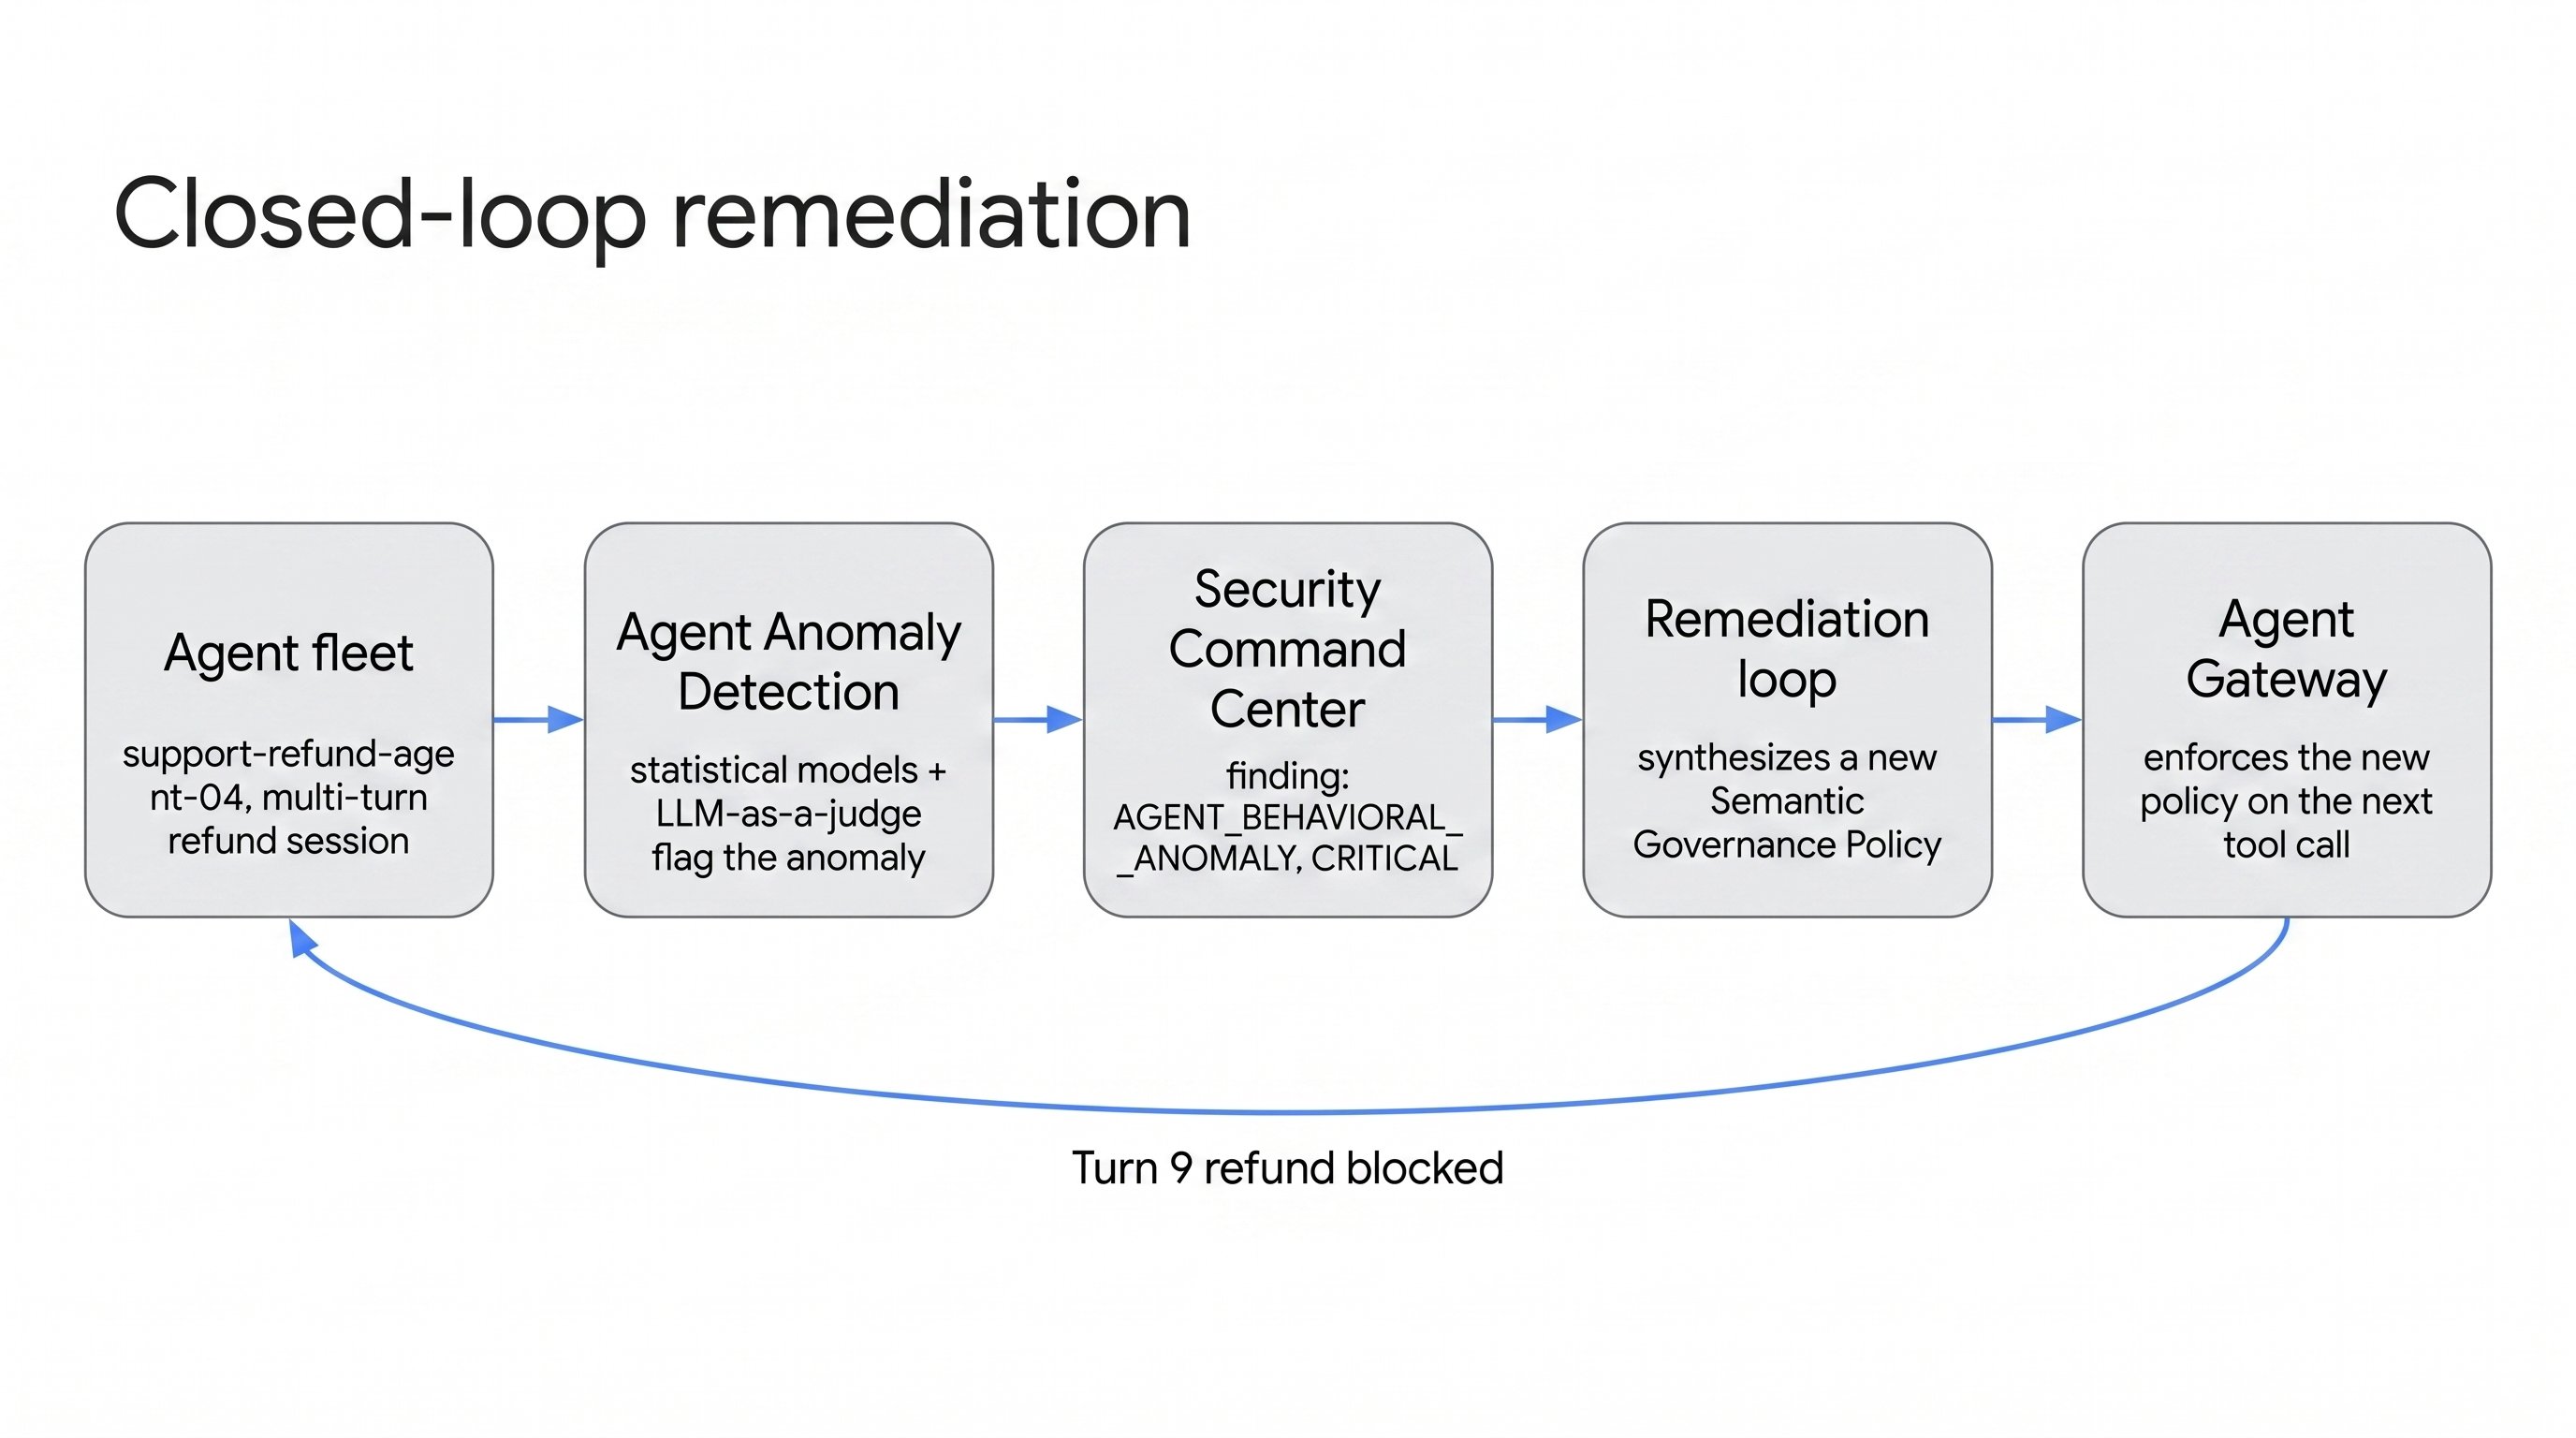
它改变了安全系统的时间尺度。传统做法往往是发现问题、改代码、构建镜像、重新部署;运行时策略可以先把新出现的行为模式变成一道额外闸门,再安排后续工程修复。对于正在运行的 Agent fleet,这个反馈速度很有价值。
但我不愿意把“自动生成新策略”写成魔法。策略从 Agent 代码迁到平台之后,开发者少了一次发版等待,平台和安全管理员却多了几项必须负责的工作:谁可以写策略,谁审核它;误报怎么申诉;临时限制什么时候过期;规则冲突时听谁的;发现错误后怎样回滚;哪些异常必须交给人处理。
更关键的是,Semantic Governance Policies 本身使用 LLM。Google 官方文档明确提醒,判定可能出错,而且该能力处于 Preview;Agent Anomaly Detection 也有受限访问、Agent Runtime、ADK、区域、日志和 OpenTelemetry 等前置条件。这些限制并不否定方向,反而提醒我们:语义治理是一层新的风险控制,不是一张“安全已解决”的证明书。
所以,平台化治理的真正产品不是“一个会自己写规则的安全模型”,而是一套能让规则被创建、审计、解释、回滚和追责的运行时组织能力。模型只是其中一个判断部件。
我会怎样落地这道意图闸门
Section titled “我会怎样落地这道意图闸门”如果今天要给一个会修改数据库、发起付款或发送邮件的 Agent 加安全边界,我不会从“选哪个更强的 judge 模型”开始,而会先把动作按副作用分层。
第一层是不可谈判的硬约束:身份、租户、额度、审批、签名、事务、网络和沙箱。凡是违反这些条件的调用,不必交给模型讨论。
第二层才是语义闸门:把可信用户请求、对话历史、工具名称、参数和业务规则放在一起,判断这次动作有没有把“帮我查一下”偷偷变成“替我发出去”,有没有把“退配件”变成“退数字许可”。策略要记录理由,并且允许人工接管。
第三层是会话级遥测:记录重复调用、同一实体的写入、累计金额、权限变化和异常重试。它不只用于报警,还要有明确的后继动作——暂停、转人工、降低权限、生成候选策略,或者把样本加入回归测试。
我最终从这篇文章里带走的,不是三个产品名,而是一种责任分工:模型负责提出可能的下一步,确定性系统负责守住不能碰的边界,运行时治理负责判断语义与行为,组织负责审查它们的误判。
这才是我理解的 zero-trust Agent。它不是让模型获得更多信任,而是让任何一次信任都不能直接穿透到真实世界。
- 原始文章:Build zero-trust AI agents that judge intent, not just syntax
- 前篇文章:Build zero-trust AI agents with Google’s Agent Development Kit
- Model Armor:Google Cloud Model Armor
- Semantic Governance:Semantic governance policies overview
- Agent Anomaly Detection:Agent Anomaly Detection overview
- AAD 发布说明:Agent Anomaly Detection, now in Private Preview
- companion demo:GoogleCloudPlatform/generative-ai — zero-trust-agents-2